
GPO:深入逻辑命门,通过“关键步骤”识别重塑 LLM 的推理深度
GPO: Learning from Critical Steps to Improve LLM Reasoning
本文提出了 Guided Pivotal Optimization (GPO),这是一种针对大语言模型(LLM)多步推理能力的微调策略。GPO 通过估算 Advantage Function 来识别推理轨迹中的“关键步骤”(Critical Step),并从该点重置策略进行新采样,显著提升了模型在 GSM8K、MATH 等 7 个挑战性基准上的 SOTA 性能。
TL;DR
在 LLM 的多步推理训练中,传统的 PPO 或 DPO 往往“眉毛胡子一把抓”,给整个答案路径一个整体分数。本文提出的 Guided Pivotal Optimization (GPO) 另辟蹊径:它能像手术刀一样精准切入推理轨迹,识别出决定成败的关键步骤(Critical Steps)。通过在这些关键点进行针对性的重置采样与优化,GPO 在 MATH、AIME 等高难度任务上实现了显著的性能跨越,证明了对“关键少数”的关注才是提升模型智力的钥匙。
1. 痛点:被掩盖的“逻辑致命伤”
当前的推理模型训练(如 DeepSeek-R1, OpenAI o1 方向)面临一个核心挑战:信用分配(Credit Assignment)。 当模型给出一个错误答案时,是第一步就想错了,还是在最后一步计算失误?传统的 RLHF 方法通常对整条路径打分,这会导致:
- 学习效率低下:模型不知道该改进哪一句话。
- 逻辑漂移:正确的中间步骤可能因为最终的错误答案而被误罚。
- 探索盲目性:模型只是在随机尝试,而不是在逻辑断点处寻求突破。
2. 核心直觉:Advantage Function 的语义化应用
作者的直觉非常精妙:利用强化学习中的 Advantage Function(优势函数) 来衡量每一步的“战略价值”。
- 定义:如果从某一步开始,模型通过重新尝试有极大概率从“失败”转为“成功”,那么这一步就是 Critical Step。
- 实现:GPO 使用 Monte Carlo (MC) 模拟。对每个中间步骤采样多个后续路径,通过对比不同步骤后的成功率变化,计算出它们的 Advantage。
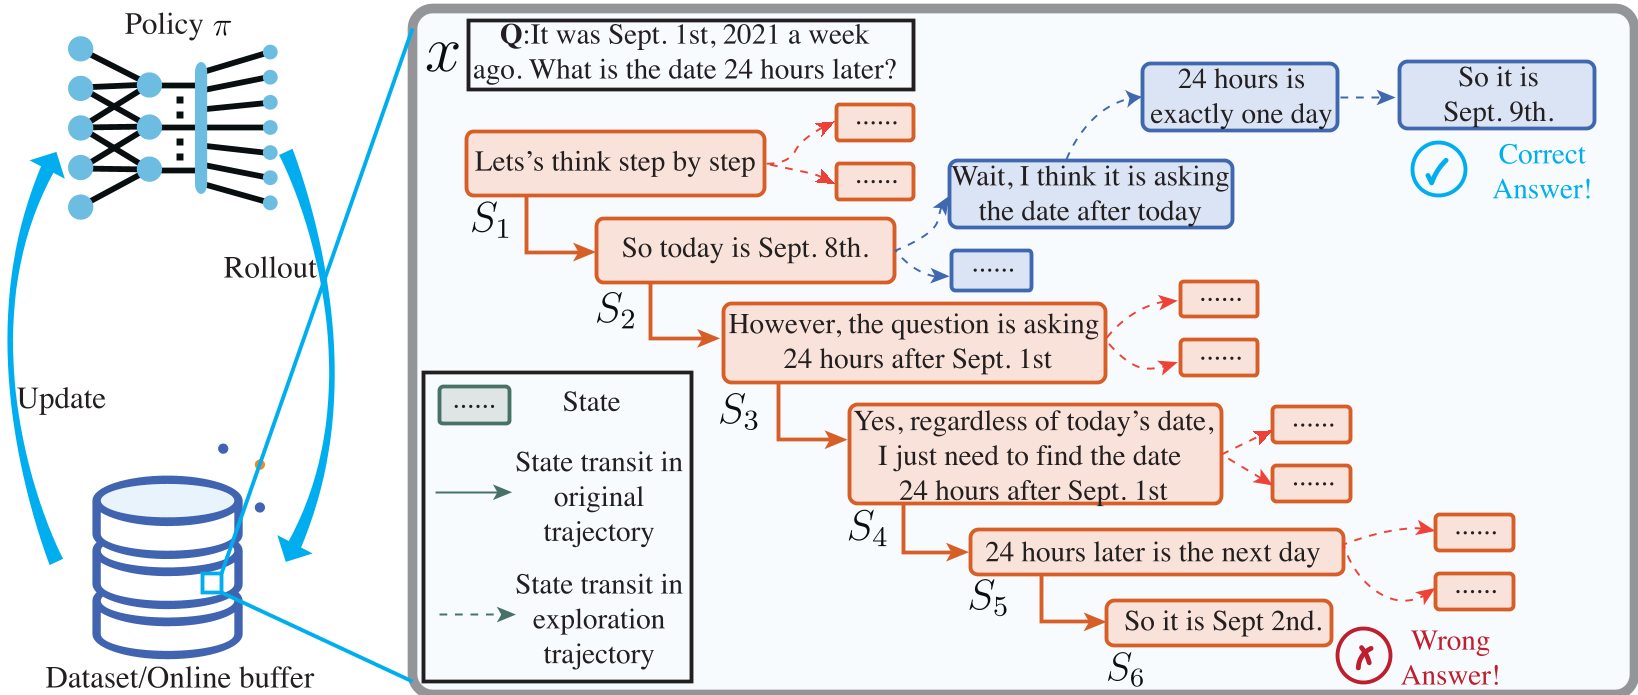 图 1:GPO 流程图。先生成完整轨迹,再通过优势函数定位关键点(红色 S2),最后从 S2 重置生成新路径。
3. 算法流程:Procedure-I & II
GPO 是一个通用的微调增强插件,它可以适配两种主流范式:
- 在线模式(PPO-style):在训练循环中实时进行 MC 采样,找到关键步后在线更新 Policy。
- 离线模式(DPO-style):在数据准备阶段,识别关键步并生成偏好对(由关键步引出的正确路径 vs 原有错误路径),随后进行偏好优化。
4. 实验战绩:全线飘红
GPO 的强大之处在于其通用性(Generalizability)。研究团队将 GPO 应用于 PPO、DPO、KTO、SimPO 和 ORPO 五种算法,在 7 个数据集上进行了测试。
| 算法基准 | MATH (Accuracy) | GSM8K (Accuracy) | MMLUPro |
|---|---|---|---|
| PPO (Base) | 79.60% | 86.96% | 47.47% |
| GPO-PPO | 87.80% (+8.2%) | 87.44% | 51.05% |
| DPO (Base) | 82.40% | 86.05% | 48.28% |
| GPO-DPO | 86.80% (+4.4%) | 88.48% | 51.93% |
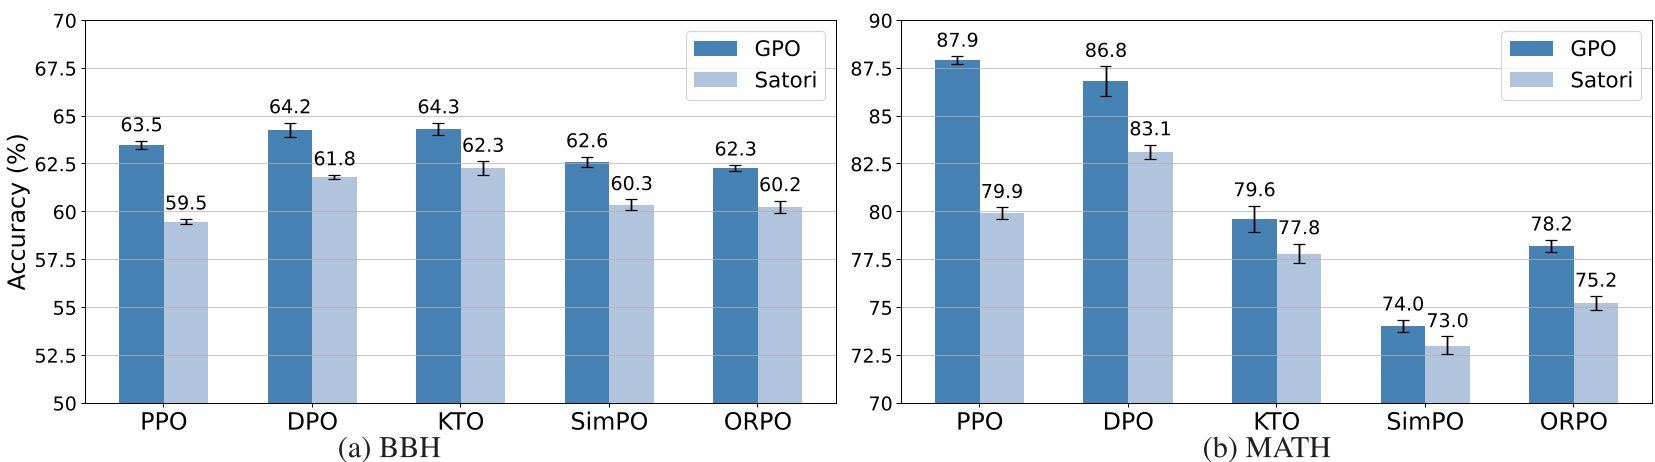 图 2:消融实验显示,相比于随机重置(Satori 策略),GPO 基于 Advantage 的精准识别带来了更陡峭的性能提升曲线。
5. 关键洞察:它是如何“Scale”的?
文章探讨了两个重要的扩展性问题:
- MC 采样数:实验发现,每个步骤进行 4-12 次模拟是性价比最高的。超过 12 次后,收益趋于饱和(见图 3 左)。
- 模型规模:GPO 并非小模型的特权。从 1.5B 的 Qwen 到 70B 的 Llama,GPO 带来的提升一直非常稳健(见图 3 右)。
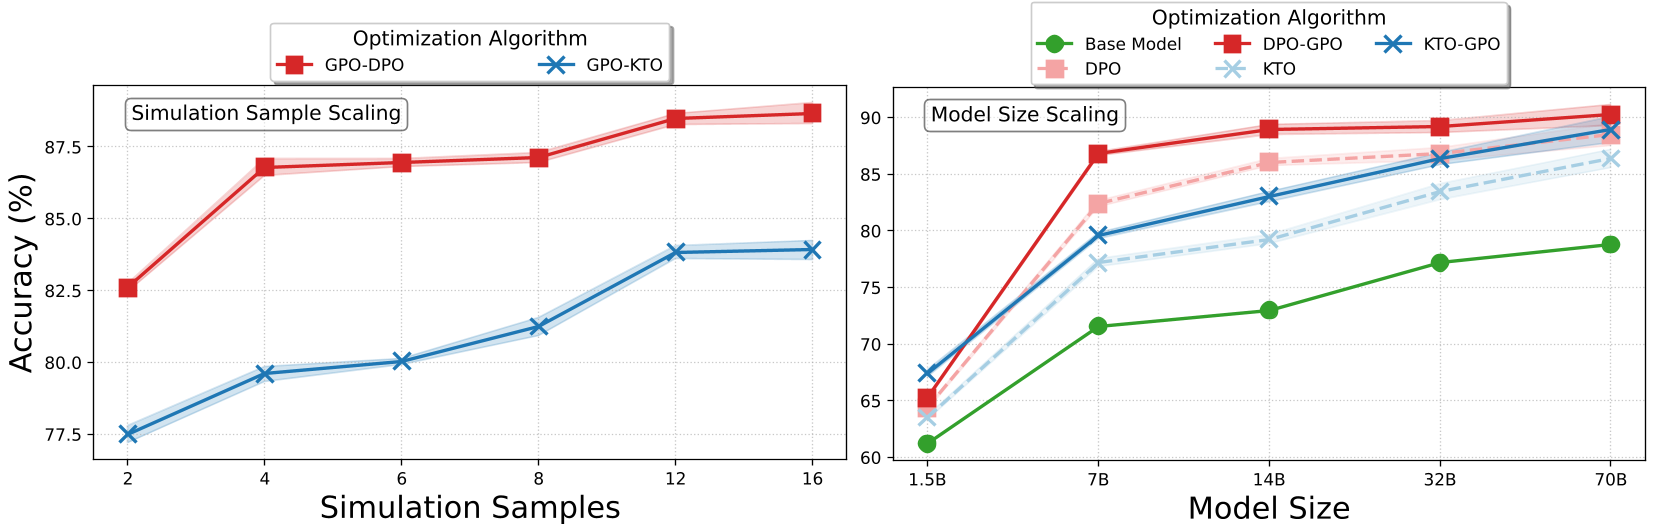 图 3:GPO 对模拟次数和模型规模的扩展性表现。
6. 局限性与思考
尽管表现惊艳,GPO 仍有其“贵”的一面:
- 计算开销:由于需要对每个步骤进行多次 MC 采样,训练时间约为普通流程的 1.8-1.9 倍。
- 长文本挑战:对于超长推理链(R1 风格),逐步计算 Advantage 成本极高。作者建议采用“Step Grouping”(步分组)策略来平衡。
总结
GPO 揭示了一个朴素的真理:在学习复杂的数学或逻辑证明时,反复练习那些“容易跌倒”的关键转折点,比一遍遍抄写整道题的答案要有效得多。这种引导式关键点优化为构建更智能、更具自省能力的推理 LLM 提供了一条清晰的路径。