
TIGER:打破全同态加密 LLM 推理的精度与性能藩篱,非线性层实现最高 17 倍 GPU 加速
GPU Acceleration of TFHE-Based High-Precision Nonlinear Layers for Encrypted LLM Inference
本文提出了 TIGER 框架,这是世界上首个基于 GPU 加速的、面向大语言模型(LLM)加密推理中高精度 TFHE 非线性层评估的方案。通过将 GPU 强化的 WoP-PBS 机制与数值计算算法相结合,成功突破了原生存找表精度限制,在保证高度安全性的同时取得了优异的 SOTA 加速性能。
TL;DR
在云端部署大语言模型(LLM)服务给敏感的用户数据隐私带来了前所未有的泄露风险。尽管全同态加密(Fully Homomorphic Encryption, FHE)能够实现“密文计算、不泄露明文”的理想愿景,但在高精度非线性函数(如 Softmax、LayerNorm 和 GELU 激活函数)的计算上,现有的同态加密方案往往陷入“高延迟”或“精度崩溃”的两难境地。
本文介绍的 TIGER,是世界上首个针对基于 TFHE 体系架构中高精度非线性 LLM 层处理的 GPU 加速计算框架。该研究通过密码学硬件极致优化、查找表(LUT)外加数值演算法(精度精细化补偿)的深度协同,完美突破了传统查找表在同态自举中的噪声和精度极限。相较于优化后的 CPU 并行基线,TIGER 在核心非线性层评估中斩获了最高 17.05× 的绝对速度跃升,为全密文 LLM 推理落地开辟了一条崭新的道路。
痛点深挖:线性层可量化,非线性层却是“精度死穴”
在现代大模型压缩策略中,我们甚至能将模型的权重和激活值激进地量化到 FP4 或 NF4(如 SmoothQuant 等技术),且模型性能几乎不怎么衰减。但这往往让研究者产生一种错觉:LLM 的所有组件在面对低精度时都很鲁棒。
事实上,非线性层(Softmax、LayerNorm、GELU)有着强烈的数值敏感性。作者在 GPT-2 上做了一项精确的精度消融剥离实验(如表 1 所示):

可以看出,如果将所有线性层以普通低精度格式表征,困惑度(Perplexity, PPL)仅出现微弱上升;但一旦把非线性层全盲目降到 4-bit,其模型的 PPL 将会发生几十到几百倍的爆炸性崩塌(从 24.36 直接飙升至 6322.33)。
在现有的同态加密流派中:
- CKKS 方案:虽然天生适配线性矩阵乘法,但处理这些敏感的非线性算子时需要依赖上百阶的高阶多项式逼近。精度要求越高,多项式项数越多,导致的密文自举(Bootstrapping)频率、乘法深度和密钥尺寸就会呈灾难性增长。
- TFHE 方案:能够利用可编程自举(Programmable Bootstrapping, PBS)在密文状态下精确评估查找表(LUT),从根本上绕开了多项式逼近。然而,现有的高级查找表技术(包括 WoP-PBS、FBT-TFHE)由于受到密文字符噪声增长级数限制,有效输入精度通常卡死在 20-bit 以内,同时因各子阶段在 GPU 上的控制逻辑过于碎裂,无法有效榨干现代硬件的超高算力。
核心原理解析:TIGER 是如何炼成的?
TIGER 提出了一个由粗到精、软硬件交融的“三层阶梯式架构”,将高层神经网络语义逐步下放至底层的密码学原语:
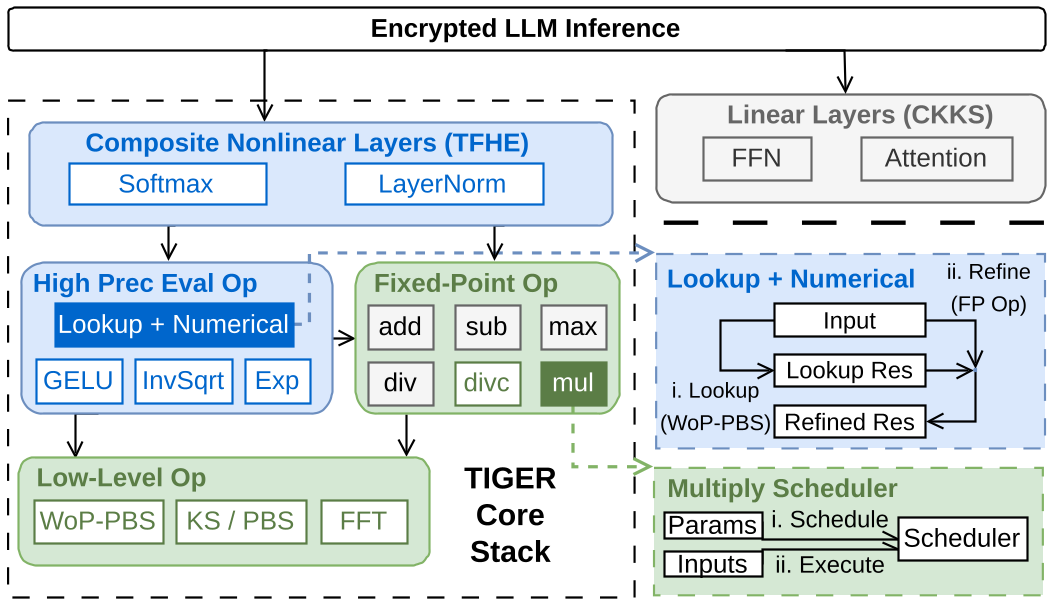
1. 突破极限的 LUT 与 数值算法协同方案 (Lookup-plus-Refinement)
传统的 TFHE 查找表往往因为“输入比特宽一分,噪声与存储爆十倍”而止步不前。TIGER 给出的破局 Insight 是:不要尝试在一个 LUT 中完成所有精度的映射,而是利用有限精度的查找表获得一个“底噪初始近似值”,剩下的残差精度由一阶泰勒展开通过基本定点算子原语来做二次补偿补偿。
以 LLM 最常用的三个函数为例:
- 算子:输入数值被拆分成高、中、低三个不重叠的比特分块。中段(20比特)直接投喂进高并发的 WoP-PBS 查找表中拿到底层基座输出。低段则利用一阶泰勒展开大刀阔斧地近似为 ,最后在密文空间中进行简单的乘加融合修正。
- 激活:当输入 时,将其拆解为查找值 (20-bit) 和残差 (4-bit)。根据导数和泰勒近似: 其中 。TIGER 巧妙之处在于仅通过单次 LUT 自举就同步取得了 和 ,随后配合定点乘加算子将其精度拉满。
- (即 ):采用了分段查找区间管理,结合硬件量身打造了逼近区间。
2. 硬件感知型自举并行优化:乘法调度器与 Split-Batch 策略
即便算法架构设计完成,若缺少对 GPU 微架构的感知,大量的密文计算依然会撞上内存墙。作者通过对底层自举内核进行 ncu 深度性能剖析捕获了非单调性演进规律:盲目增大 Batch Size 固然能堆高并发扭曲率(Active Warps),但是当 Batch size 超过 320 后,密文海量的中间状态和密钥权重就会彻底挤爆 GPU 的 L2 缓存,导致高昂的 DRAM 回访延迟。
为此,团队设计了两项硬件杀手锏:
- 智能乘法调度器 (Multiply Scheduler):离线阶段对高精度定点数乘法的列求和及进位传播进行静态剪枝,剔除完全不贡献目标精度范围的无关偏置乘积块,并将多路并行的规约流打包,大大缩减了复杂的自举触发。
- 分批裁剪策略 (Split-Batch Strategy):任何高层复杂的张量操作在调用底层自举时,TIGER 的运行时引擎都会自动将任务严格切分为最完美适配 GPU 存储结构的子批次区间(固定在
[192, 320]内),完美在线程饱和度(Occupancy)与缓存驻留率之间找到了甜点。
实验战绩与消融剖析
研究团队基于大规模 CUDA C++ 对 TIGER 完成了软硬件系统闭环,在 NVIDIA RTX 6000 Ada 环境下同传统的基于 CPU 16 线程大整数同态算术架构和 GPU 树状自举架构(GPU-FBT)进行了全面比拼。
核心算子吞吐横向对比
如图 5 所示,TIGER 针对各种复杂非线性层展示出了横扫全场的低延迟表现。
- 在 GELU 激活层 相比 CPU 基线的开销,其速度直接提升了 7.17 倍。
- 在更偏重多路全局规约与定点除法操作的 Softmax 与 LayerNorm 层中,GPU 输入间并行性的红利得到更淋漓尽致的释放,斩获了 16.68 倍 和 17.05 倍 的加速。
端到端 GPT-2 变压器块评估
为了体现该工作的实战产业价值,作者模拟并拼接构建了一个包含完整 CKKS 线性层和协议级双向密文格式转换(CKKS TFHE)的端到端 GPT-2 Transformer Block。其耗时分布如下表所示:
| 阶段组件 (GPT-2 Block) | TIGER 执行时间 | CPU 优化基线 | 性能加速比 |
|---|---|---|---|
| 线性层(CKKS 矩阵乘法) | 0.29 s | 26.21 s | — |
| 格式转换 ( CKKS TFHE) | 0.20 s | 8.95 s | — |
| 格式转换 ( TFHE CKKS) | 14.60 s | 148.77 s | — |
| 非线性计算层 (TFHE) | 970.58 s | 15137.68 s | 15.60× |
| 整体汇总开销 (Total Block) | 985.66 s | 15321.62 s | 15.54× |
从上表我们可以清晰地看出两点重要信息:首先,在 FHE 隐私大模型全链路中,非线性处理时间占据了惊人的 98.5%,这证明了 TIGER 对该痛点的捕捉是极其精准的;其次,TIGER 成功将这个原本需要 4.25 小时的天量运算模块,生生压缩至 16.4 分钟,使端到端整体效能跃升 15.54×。
消融深度拆解回顾
究竟是系统中的哪一项模块起到了居功至伟的加速效果?作者对其子模块设计了高度密集的剥离测试(图 6):
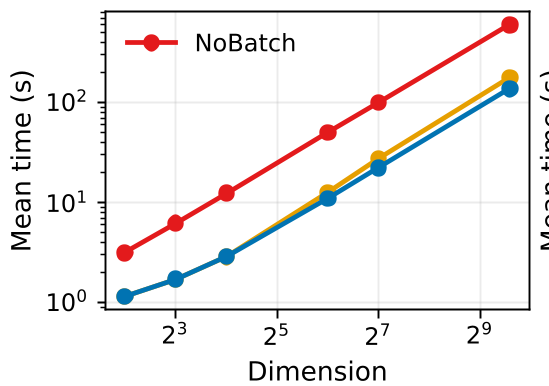
- **分批裁剪策略(Split)**贡献了最大份的确定性红利,让全系统开销直降 25-30%,力证了硬件感知中避免换页区抖动对于同态大密钥传输的不可或缺性。
- 针对信号转换和蝶形变换量身定制的基数-4 FFT 算法(Radix-4)合并了繁琐的同步过程,与针对复杂大复数乘积的 Karatsuba 乘积优化 分别也贡献了 5-10% 的耗时削减。
总结与未来启示
作为全网首创的高精度、GPU 全加速大模型 FHE 非线性推理底座,TIGER 的学术与工程贡献无疑是里程碑式的。它深刻地告诉我们:面对密码学这一天然存在超高计算和跨层存储墙的领域,单纯的改进硬件硬件加速或是单纯的钻研算法公式,都只能得到局部的次优解。只有将上层的数学逼近残差理论、中层的分批批次控制链以及底层的电路多项式算术级 FFT 有机缝合,才能逼近硬件的极限潜能。
局限性与未来展望
- 自动化批次索检:当前 TIGER 最优的缓存执行批次(
[192, 320])需要专家团队通过离线 Profiling 前置标定。在后续研究中,引入基于二分搜索或在线启发式反馈的动态调整框架,将进一步扩展该技术在不同处理器硬件(如新型 H100/B200 芯片)上的即插即用泛化性(Portability)。 - 跨机多 GPU 协同扩展:既然 TIGER 将非线性算子绝大部分转为了“高独立性、元素级独立(Element-wise)”的纯密文输入间并行格局,这也隐式昭示着未来通过简单的跨卡张量切分(Tensor Parallelism),能够在多节点集群中使 FHE 大脑的响应耗时进一步向秒级实时逼近。