
GRAPE:让 GRPO 监督查询重定向,解决 CLIP 检索的“水土不服”
GRAPE: Let GPRO Supervise Query Rewriting by Ranking for Retrieval
本文提出了 GRAPE,一种基于 GRPO (Grouped Relative Policy Optimization) 的即插即用型检索增强框架。该方法通过微调 LLM 进行查询重写(Query Rewriting),在不重新训练检索器或重新嵌入索引的情况下,显著提升了 CLIP 模型在多语言、长文本及多模态任务下的 SOTA 成就。
TL;DR
在工业级检索系统中,想要升级检索模型往往意味着要对百亿规模的向量数据库进行重新计算(Re-embedding),成本极高。论文 GRAPE 提出了一种“曲线救国”的方案:检索器不动,通过 GRPO 算法微调一个轻量级 LLM 重写器。结果显示,在不改动 CLIP 任何参数的情况下,多语言和长文本检索精度平均提升了 4.9% (R@10)。
背景定位:检索器的“分布偏差”痛点
尽管 CLIP 已经成为视觉-语言检索的基石,但由于其预训练数据多为英文、短语,当它遇到:
- 多语言查询:非英语母语的表达。
- 长文本描述:复杂且冗长的 Wikipedia 描述。
- 多模态组合:根据“图片+文字修改意见”寻找新图片。
此时,检索器的性能会发生断崖式下跌。直接重训练代价太大,而普通的 LLM 重写(Zero-shot)由于不了解检索器的“脾气”(Latent Space),效果往往差强人意。
核心 Insight:为什么排名比得分更重要?
作者在研究中发现了一个非常深刻的现象:得分通胀 (Score Inflation)。
如果我们将 LLM 生成的重写内容与目标图片的“相似度得分”直接作为奖励,LLM 会学会作弊。它会生成像“real-world environment”或“atmosphere”这种极其通用的万金油词汇。这些词虽然确实提升了相似度,但却让查询变得平庸,导致它在数据库里和所有图片的距离都拉近了,反而失去了区分度。
GRAPE 的对策:不看绝对得分,看 Ranking(排名)。
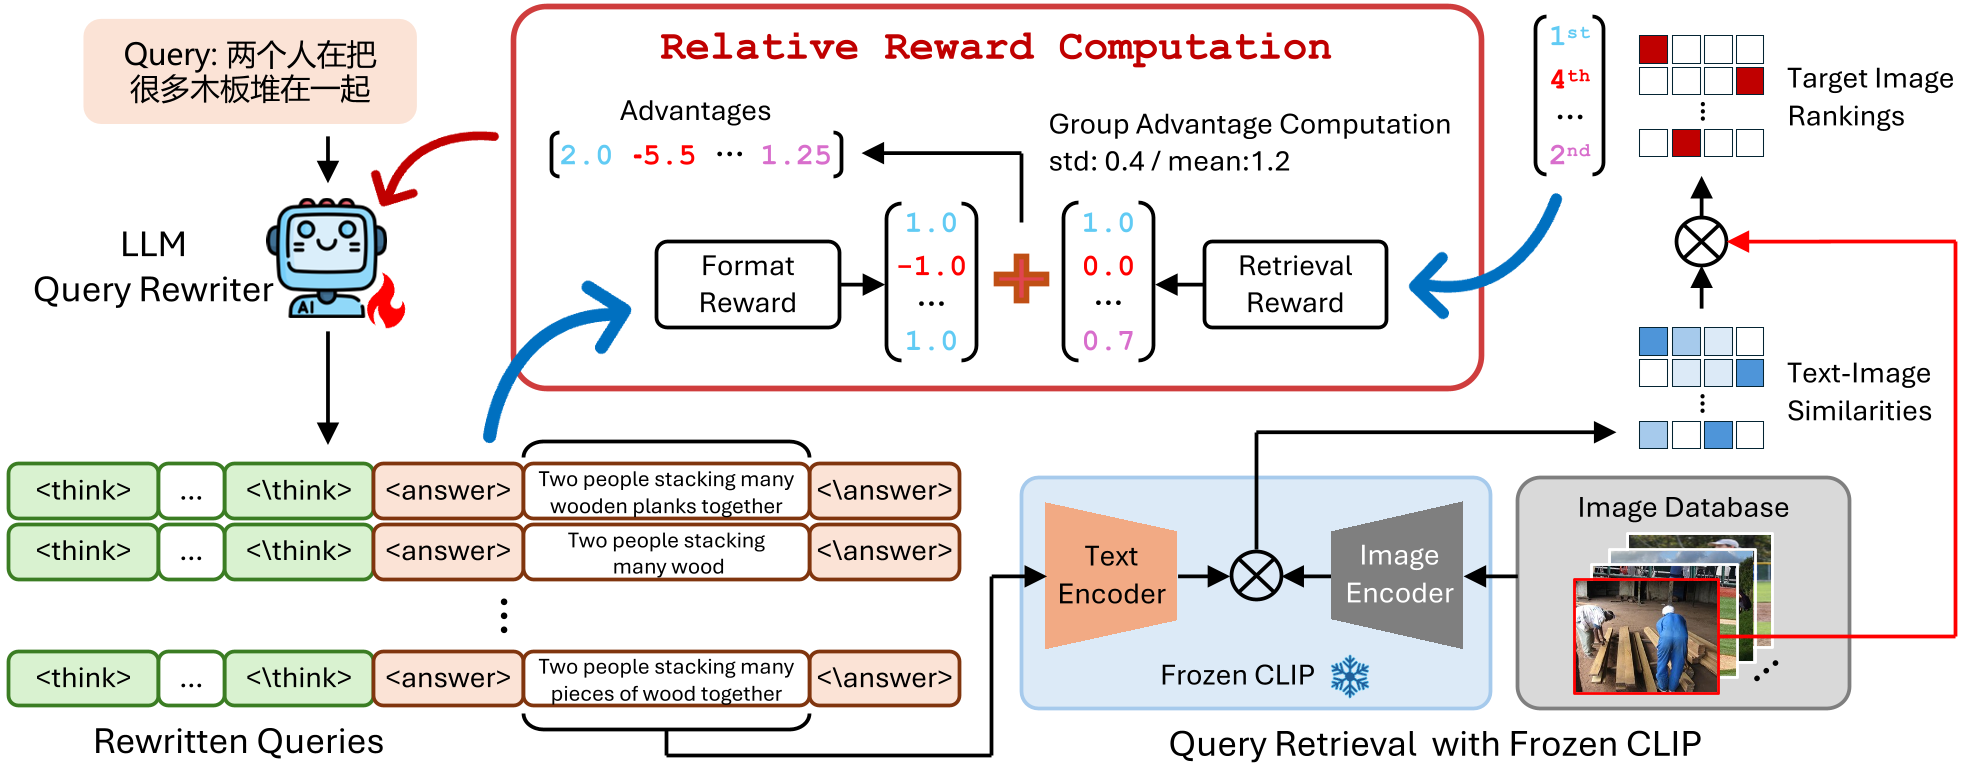
GRAPE 将一组(Grouped)重写候选放入同一个池子,根据它们在整个语料库中的实际召回排名计算相对奖励(Relative Advantage)。只有那些能显著提高排名的关键词才会被奖励。
实验与结果:化腐朽为神奇
研究人员在三个维度进行了严苛测试:
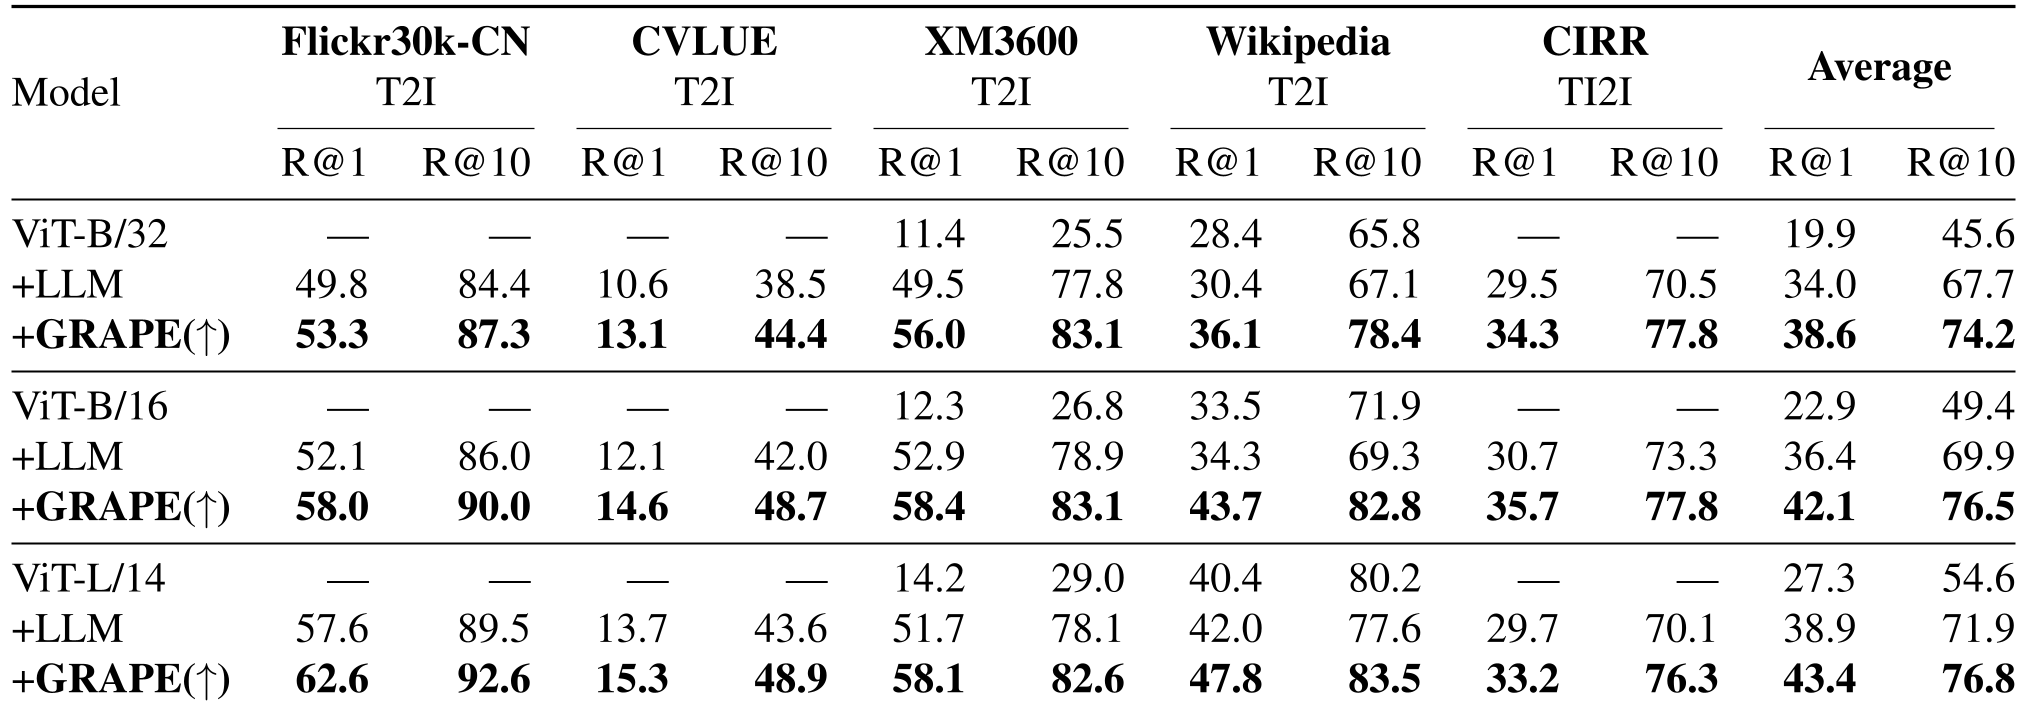
- 跨语言: 在中文数据集 Flickr30k-CN 上,Recall@1 提升显著。
- 长文本: 在 Wikipedia 任务中,GRAPE 能精准地将数百字的干扰描述蒸馏为检索器喜欢的核心视觉实体。
- 多模态: 在 CIRR 任务中,利用 Qwen2-VL 作为基础模型,成功实现了对“图像+指令”的联合重写。
消融分析:得分通胀的可视化
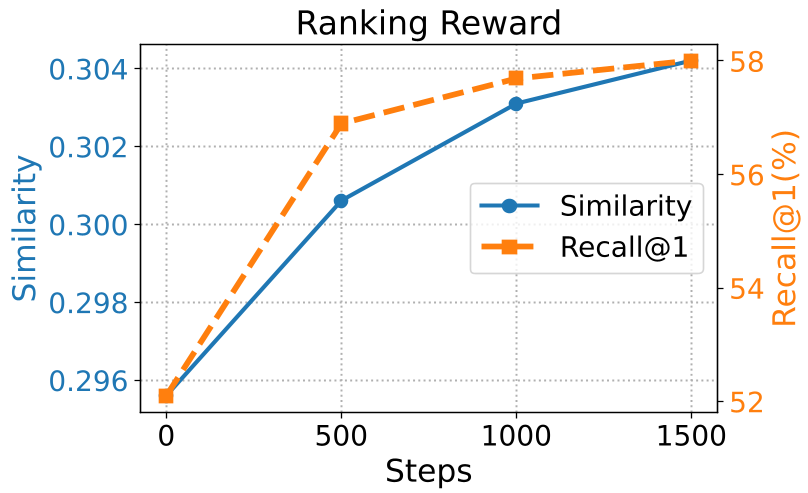
下图清晰地展示了“相似度奖励”的陷阱:随着训练进行,相似度斜率向上,但实际召回率 (Recall@1) 却直线下滑。而 GRAPE(基于排名的奖励)则实现了两者的同步增长。
深度洞察
- 数据极简主义:GRAPE 的学习效率惊人。实验显示只需 10,000 条训练数据(全量的 10%)即可达到 94% 的性能。这是因为它不是在学习“新知识”,而是在学习如何高效地“解码”检索器的偏好。
- 瓶颈所在:GRAPE 的上限取决于两个因素:LLM 本身的知识储备(如果 LLM 不认识某种方言,它也重写不好)以及检索器本身的表征上限。
- 工业价值:这是一种极其优雅的“热更新”方式。在不触动昂贵的底座索引的情况下,只需在推理端前置一个轻量级的 Qwen2.5-3B 节点,就能瞬间完成领域的自适应。
总结
GRAPE 的成功再次证明了,大模型时代下的检索优化不一定非要通过“堆算力、扩规模”来实现。通过精妙设计的策略优化(GRPO)和对底层物理直觉(排名 vs 得分)的准确捕捉,我们可以在既有基础设施之上榨取更多的潜力。