
GRPO-VPS:告别“胡言乱语”,让 LLM 学会精准推理
GRPO-VPS: Enhancing Group Relative Policy Optimization with Verifiable Process Supervision for Effective Reasoning
本文提出了 GRPO-VPS,一种通过可验证过程监督(VPS)增强群组相对策略优化(GRPO)的学习框架。该方法通过探测模型在推理过程中对正确答案的“置信度变化”来生成细粒度的过程奖励,在数学和通用推理任务上实现了 SOTA 性能及显著的推理效率提升。
TL;DR
在强化学习(RL)赋能大模型的时代,DEEPSEEK 提出的 GRPO 算法因简洁高效而备受关注。然而,GRPO 长期受困于“信用分配”不均:只要最后答案对了,中间所有“废话”和“错话”都会被奖励。GRPO-VPS 则通过一种天才的“信念探测”机制,利用模型对正确答案的实时概率增量作为奖励,不仅显著提升了数学推理准确率(最高 +2.6%),还让模型的推理过程缩短了近 14%,有效治理了 AI 的“长篇大论”。
背景定位
本文属于 RLVR (Reinforcement Learning with Verifiable Rewards) 领域的进阶之作。它在 GRPO 的基础上,利用了“过程监督”(Process Supervision)的思想,但精妙之处在于它不需要昂贵的外部奖励模型(PRM)或耗时的 Monte Carlo Rollouts,而是实现了一种“原生、可验证、低成本”的训练方案。
痛点深挖:轨迹奖励的“大锅饭”困境
目前的推理模型通常只看最终结果(Outcome):
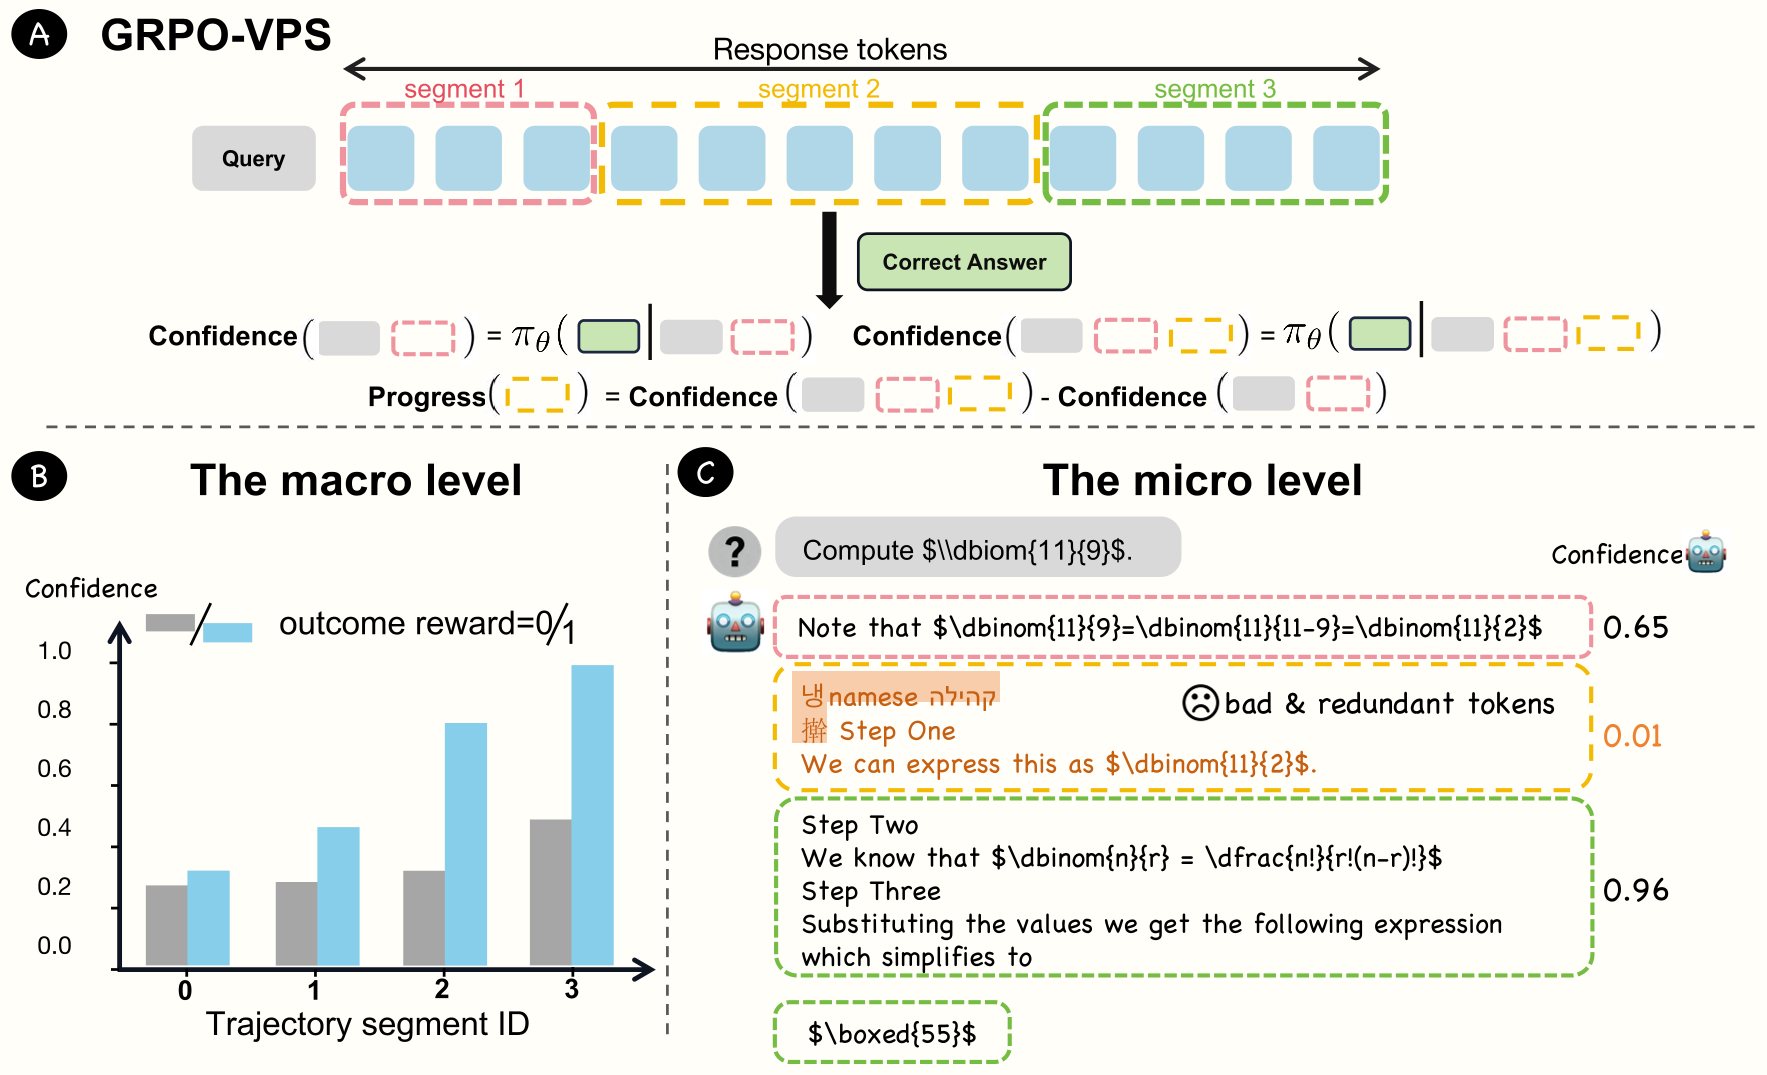
- 成功轨迹中的冗余:即便推理中途走了弯路甚至出现了幻觉,只要最后蒙对了,这些坏习惯也会被强化。
- 失败轨迹中的闪光点:如果推理前 90% 都是完美的,仅最后一步算错,整个过程都会被惩罚。 这种非黑即白的反馈导致训练效率极低,且模型倾向于产生冗余的 Reasoning Chains。
方法论详解:如何探测模型的“信念”?
1. 动态自适应分段
模型不会在每个 Token 上都进行深度思考。作者发现,性能提升主要由高熵(High-Entropy)的决策点驱动。因此,VPS 利用语义熵(Entropy)自动定位推理中的“岔路口”,将生成的文本切割成意义明确的 Reasoning Segments。
2. VPS 正则化奖励
VPS 的核心公式在于: 其中 是标准答案。这个公式在问:“在写完这一段推理后,模型你现在觉得选对正确答案的胜算增加了吗?” 如果这一段逻辑合理, 为正,给模型发糖;如果这一段在胡扯,胜算降低,模型被惩罚。
实验与结果:又快又准的“学霸”模型
SOTA 对比
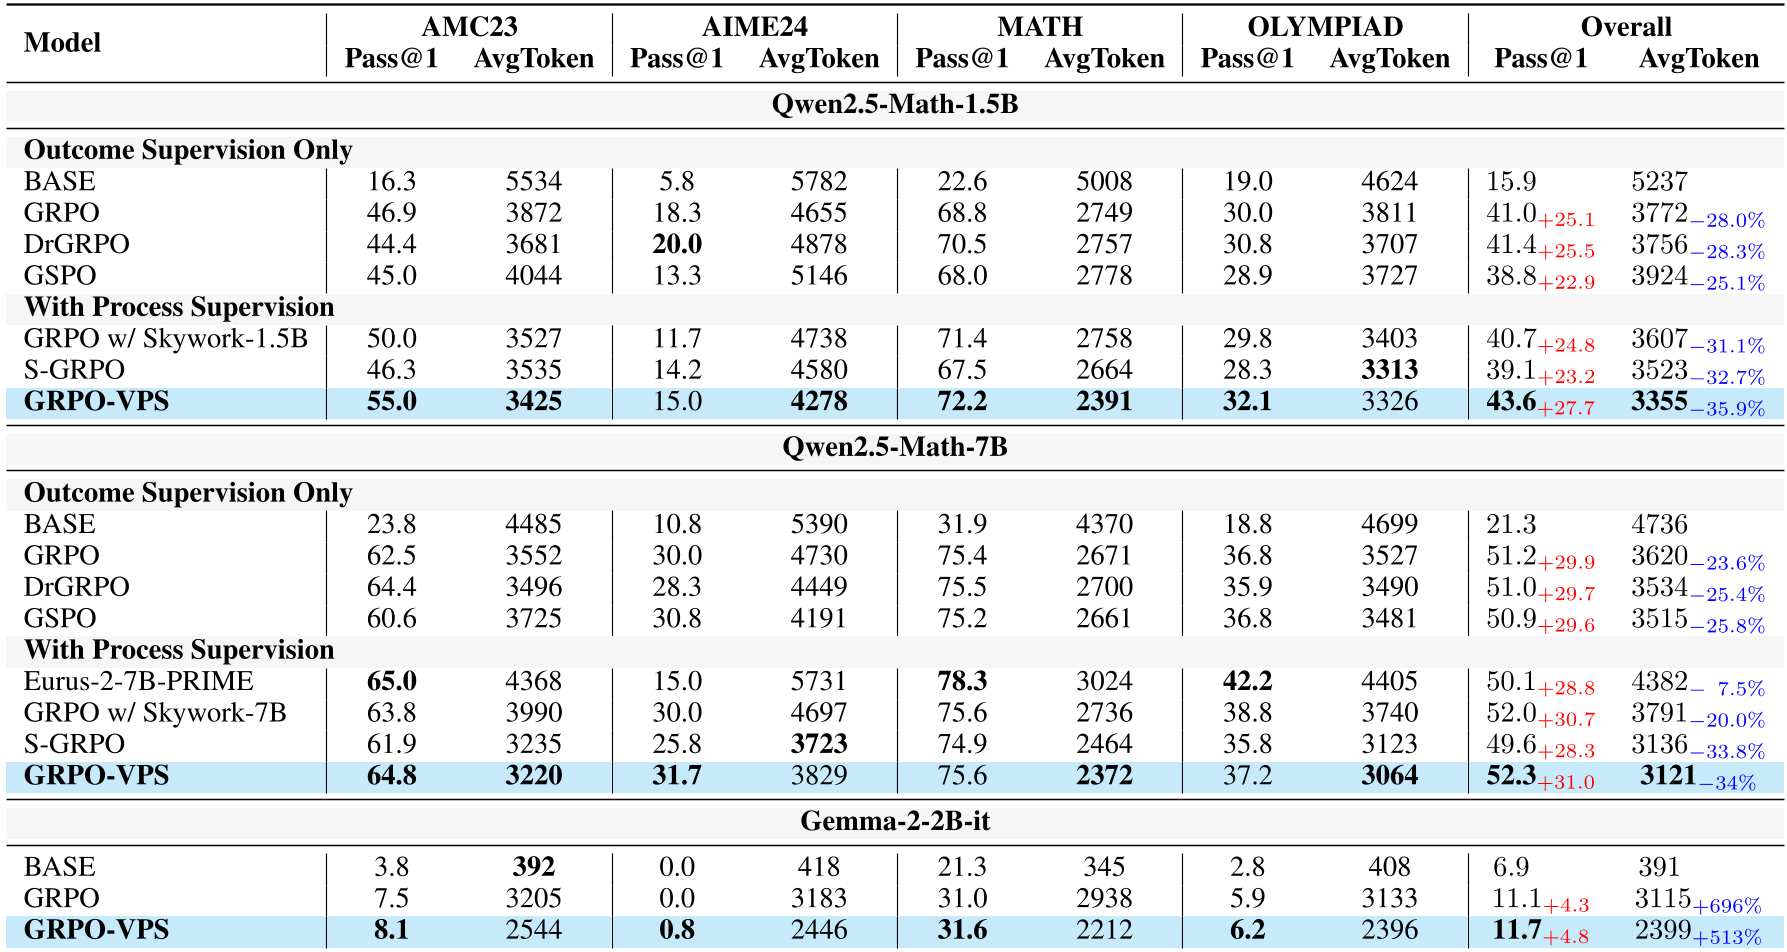
在多个数学竞赛榜单(AIME24, MATH, AMC23)上,GRPO-VPS 展现了压倒性的优势。特别是在 Qwen2.5-Math-1.5B 小参数模型上,其表现甚至逼近了许多大参数基线模型。此外,其推理长度(AvgToken)大幅缩减,意味着模型学会了“直击要害”。
消融实验 (Ablation Study)
实验证明:
- 单纯的过程监督(VPS-only)由于缺乏全局锚点,效果不如 VPS + Outcome 的混合模式(Accuracy 50.1% vs 72.0%)。
- 分段粒度:每个分段包含约 4 个关键点时平衡性最好。分得太细会增加计算开销,分得太粗则无法提供足够引导。
深度洞察:为什么这很重要?
GRPO-VPS 实际上是在挖掘模型内部的“隐性知识”。它告诉我们,推理模型其实“知道”自己在某一步是否在瞎掰,只是传统的训练策略没有把这种内部的焦虑(置信度下降)转化为学习信号。
局限性:由于该方法强依赖于“已知正确答案”来探测概率,因此它主要适用于有客观真理(数学、代码、科学)的场景,在纯文学创作等无唯一标准答案的任务中应用受限。
总结
GRPO-VPS 为 LLM 推理对齐提供了一条高效路径。它不仅让 AI 变得更聪明,也让 AI 变得更简洁。在未来的 LLM 后训练阶段,这种利用模型自身信念进行闭环微调的技术,极具商业落地价值。