
[KDD 2025] GuARD:语义与结构的双重奏,重塑富文本图异常检测效率
GuARD: Effective Anomaly Detection through a Text-Rich and Graph-Informed Language Model
本文提出了 GuARD,一种针对富文本图(Text-Rich Graphs)的高效异常检测框架。该方法通过将大语言模型(LLM)作为骨干,结合小模型提取的细粒度语义嵌入和图神经网络(GNN)提取的结构化特征,在 WhoIsWho 等四个数据集上实现了 SOTA 性能,且由于采用了多轮指令微调(Multi-turn Instruction Tuning),其推理速度比原生长文本 LLM 提升了 5 到 10 倍。
TL;DR
清华、中大与博世(Bosch)联合团队提出了 GuARD,这是一个专为富文本图(Text-Rich Graphs)设计的异常检测框架。它通过渐进式指令微调,将 LLM 的语义理解力、小模型的文本摘要能力以及 GNN 的结构表征能力三合一。在提升检测精度的同时,推理速度竟比同类 LLM 方法快 10 倍,解决了长文本场景下 LLM “算不动、学不精”的顽疾。
1. 痛点:被困在长文本里的 LLM
在学术网络纠错(如判断论文是否挂错作者)或社交网络僵尸号检测中,节点通常携带海量文本。现有方法往往面临两难境地:
- 传统 GNN:虽然能看清谁连着谁,但看不懂论文摘要里的学术逻辑,容易错过细粒度的语义违和感。
- Vanilla LLM:虽然懂语义,但面对成百上千个节点的长上下文,极易陷入“迷失中间(Lost in the Middle)”的窘境,且推理成本高得令人发指。
2. 核心架构:GuARD 的三步进化论
GuARD 并不是暴力地将所有文本塞进 Prompt,而是通过一种**“渐进式多模态对齐”**的方式进行训练:
第一阶段:任务引导的多轮指令微调 (Base Capability)
作者设计了多轮对话模板,让 LLM 在一个 Batch 内并行处理多个节点的预测。这种设计不仅让后续查询能复用先前的 Context(起到 Few-shot 效果),还极大地提升了处理效率。
第二阶段:语义嵌入模块 (Semantic Embedding)
为了处理 LLM 吞不下的超长属性,GuARD 调用了一个小而精的预训练模型(如 DeBERTa),将节点的富文本压缩成一个 <text> Token。这个 Token 就像一个“语义分身”,携带了全文的精髓。
第三阶段:结构嵌入模块 (Structural Embedding)
LLM 天生缺乏空间感。GuARD 通过引入 SOTA GNN(如 GCCAD)生成节点的结构向量,并映射为特殊的 <graph> Token。
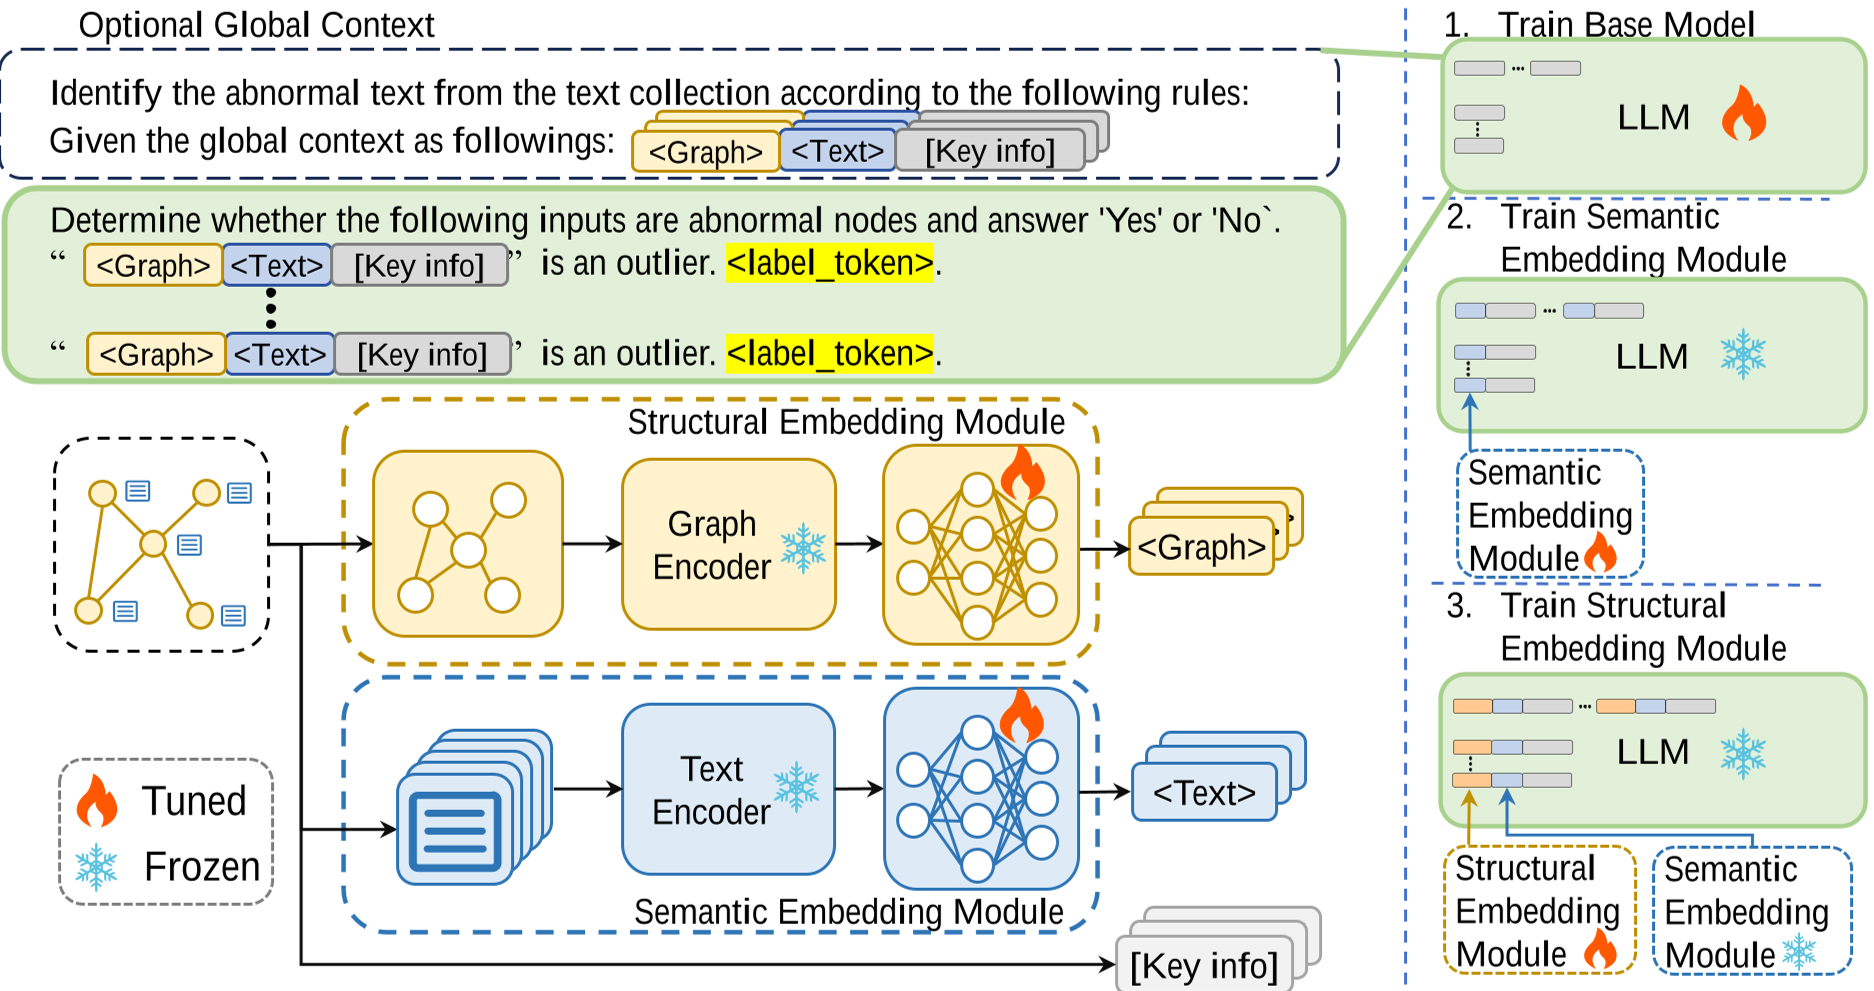 图 1: GuARD 的完整工作流。通过
<text> 和 <graph> 占位符,将多模态信息无缝泵入 LLM。
3. 实验战绩:不只是快,而且更强
GuARD 在 WhoIsWho 和 TwiBot-20 等数据集上展现了统治力:
- 性能:在 WhoIsWho 上 AUC 达到 0.789,全面超越了 Llama3 直接微调的结果。
- 效率:得益于多轮指令设计,推理速度最高获得了 10 倍 的 Speedup(见图 2)。
 图 2: 推理速度与 AUC 的权衡。GuARD(右上角)在保持高精度的同时,耗时远低于传统的长序列 LLM。
关键发现:Scaling Law 是否适用?
有趣的是,实验发现 7B 模型的效果往往优于 14B 模型。这暗示在特定的垂直领域异常检测中,模型架构的优化(如这种三阶段融合)比单纯堆参数量更有效。
4. 深度洞察:为什么渐进式训练有效?
在该论文的消融实验中,作者对比了“从头联合训练所有模块”和“渐进式训练”。结果发现,联合训练往往导致 LLM 偏向于捕捉某一种模态(如只看图结构),而忽视了另一方的贡献。GuARD 的分步走策略就像是先让模型学会“识字”,再学会“看图”,最后“融会贯通”,确保了多源特征的解耦与协同。
结论与启示
GuARD 的成功揭示了一个趋势:针对图数据,LLM 不应被作为一个全能的黑盒,而应作为**“多模态特征的汇聚路由器”**。通过小模型做文本预减枝,GNN 做结构浓缩,LLM 做终极逻辑决策,这种“大小协作”的模式可能是未来工业级图智能系统的理想形态。
注:本文基于 KDD 2025 录用论文《GuARD: Effective Anomaly Detection through a Text-Rich and Graph-Informed Language Model》整理。