
H-RAG:破解多轮对话 RAG 中的检索精度与上下文连贯性难题
H-RAG at SemEval-2026 Task 8: Hierarchical Parent-Child Retrieval for Multi-Turn RAG Conversations
本文提出了 H-RAG,一种专为多轮对话设计的层次化父子检索增强生成系统(Hierarchical Parent-Child RAG)。该系统通过解耦细粒度片段检索与长上下文重构,在 SemEval-2026 MTRAGEval 评测任务 A(检索)和 C(生成)中均表现出色,nDCG@5 达到 0.4271。
TL;DR
在近日举办的 SemEval-2026 Task 8 (MTRAGEval) 中,来自 JKU 等机构的研究团队推出了 H-RAG。该系统针对多轮对话场景,通过一套巧妙的层次化父子(Parent–Child)检索架构,有效解决了“检索要碎、生成要全”的固有矛盾。实验证明,该方案在长文档引用场景下相比传统 RAG 有显著提升,检索 nDCG@5 达到 0.4271。
背景定位
当前的 RAG 系统正从单轮问答向复杂的对话(Conversational RAG)演进。在 MTRAGEval 任务中,系统不仅要处理长文档检索,还要在多轮对话的语境下保持回答的证据一致性(Faithfulness)。H-RAG 的出现,实际上是对 RAG 流程中“原子语义单位”的一次深度重构。
痛点深挖:碎块好搜,但不好读
传统的 RAG 往往面临两难境地:
- 粒度过细:为了检索精准,将文档切成极小的 Chunk。结果生成模型拿到的上下文支离破碎,缺乏逻辑链条。
- 粒度过粗:直接拿大段落检索,索引向量会被背景噪音稀释,导致相关性下降。
- 对话依赖:用户说“它是怎么工作的?”,如果系统不结合前文理解“它”指代什么,检索必将失败。
核心方法论:层次化解耦
H-RAG 的核心直觉在于:检索阶段和生成阶段不应该共用同一种文本粒度。
1. 文档摄取(Hierarchy Ingestion)
- 子片段(Child Chunks):采用重叠的滑动窗口(3句话,步长2句)切分,用于细粒度的语义匹配。
- 父单元(Parent Units):保留完整的原始文档,作为生成阶段的 Context 来源。
2. 多级检索方案
H-RAG 并没有盲目堆砌模型,而是采用了一套极其严密的流程:
- Query 重写:利用 GPT-5 将对话历史中的隐含信息补全,生成独立查询语句。
- 混合检索:通过自定义参数 (实验设定为 0.7)均衡 Embedding 语义搜索和 BM25 词法搜索。
- 最大分聚合(Max-score Aggregation):关键步骤!系统检索出最相关的多个子片段,然后将得分最高的子片段的分数赋予其所属的父文档。
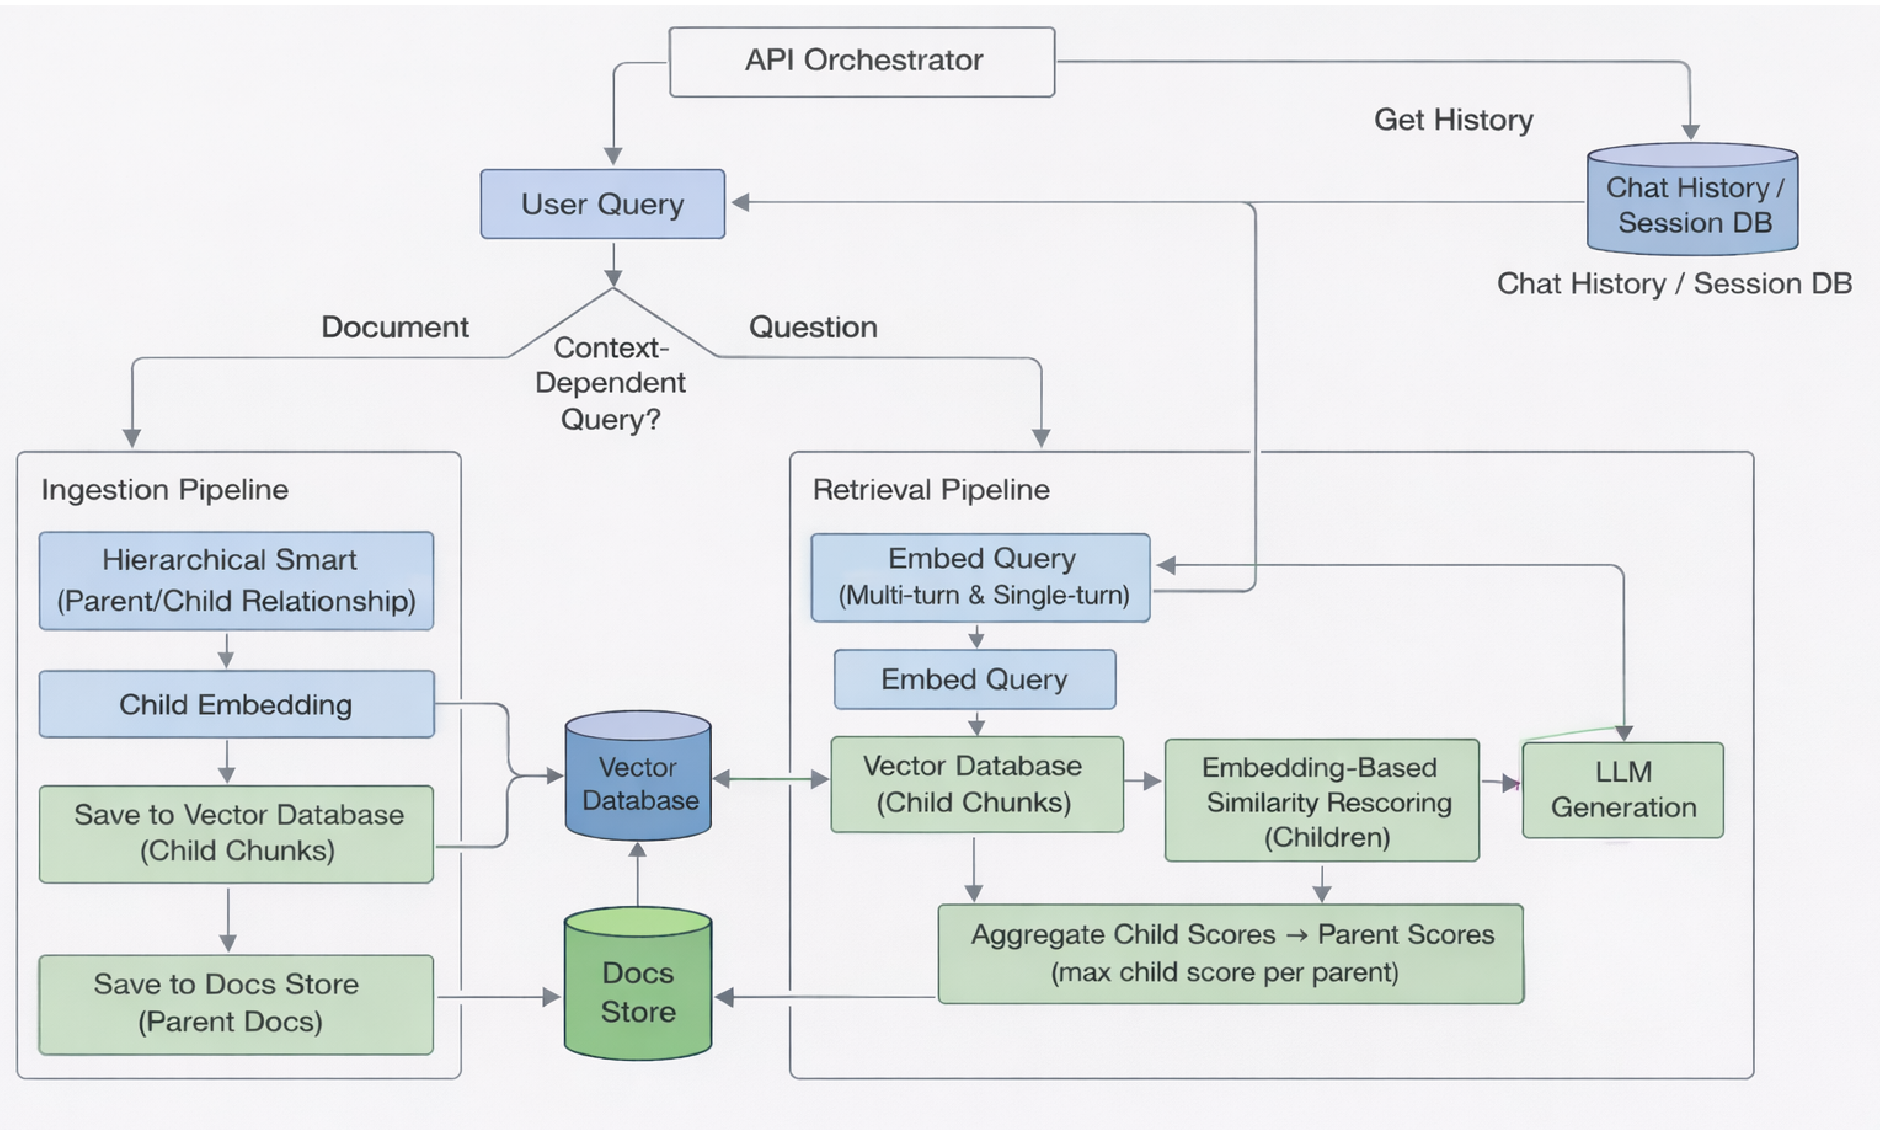 图 1:H-RAG 的流水线:从父子碎片化切分到两级检索重分
实验与结果分析
研究团队进行了详尽的大规模消融实验,揭示了 RAG 系统中几个被忽视的真相:
- 重定向至父文档是王道:实验发现,在检索到子片段后,如果额外对父文档进行一次重打分(Parent-level rescoring),nDCG@5 指标从 0.46 左右一跃提升至 0.48+。
- 混合权重并不敏感: 值在 0.5 到 0.9 之间浮动时,性能波动极小,说明在多轮对话中,稳定的 Embedding 质量比精调混合权重更重要。
- 生成未必代表落地:H-RAG 的生成流畅度得分(RB_llm)高达 0.65,但证据落地得分(RB_agg)仅为 0.24。这警示我们:LLM 极其擅长“一本正经地胡说八道”,即使检索到了正确文档,如何强迫 LLM 严格依据文档回答仍是个巨大挑战。
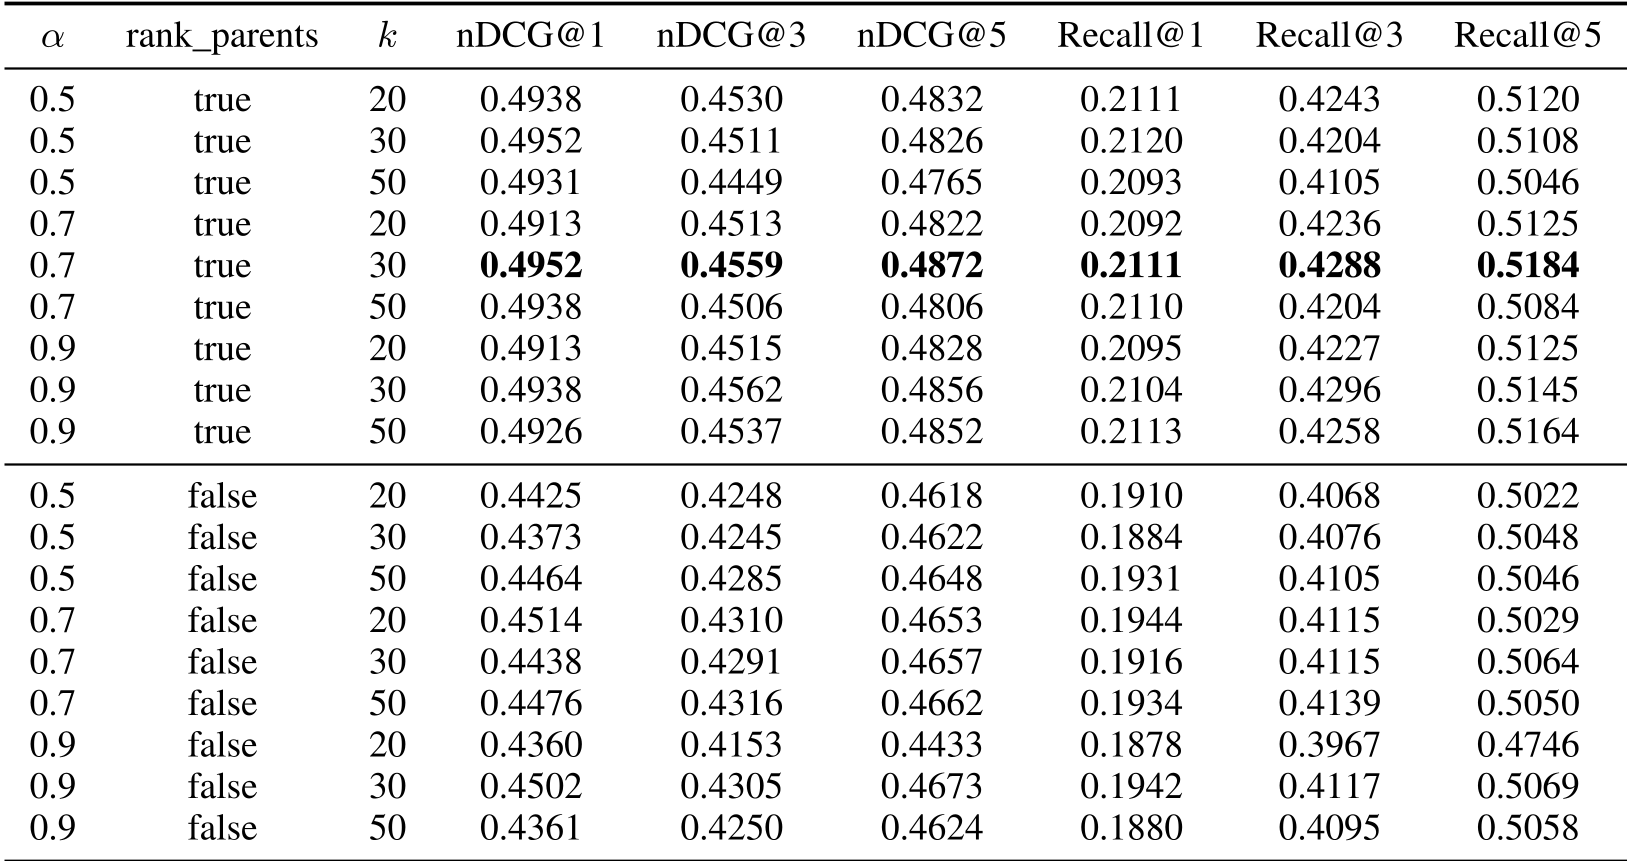 表 2:不同候选集大小 和重分策略对检索性能的影响
深度洞察与总结
H-RAG 展示了通过**工程策略(父子架构+最大分聚合)**而非仅仅堆砌算力也能显著提升检索质量。
结论 (Takeaway): 层次化架构是目前解决长文本 RAG “精确度 vs 连贯性”冲突的最佳实践。但我们也应清醒看到,虽然检索质量在提升,LLM 如何高效“消费”这些证据并保持忠诚度(Faithfulness),依然是多轮对话 RAG 技术栈中的“阿喀琉斯之踵”。
未来方向:
- 引入不确定性感知检索,当检索证据不足时让模型主动“拒绝回答”。
- 深化上下文对话摘要技术,减少由于对话历史过长引入的检索噪声。