
HoH:把单次 coding harness 组织成长程可验证自主开发协议
Harness-of-Harness: Multi-Day Autonomous Software Development with Continual Improvement
本文提出 Harness-of-Harness(HoH),一种建立在现有 coding harness 之上的多轮规划、编码、独立测试框架,用于让 coding agent 在长程自主软件开发中持续改进项目状态。论文在 GameCraft-Bench、FrontierSWE 和 ProgramBench 上验证其效果,并给出一个超过 70 轮迭代的独立游戏开发案例。主要结论是:三种 harness–model 配置在三轮 HoH 后均优于对应 Vanilla 基线,平均相对提升 52.25%,最大相对提升 82.86%。
TL;DR
Harness-of-Harness(HoH)不替换现有 coding harness,而是在其外层引入 Project Planner、Developer 和 QA Tester 的三轮规划、编码、独立测试循环,让 agent 在长程软件项目中同时继承代码状态和验证证据。论文在 GameCraft-Bench、FrontierSWE 和 ProgramBench 上比较三种 harness–model 配置,三轮 HoH 后平均相对提升 52.25%,最大相对提升 82.86%。在 Fusepoint 这个多天开发案例中,HoH 在 70 轮后自主完成一个包含剧情、战斗、武器交互、HUD、菜单和音效的第一人称射击游戏雏形。
这篇论文的位置比较明确:它不是继续训练更强的 coding model,也不是把 harness 自身当作可学习对象,如 AutoHarness、Meta-Harness 或 Self-Harness 所做的那样。它属于系统协议型方法改进:给定固定的 model 和 harness,作者通过外层状态管理、角色权限和证据绑定,把有界 episode 延长为可审计的迭代开发。这个判断的依据来自论文第 3 节对 “fixed harness–model configuration” 的强调,以及实验设计中 Vanilla 与 HoH 使用同一 harness、同一模型、同一 benchmark 初始状态,只改变是否启用 HoH 协议。
问题与动机:长程开发真正丢失的是可验证连续性
常规 coding agent 的困难并非只是“任务更长”。仓库级问题修复、函数补全或小型脚本生成虽然也依赖多步推理,但其目标边界相对清楚。端到端从零开发则不同:需求、实现依赖、构建状态、资源绑定、交互反馈和视觉质量同时演化,且它们往往不能被一个固定指标概括。论文在 Section 3.1 中把这种任务写成:
其中 是高层软件规格, 是满足功能和质量的最终工件, 是语言模型, 是 coding harness。这个形式化看似简单,却暴露了长程开发的难点:同一个 和 配置要在多轮循环中反复读取变化的项目状态,并输出下一轮可用的候选工件。若每一轮只看到当前代码,系统就会丢失“为什么这样改”“哪些行为已验证”“哪些失败仍未解决”。如果继续把信息塞进上下文,又会撞入 bounded context;如果放任 agent 重写,又会破坏已经工作的模块。
作者的关键直觉来自软件工程传统:迭代和增量开发。论文没有把它作为口号,而是落到两个互补状态上。这个直觉并非纯工程猜测,后面 Section 4.3 的消融实验给出支持:去掉计划更新、证据反馈或工件 warm-start,都会显著降低最终得分。因此,HoH 的动机可以被概括为一种失效机制定位:现有 harness 缺的不是更多 token,而是一种跨轮继承机制,使下一轮规划不再从当前代码反向猜测整个项目轨迹。
核心章节:从单次 pass 到证据绑定的循环系统
基线:一次性 pass 如何丢失项目状态
Vanilla 基线使用对应 harness–model 配置进行一次标准开发 pass。它的问题在于,最终工件 只记录“当前存在什么”,而不记录“哪些要求仍未满足”“哪些行为曾经通过测试”“哪次修复引入了哪次回归”。当开发进入多轮,Planner、Developer 和 Tester 的决策彼此耦合,但一次性 pass 把三类决策压进同一个 agent 轨迹。论文在 Section 3.2 中指出,这类决策需要不同上下文和权限:目标选择需要项目级视角,实现需要写权限和本地技术自主性,验收则需要独立于实现声称的证据判断。
这构成 HoH 的出发点。若只增加 pass 数量,而不改变状态传递和验收结构,系统可能只是重复相同推理路径,或者在后期陷入局部修复。论文用 “repetitive cycles of inspection and repair, redundant verification of completed components, or premature declaration of completion” 描述这类风险。换言之,长程失败不是单点 bug,而是项目状态与开发证据脱节后的系统性漂移。
HoH 循环:工件状态与证据状态共同跨越 loop boundary
HoH 的核心结构是把项目状态拆成两类。 是第 轮后的软件工件,包括源代码、配置、资源和项目元数据; 是对 依据规格和当前开发目标进行评估后得到的执行证据。论文把循环边界写成:
其中 供 Developer 继续写代码, 供 Project Planner 判断下一轮目标。这个式子在论证链条中承担“状态守恒”的作用:它说明 HoH 不依赖一个专门 memory module,也不把所有内容塞进上下文,而是在文件系统里持久化 plan、report、history 和 artifact,并用 index 做渐进披露。若只有 ,下一轮仍必须从代码重建项目知识;若只有 ,系统没有可执行载体。二者都缺,长程增量开发就退化成一轮又一轮猜测。
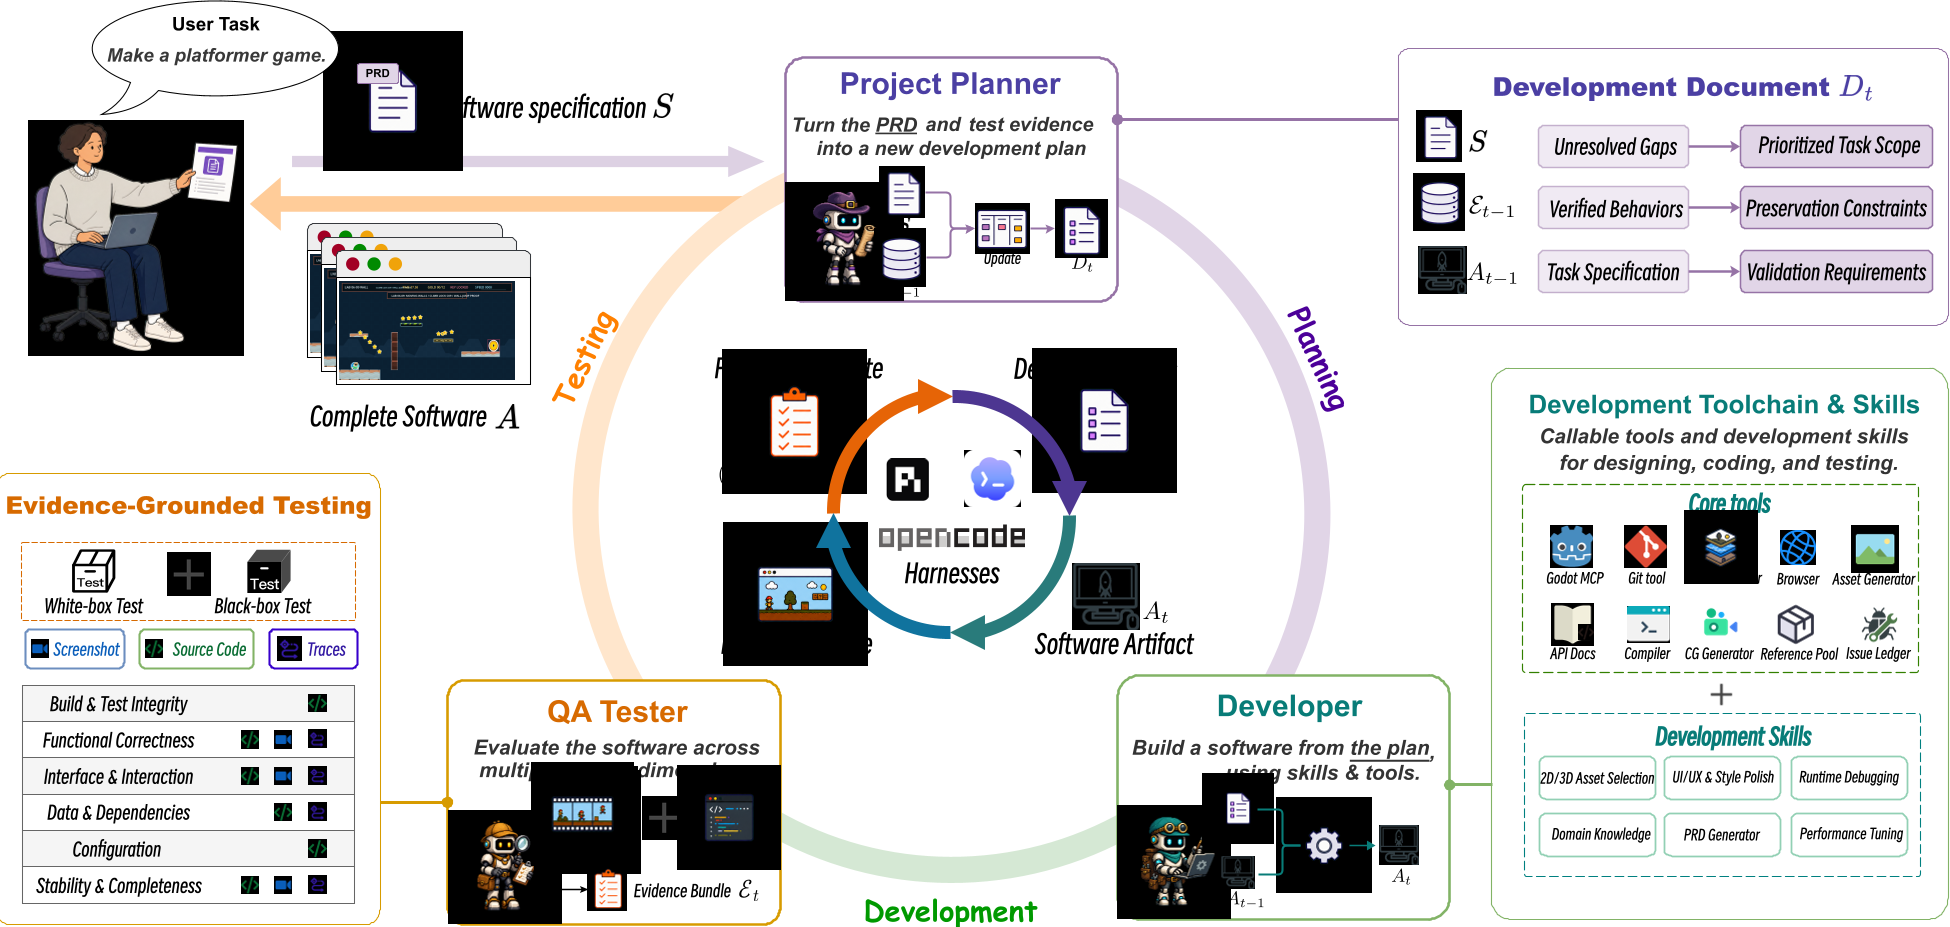
这张总览图补充了形式化状态之外的工程约束:Runtime 会冻结每个角色的输入,强制权限,并把证据绑定到被测试的候选工件。这里的“冻结”很关键。独立 QA 若面对一个仍在变化的项目,证据就无法对应某个版本。HoH 让 Developer 成为唯一写入者,QA Tester 只读取冻结候选,因此每个测试观察都有一个明确身份。这与单纯让同一个 agent “自测后再总结”不同,它把验收权从实现声称中分离出来。
角色与 Runtime:约束输出,而不是规定流程
HoH 每一轮调用同一 harness–model 配置三次,但角色 prompt 和权限不同。论文在补充材料 A.1 中把一轮实现拆成三个接口:
其中 是第 轮开发文档, 是公开规格, 是上一轮证据。Planner 的职责是把竞争需求压缩成一个 bounded but locally complete 的目标:不能只修一个孤立文件而破坏可观察行为,也不能一次加入过多无关特性。这个公式的作用是定义“下一轮做什么”,而不是定义“怎么编码”。若把 固定为 ,系统就会失去根据新证据重排优先级的能力,这正是消融中 w/o Plan Update 的设计。
这个式子说明 Developer 从 warm-start,并在 约束下修改工件。分号左侧是可写状态,右侧是公共规格和本轮文档。Developer 可以保留 native file、shell、build、run 和 local testing tools,论文没有规定其内部推理链或工具序列。这样设计的好处是保留实现自主性:不同项目结构、依赖冲突和 runtime 行为很难在 planning 阶段预先写死。若没有 warm-start,Developer 每轮从空 workspace 重建,会重复劳动,论文实测 token 从 8.41M 增至 11.12M per task。
这是独立验收的核心。QA Tester 读取冻结的 ,结合 和 生成证据。论文强调黑盒测试观察用户可感行为,白盒测试诊断内部状态和失败原因。证据状态不是自由文本,而是 claim–evidence–status 记录:只有在公开执行记录支持时才标记 verified,观察失败、未满足需求、回归风险和证据不足都记录为 gap。若去掉这一步,Planner 下一轮只看到代码,看不到哪些行为仍需保护,也看不到哪些声称尚未证实。
一个值得追问的设计选择是:为什么不直接做更强的单 agent long context?论文给出的答案是渐进披露和文件系统持久化,而不是把 history、report、plan 全塞进 prompt。这在理论上更稳健,因为 context 长度有限,且历史噪声会干扰目标选择;但论文没有系统比较 “HoH with file-based progressive disclosure” 对 “HoH with a dedicated vector memory” 的差异,因此该优势更多来自消融中计划更新、证据反馈和 warm-start 的联合效果,而不是单独证明某种 memory 架构最优。
实验与证据:三轮循环稳定提升,十轮案例显示长程不单调退化
实验首先把 HoH 放回 benchmark 原始设置中,不额外加入 role-specific tools、skills 或版本控制机制。论文使用三个基准:GameCraft-Bench、FrontierSWE 和 ProgramBench。GameCraft-Bench 要求 agent 从自然语言规格构建完整可玩的 Godot 项目;FrontierSWE 覆盖从零实现、性能优化和研究式任务;ProgramBench 是 clean-room 程序重建,agent 只能看 compiled executable 和文档,要重建行为匹配的 codebase。
Table 1 报告了三种 harness–model 配置在 Vanilla 与 HoH@1 至 HoH@3 下的聚合指标:
| 配置 | 设置 | GameCraft Overall | FrontierSWE Dominance | ProgramBench Pass Rate |
|---|---|---|---|---|
| Codex + GPT-5.5 high | Vanilla | 49.58 | 44% | 60.41 |
| Codex + GPT-5.5 high | HoH@1 | 59.71 | 58% | 65.42 |
| Codex + GPT-5.5 high | HoH@2 | 64.84 | 60% | 65.79 |
| Codex + GPT-5.5 high | HoH@3 | 71.52 | 71% | 66.50 |
| OpenCode + DeepSeek-V4-Pro | Vanilla | 26.90 | 25% | 45.27 |
| OpenCode + DeepSeek-V4-Pro | HoH@1 | 28.61 | 28% | 55.33 |
| OpenCode + DeepSeek-V4-Pro | HoH@2 | 40.32 | 42% | 55.66 |
| OpenCode + DeepSeek-V4-Pro | HoH@3 | 48.98 | 44% | 57.56 |
| Pi + MiniMax-M3 | Vanilla | 42.16 | 35% | 35.83 |
| Pi + MiniMax-M3 | HoH@1 | 49.06 | 62% | 48.68 |
| Pi + MiniMax-M3 | HoH@2 | 55.04 | 66% | 53.57 |
| Pi + MiniMax-M3 | HoH@3 | 58.78 | 64% | 52.68 |
这张表的主结论很明确:HoH@3 在所有配置和三个基准的聚合指标上都高于 Vanilla。GameCraft-Bench 的绝对提升分别为 Codex 加 21.93,OpenCode 加 22.08,Pi 加 16.62;ProgramBench 的 Pass Rate 分别提升 6.09、12.29 和 16.85。FrontierSWE Dominance 的变化则显示,Pi 加 MiniMax-M3 的提升最陡,从 Vanilla 35% 到 HoH@3 64%;Codex 从 44% 到 71%;OpenCode 从 25% 到 44%。论文还报告 FrontierSWE 的 mean reward:Codex 从 0.31 到 0.54,OpenCode 从 0.23 到 0.31,Pi 从 0.26 到 0.55。
GameCraft-Bench 的分数并非单一功能指标。Table 1 的 Overall 由四个 benchmark 定义维度组合而成。论文在补充材料 B.7 中给出:
其中 是 artifact 能否编译运行的 binary gate,若不能运行则为 0;、、、 分别是 Core Mechanics、Content Depth、Functional Visuals 和 Art and Presentation 的均值 rubric scores。这个式子说明为什么 HoH 提升不能简单归因于“代码更对”:权重里 Depth 和 Presentation 合计 0.70,意味着可玩性、内容广度、视觉反馈和呈现质量同样决定总分。Figure 4 进一步显示,HoH@3 在三个配置下都提升全部四个维度:Codex 提升 20.00 至 25.56,OpenCode 提升 19.25 至 34.63,Pi 提升 11.32 至 25.38。
论文还做了预算控制比较,以回答“是不是 HoH 只是多花 token”。Table 2 使用 Codex 加 GPT-5.5 high 在 GameCraft-Bench 上比较相同开发 pass 数下的结果:
| 方法 | 开发 pass 数 | Score | Tokens per task (M) |
|---|---|---|---|
| Vanilla | 1 | 49.58 | 2.59 |
| Vanilla Continuation | 2 | 54.99 | 4.56 |
| Vanilla Continuation | 3 | 58.24 | 6.33 |
| HoH | 1 | 59.71 | 2.88 |
| HoH | 2 | 64.84 | 5.67 |
| HoH | 3 | 71.52 | 8.41 |
这里最有力的证据是:HoH@2 用 5.67M tokens 达到 64.84,超过三 pass Vanilla Continuation 用 6.33M tokens 得到的 58.24。论文根据式 (12) 计算,Vanilla Continuation 和 HoH 的三轮相对 Vanilla 分别获得 2.32 和 3.77 的每百万 token 分数增益。也就是说,HoH 的优势不是单纯多调用了 coding harness,而是 planning、coding、testing 和 evidence carryover 带来了更有效的质量增长。
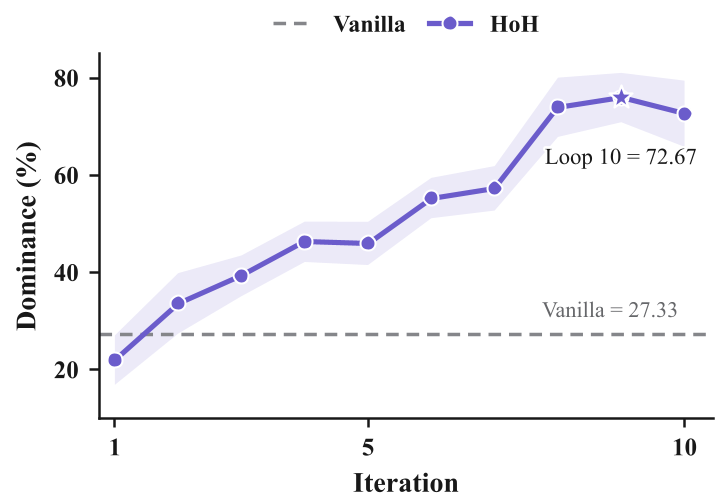
十轮分析进一步支撑“持续改进”主张。Figure 5 显示,在相同 15 个 FrontierSWE 任务上,Codex 加 GPT-5.5 high 的 Dominance 从 HoH@3 的 39.33% 升至 HoH@10 的 72.67%,最佳 checkpoint 为 HoH@9 的 76.00%,而 Vanilla 为 27.33%。这个曲线比表格更有价值,因为它说明收益没有在三轮后迅速饱和;不过也要注意,它只在 Codex 配置和 FrontierSWE 上验证,不能直接外推到所有基准和模型。
拆解性证据来自 Table 3 的消融实验。该实验仍然使用 Codex 加 GPT-5.5 high、,并在全部 45 个 GameCraft-Bench 任务上比较:
| 消融变体 | GameCraft Score | Tokens per task (M) |
|---|---|---|
| Full HoH@3 | 71.52 | 8.41 |
| w/o Plan Update | 63.39 | 7.56 |
| w/o Evidence Feedback | 65.23 | 7.46 |
| w/o Warm-Start | 63.67 | 11.12 |
三个变体分别冻结首轮开发文档、从重规划中移除上一轮证据、或让每轮 Developer 从空初始 workspace 重建。分数下降 8.13、6.28 和 7.85,说明核心贡献确实来自跨轮机制:计划需要证据更新,证据需要进入下一轮规划,实现需要继承工件。Warm-start 被去掉后 token 显著上升,这与“不重复重建已完成代码”的设计理由一致。论文称三个变体在每个任务上都低于 Full HoH@3,因此这不是平均值掩盖个别收益的结论。
不过,证据质量并非没有边界。主实验每个 task–condition 只有一个有效 run,聚合分数平均的是任务,不是同一任务的多模型采样;补充材料 B.2 明确说明当基础设施或 provider transport error 发生时,会替换失败 attempt,而不是把它作为重复实验。对 benchmark 子集,GameCraft 用 45 个任务,FrontierSWE 从 17 个任务中选 15 个,排除的两个任务因外部 API 或驱动环境不可用。ProgramBench 的 token 统计也有 provider cache accounting 差异,只能做同配置内部比较,不宜跨 provider 比较成本。因此,跨 harness 的绝对 token 数字应谨慎阅读。
多天案例:Fusepoint 暴露了 benchmark 不测量的问题
如果只看 benchmark,HoH 的三轮提升已经足够。论文第 5 节的 Fusepoint 案例则试图回答一个更困难的问题:在 implementation constraints、validated behavior 和 observed failures 大量累积后,系统还能保持 coherent project evolution 吗?该任务是一个五分钟单人 bomb-defusal mission 的第一人称射击游戏,要求有序夺取两个 control points,在最终目标完成三阶段 defusal,包含 3、5、10 三个 encounter regions 的 18 个敌人分布,以及成功和 detonation 分支。
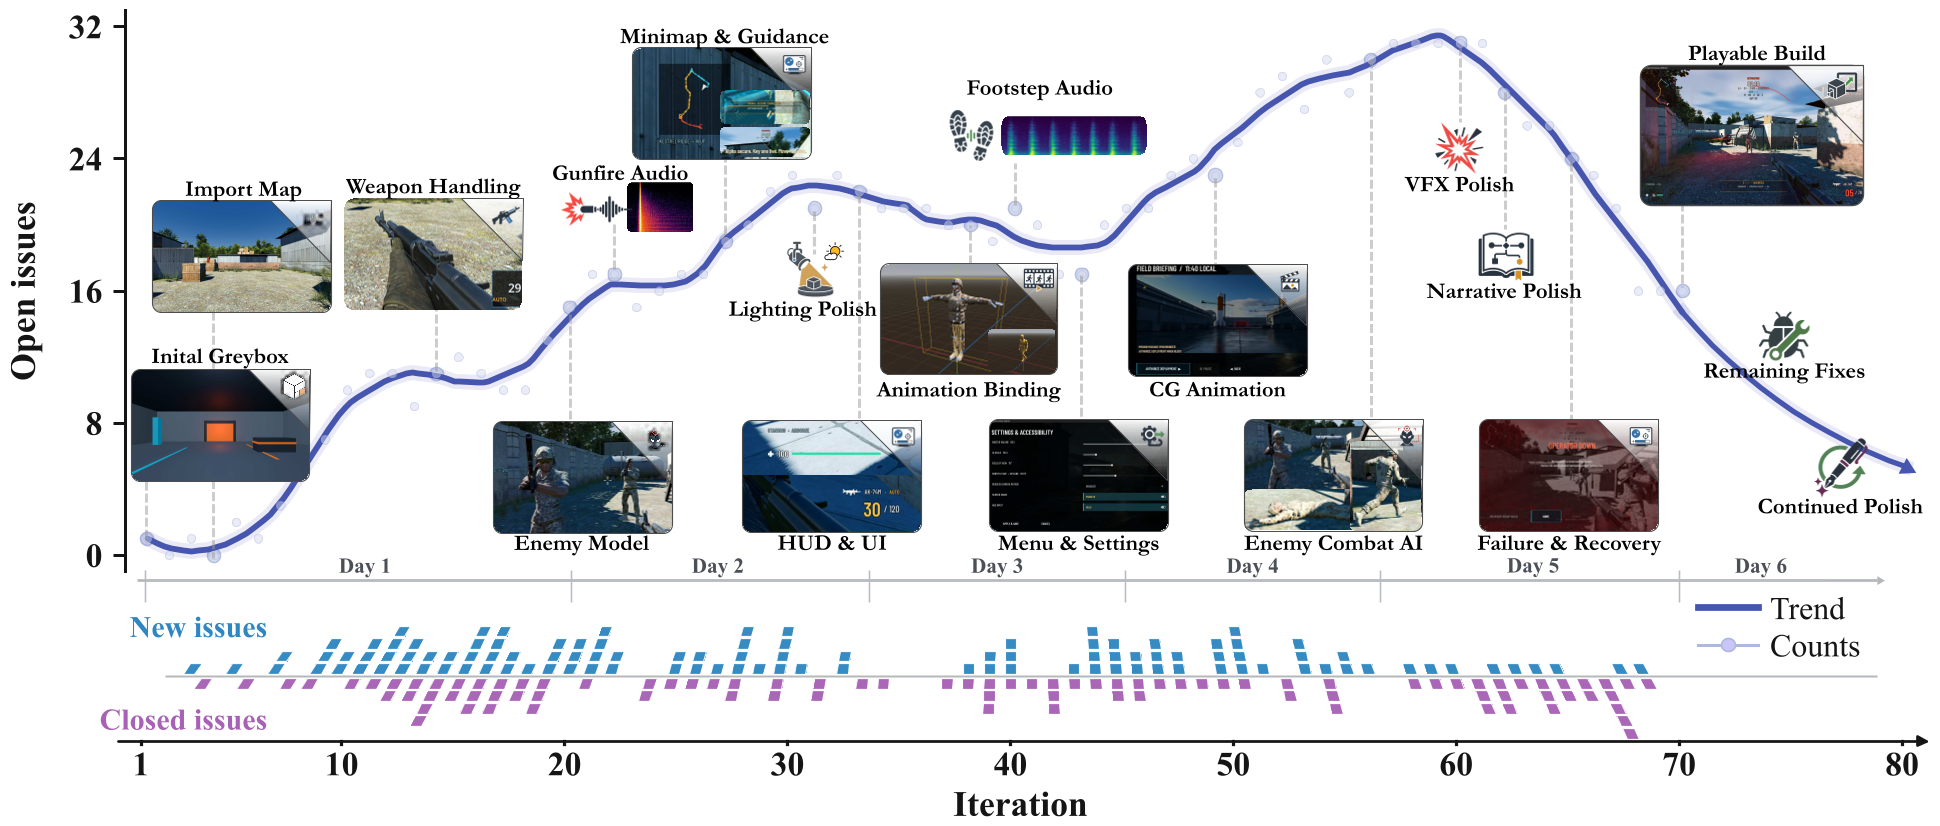
论文使用 CodexCLI 和标注为 GPT-5.6-Sola high reasoning effort 的配置,在分析截止点完成 70 个 development loops。人类介入仅限于恢复网络或 API availability,不参与 planning、implementation、debugging、testing 或 acceptance。与 benchmark 设置不同,这里额外加入 Godot MCP、asset generation、UI/UX presentation、testing skills 和 GitHub version control,因此更接近开放游戏工程环境。
Section 5.2 的 issue dynamics 是这个案例最有信息量的部分。70 轮轨迹分为三个 broad phases:Loops 1–27 建立可执行项目和核心交互路径;Loops 28–49 结合新功能与继续诊断;后期计划能力接近完成,issue resolution 更频繁,active backlog 开始下降。到 Loop 70,81 个记录 issue 中 65 个已关闭,16 个 unresolved;其中 17 个 issue 在关闭后因后续修改导致已验证行为重新失败而被 reopened。这个 reopen 记录的意义不是“系统很完美”,而是它提供了回归检测的项目证据:失败行为和早期验证历史被保留,后续 Planner 可以把 regression repair 当作显式工作,而不是从晚期 artifact 反推。
深度洞察:HoH 的价值在于把软件工程原则转译为 agent 权限协议
HoH 的核心贡献不是某个单点算法,而是一组相互咬合的约束:有界增量、单一写者、独立验收、证据绑定候选、版本化历史和结构化输出。它把 iterative and incremental development 从人类团队方法论转化为 coding agent 可执行的角色协议。相比 MetaGPT 或 ChatDev 这类预定义 role-based workflow,HoH 不规定 agent 内部推理过程,只规定必须交付什么;相比 OpenHands 这类 harness 内部能力,HoH 把多个 harness invocation 连成项目级循环;相比 Self-Harness 这类修改 harness 自身的方法,HoH 保持 model、base harness、role definitions 和 runtime policy fixed,只让 artifact、document 和 evidence evolve。
它的局限也同样具体。第一,主实验的 和十轮 FrontierSWE 分析不能覆盖所有长程退化情形:论文没有证明 HoH 在 70 轮 benchmark 任务上仍保持同样的增益斜率。第二,Fusepoint 是单项目、单配置、多天开放案例,issue counts 和可玩性提供了定性连续性,但没有与多个开放软件项目进行受控对比。第三,某些子结果并不单调:Table 1 中 Pi 在 ProgramBench 的 HoH@2 Pass Rate 高于 HoH@3;Table 16 的 OpenCode 任务级结果也显示个别类别在 HoH@1 或后续轮次出现下降,例如 Adventure 的 Bouncy 从 Vanilla 7.09 到 HoH@1 13.66,再到 HoH@2 0.73,最后 HoH@3 25.35。这说明有界增量的选择质量会直接放大后续收益,Planner 错误选择目标时,循环并不自动修复。
未来最值得推进的方向有三类。其一是把 evidence state 做成可检索、可冲突解决的结构:当多个候选都通过不同 check 时,Planner 如何选择最小可验证增量。其二是把 regression detection 从 issue history 提升为形式化 preservation gate,尤其在资源、音频、视觉和 runtime 状态耦合较高的游戏项目中。其三是降低 QA 成本:独立验收带来强证据,但也增加 invocation;论文显示预算控制中 HoH 的 token 高于 Vanilla,后续系统需要在 evidence completeness 和 test cost 之间学习更细粒度策略。总体而言,HoH 提供了一个实用路径:让 coding agent 的长程能力不只依赖更大上下文,而依赖可追溯、可验证、可继承的工程协议。