
HEAVYSKILL:将“深度思考”内化为 Agent 的核心内功
HeavySkill: Heavy Thinking as the Inner Skill in Agentic Harness
本文提出了 HEAVYSKILL,一种将“深度思考(Heavy Thinking)”内化为大模型 Agent 核心技能的新范式。该方法将传统的 Agent 编排抽象为“并行推理(Parallel Reasoning)+ 序列审议(Sequential Deliberation)”的两阶段流水线,并在 STEM 和通用任务上超越了传统的 Voting (BoN) 基线。
TL;DR
在 Agentic Harness(代理编排)领域,复杂的系统设计往往让开发者眼花缭乱。本文提出的 HEAVYSKILL 拨云见日,指出所谓复杂的代理协作本质上可以内化为一种 “并行推理 + 序列审议” 的深度思考技能。该方法无需修改系统架构,仅通过这种 Inner Skill 的注入,就能在数学、代码及复杂推理任务上显著超越传统的 Majority Voting(多数投票)方案,并支持通过强化学习(RLVR)进一步进化。
1. 痛点深挖:编排之繁与推理之简
当前的 Agent 框架(如 Claude Code, OpenClaw 等)通常建立在复杂的“代理循环”之上:编排器(Orchestrator)调用多个子代理、管理上下文、调度工具。 然而,这种“外置”的复杂性带来了三个问题:
- 性能黑盒:很难判断提升是来自模型本身还是来自某个特定的工程 trick。
- 信息损耗:多个并行推理的结果往往只通过简单的“多数投票”筛选,忽略了不同轨迹间思维火花的碰撞。
- 难以迁移:针对特定任务设计的编排层往往非常脆弱,难以在不同模型间通用。
作者由此提出:能不能把这种“思考过程”作为模型的一项可学习技能(Inner Skill)?
2. 核心机制:HEAVYSKILL 的双重演化
HEAVYSKILL 将推理过程解构为两个核心阶段,并引入了迭代机制:
2.1 并行推理与序列审议
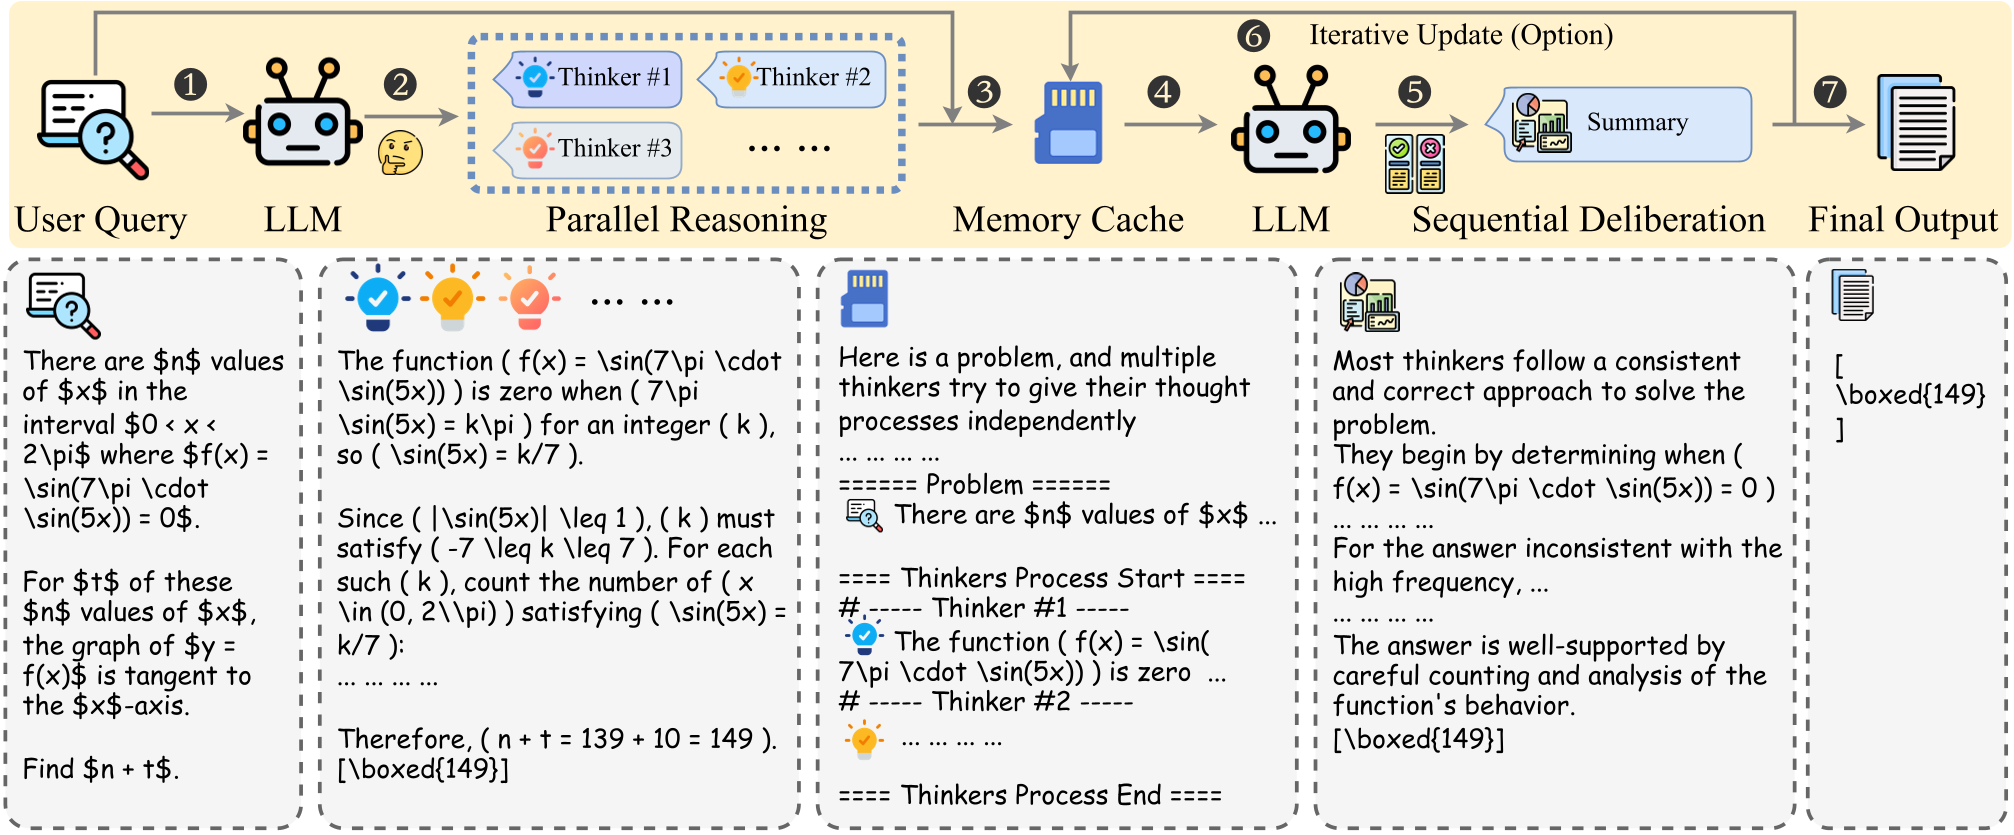
- Parallel Reasoning:给定问题 ,模型生成 个独立的推理轨迹(Trajectories)。这保证了探索的“宽度”。
- Sequential Deliberation:这是本文的灵魂。它不再是简单的投票,而是让模型读取一个序列化存储(Memory Cache),这个缓存中包含了之前所有轨迹的思考过程。审议模型()负责对比各轨迹的差异、修正逻辑错误,最后合成最优答案。
2.2 Readable Skill:一种全新的 Agent 交互方式
HEAVYSKILL 不仅仅是一组 Python 代码,它被写成了一份 “人类可读、模型可执行” 的 Skill 文档。模型读取这份文档后,就知道在什么触发条件下开启“深度思考模式”,如何分配并行任务,以及如何合成结果。这种设计极大提高了框架的通用性和移植性。
3. 实验战绩:突破推理的边界
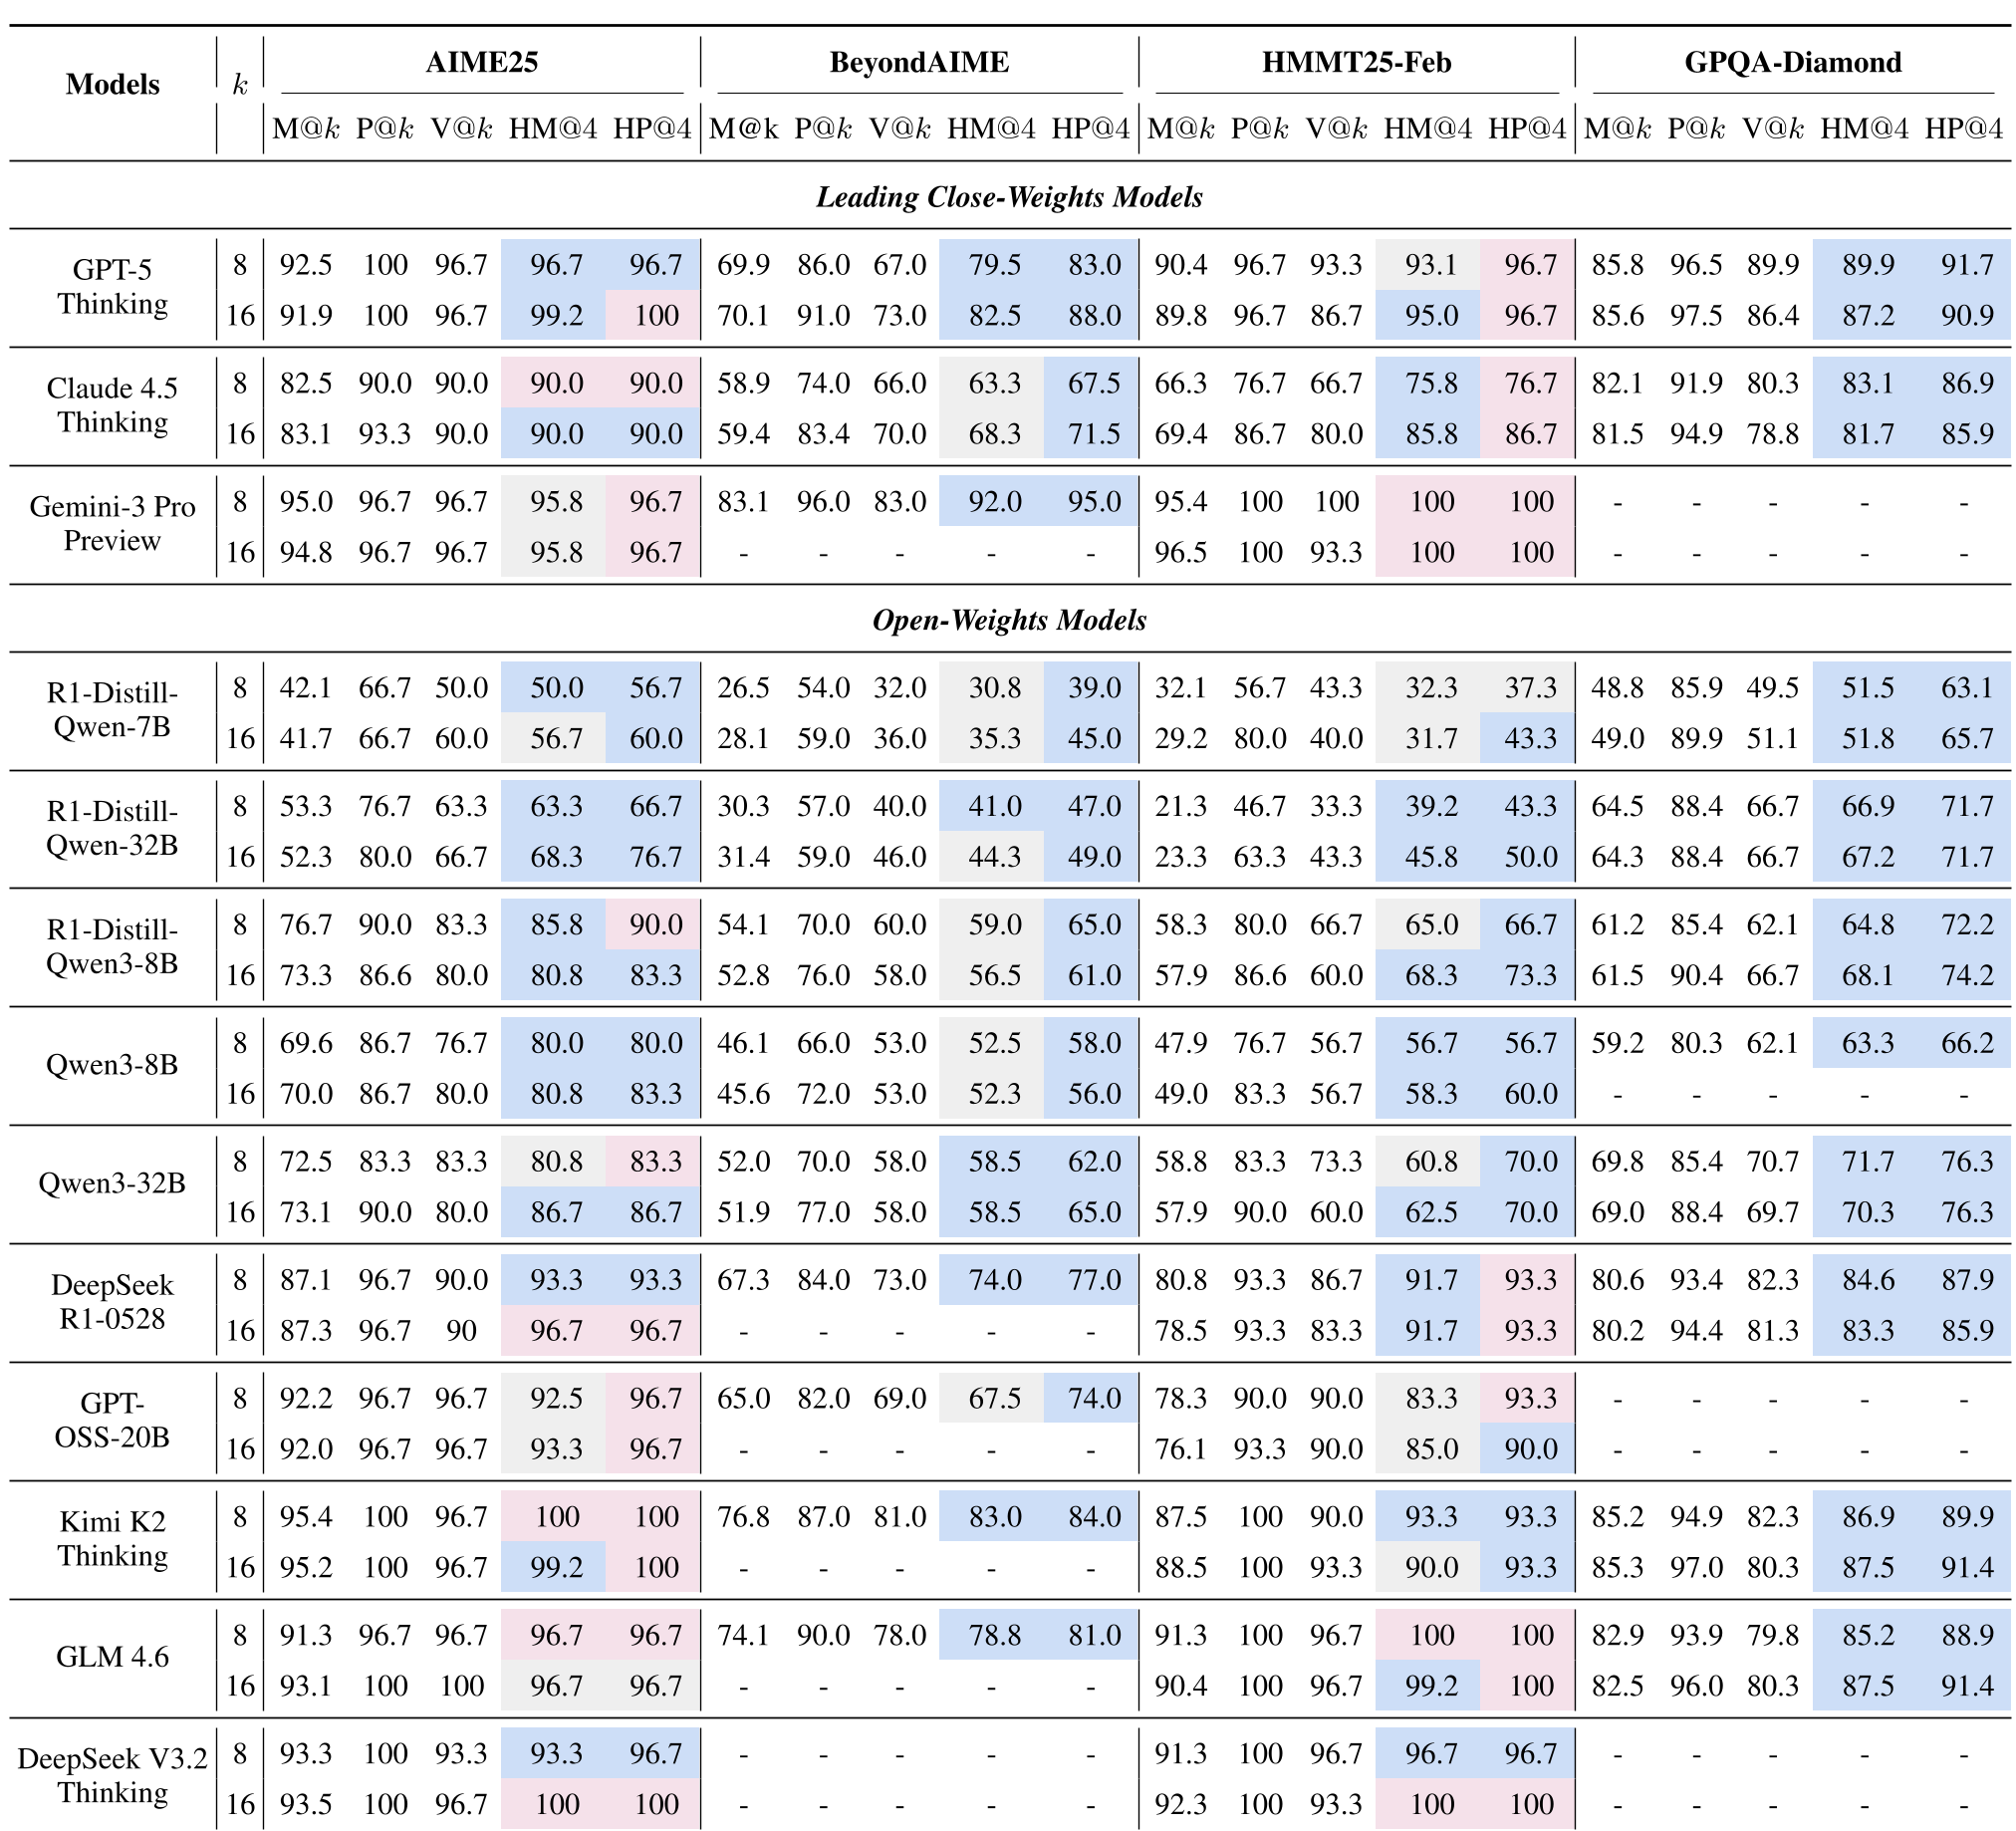
测试涵盖了 AIME25(数学竞赛)、BeyondAIME、GPQA-Diamond 等高难度基准。
- 统治级表现:HEAVYSKILL 的平均准确率(HM@K)稳定超过了 M@K(单次平均)和 V@K(传统投票)。
- 触及天花板:在 GPT-5-Thinking 等强模型上,HM@4 甚至开始逼近 Pass@K 的理论上限(即只要 次采样里有一次对,审议阶段就有极大概率把它找出来)。
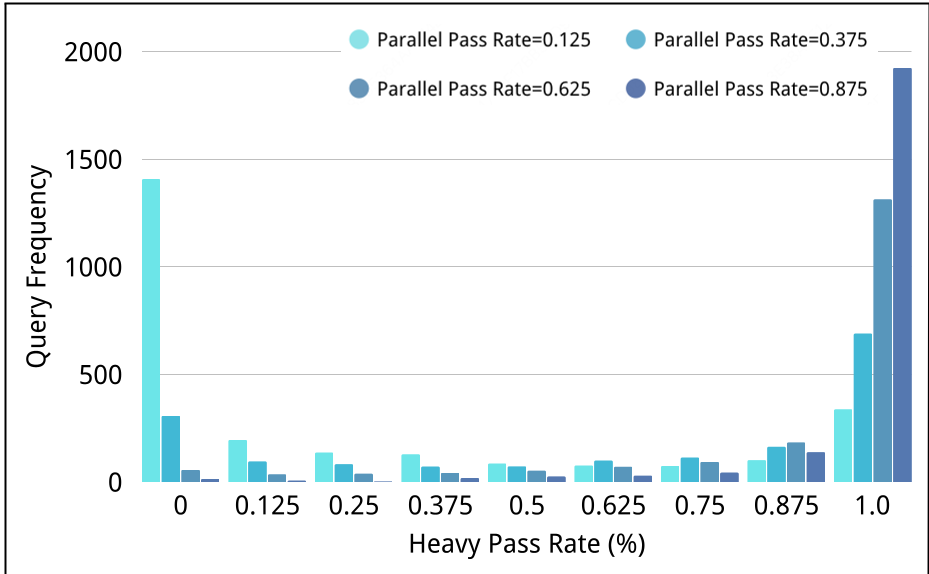
深度洞察:作者发现一个有趣的现象(见下图):即使并行推理阶段的通过率很低(低于 0.5),通过审议(Deliberation),模型依然能从错误的丛林中挖掘出正确的路径,甚至在约 500 个案例中实现了成功的纠错(Rectification)。
4. 进化之路:RLVR 与迭代
论文进一步探讨了如何通过 强化学习(RLVR) 优化这一技能。初步实验证明,在训练前 100 步,HM@4 性能能额外提升约 10%。这证明了“思考深度”和“审议质量”本身就是可以不断被强化的。
5. 局限性与思考
尽管 HEAVYSKILL 在逻辑严密的 STEM 任务上表现封神,但在 Subjective Alignment(主观偏好任务,如 Arena-Hard) 上提升并不明显。这说明,当任务缺乏客观的“验证逻辑”时,多轨迹的平均往往会由于“磨平棱角”而失去风格吸引力。
6. 总结
HEAVYSKILL 的重要意义在于:它证明了 Test-time Scaling 的未来不在于盲目增加采样数量,而在于提升模型对已生成信息的“内部处理能力”。通过将复杂的 Agent 逻辑封装为 Skill,并配合 RLVR 的自我演进,大模型正在逐渐习得如同人类般的“慎思”能力。