
语音情感识别的基石:探索基于 HMM 的时序建模路径
Hidden Markov model-based speech emotion recognition
本文提出了一种基于连续隐马尔可夫模型(HMM)的语音情感识别框架,对比了基于全局统计特征的高斯混合模型(GMM)与基于瞬时特征的连续 HMM 两种方法。在涵盖德语和英语的 5250 个情感样本库上,该系统在 7 种离散情感识别中达到了 86% 以上的准确率,性能超过了人类评判者的表现。
TL;DR
本文由慕尼黑工业大学的研究团队发表,核心在于利用 连续隐马尔可夫模型 (CHMM) 解决语音情感识别问题。通过对比“全局统计静态特征”与“瞬时动态特征”两种路径,系统在 7 种情感的识别任务中达到了 86% 的识别率,成功跨越了人类分类识别(约 80%)的基准水平。
背景定位与动机
在人机交互(HCI)领域,语音不仅是信息的载荷,更是情感的窗口。然而,计算机识别情感面临两大挑战:
- 特征维度的两难:全局特征(如一段话的平均音高)能概括整体氛围但丢失了时序细节;
- 时序建模缺失:情感是动态演化的,简单的静态分类器难以捕捉愤怒或悲伤在语音起伏中的微观特征。
作者的 Insight 在于:既然 HMM 在语音识别(ASR)中能完美处理词语的时序结构,那么它同样应该能建模情感在声学维度上的“进化轨迹”。
核心方法论:从静态统计到动态序列
1. 特征工程的精准打击
作者选择从 Pitch (基频/音高) 和 Energy (能量) 出发,通过 AMDF(平均幅度差函数)快速提取音高曲线。针对两种分类方案,特征设计各异:
- 方案 A (GMM):提取 20 维统计量,重点关注时长(如浊音段的平均时长和标准差),实验发现 Pitch 相关特征的贡献度远高于 Energy。
- 方案 B (CHMM):构建 6 维瞬时向量,公式如下: 这里引入了最高三阶的导数,旨在捕捉能量变化的极细微抖动。
2. 模型架构
注释:作者采用了经典的 Left-Right 模型结构,并使用了 Baum-Welch 重估算法进行训练。每个情感对应一个独立的 HMM 模型,通过 Maximum Likelihood (最大似然) 准则判定输入属于哪种情感。
实验结果与深度观察
实验采用了包含 5250 个样本的情感语料库,涵盖了愤怒、厌恶、恐惧、惊讶、快乐、中立和悲伤。
- 关键表现:瞬时特征法(64 状态)的混淆矩阵显示,快乐(Joy)的识别率最高,达到 93.2%;而厌恶(Disgust)则相对较难识别(76.8%)。
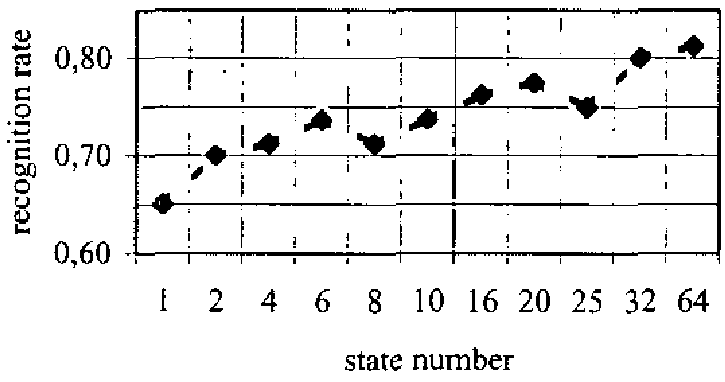
- 状态数的影响:如下图所示,随着 HMM 状态数的增加,模型的建模能力显著提升。这说明情感在声学特征空间中的演变路径是复杂的,需要足够的状态来拟合。
- 人类 vs. 机器:在相同的测试集上,人类评判者的准确率仅为 79.8%-81.3%,机器利用统计学优势在精度上实现了超越,特别是在排除语意干扰的情感识别上。
深度洞察与总结
本工作的核心贡献:
- 验证了 时序复杂度 (Temporal Complexity) 对于语音情感识别的必要性。
- 证明了 低阶描述符 (Low-level Descriptors) 的一阶及高阶导数中蕴含着丰富的非语言特征。
局限性与挑战: 虽然模型在单一说话人(Speaker-dependent)场景下表现惊艳,但当切换到不同说话人(Cross-speaker)时,性能下滑超过 20%。这表明声学情感特征中仍耦合了大量的个人音色信息,如何通过特征解耦(Disentanglement)或自监督特征提取来增强泛化性,是未来 SER 领域的主战场。
对于当今从事大模型(LLM)多模态对齐的研究者来说,这篇论文提醒我们:除了语义(Content),韵律(Prosody)的建模是通向“真正具身智能”不可或缺的一环。