
HII-DPO:通过反事实“诱导攻击”精准根除多模态模型的物体幻觉
HII-DPO: Eliminate Hallucination via Accurate Hallucination-Inducing Counterfactual Images
本文提出了 HII-DPO 框架,旨在解决多模态大模型(VLM)由视觉-语言偏置引发的物体幻觉问题。通过合成幻觉诱导图像(HIIs)并利用 DPO 进行细粒度偏好对齐,该方法在不损害模型通用能力的条件下,将幻觉率最高降低了 38%。
TL;DR
即便画面中空无一物,多模态模型(VLM)也会因为“刻板印象”硬说有个水槽?本文提出了全新的 HII-DPO 框架。它通过主动捕捉并合成那些最能诱导模型“说瞎话”的反事实图像(HIIs),并利用 Direct Preference Optimization (DPO) 进行细粒度纠偏,成功在主流评测榜单上降低了最高 92% 的幻觉率。
1. 痛点:被“常识”绑架的视觉模型
当前的 VLM(如 LLaVA, Qwen-VL)在架构上往往由强大的 LLM 主导,这导致模型产生了一种名为 Language Bias 的副作用:即便视觉编码器没看到东西,LLM 也会根据场景相关性脑补。例如,看到“办公室”就觉得有“键盘”,看到“铁轨”就觉得有“火车”。
现有方法通常使用随机裁剪图像作为负样本,这存在明显的逻辑漏洞:随机破坏图像往往会丢失场景上下文,从而无法触发模型内在的语言偏置。因此,这种对齐是“软弱无力”的。
2. 核心直觉:精准的“诱导式”反事实构建
作者认为,要治好幻觉,必须先暴露幻觉。他们提出了一套 HII Synthesis Pipeline:
- 目标识别:使用 GroundingDINO 找到图像中的特定物体。
- 迭代掩码:不只是覆盖,而是反复迭代确保该物体在视觉上被物理移除(Occlusion)。
- 模型筛选:将生成的 Candidate 喂给模型,只有那些能稳定诱导模型产生幻觉的图像才会被入选为 Hallucination-Inducing Images (HIIs)。
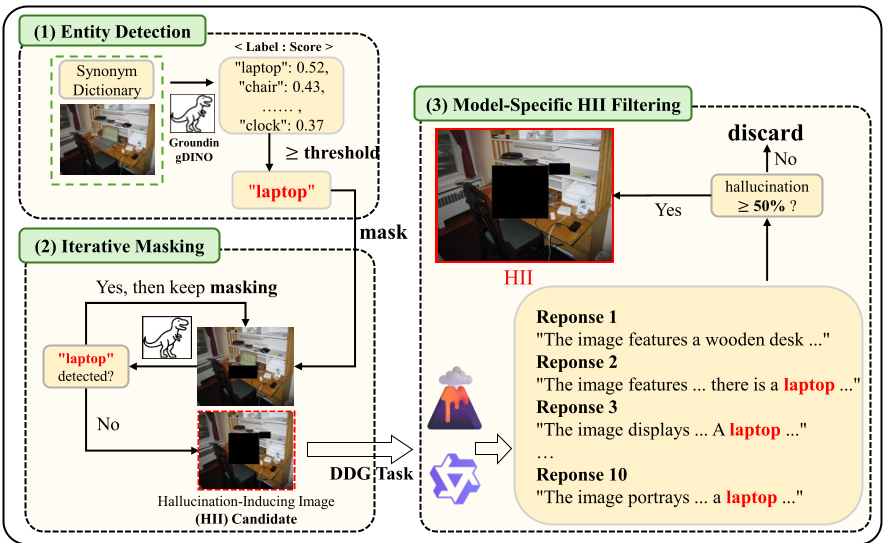
通过这一流程,作者构建了 MOH Benchmark,专门针对这种“场景条件幻觉”进行严苛审计。实验发现,在 Waterfront 场景中,模型幻觉出“船”的概率极高,这验证了场景-物体共现偏置的普遍性。
3. Methodology:HII-DPO 细粒度对齐
在对齐阶段,HII-DPO 采用了 Sentence-by-sentence 的策略。
- Chosen Response:描述真实视觉,明确不提及被移除的物体。
- Rejected Response:包含幻觉物体的描述。
- Prefix Sharing: Chosen 和 Rejected 的回复共用相同的前缀,强制模型将 Loss 集中在发生偏离的那一个句子上。
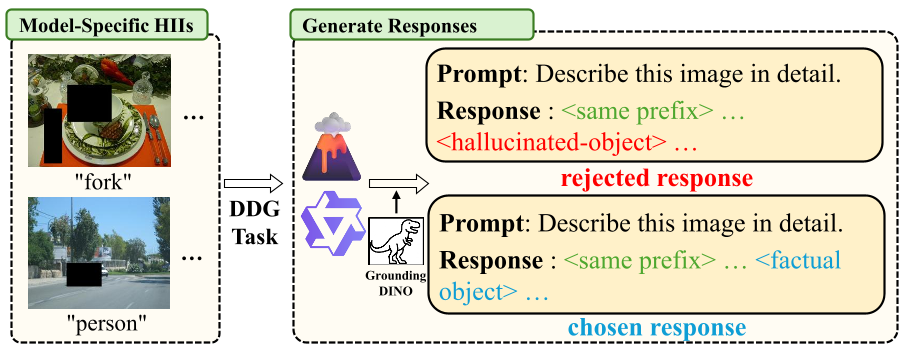
这种做法相比于全句 DPO,极大地避免了噪声干扰,保护了模型原有的事实性知识。
4. 实验战绩:幻觉率的“垂直下降”
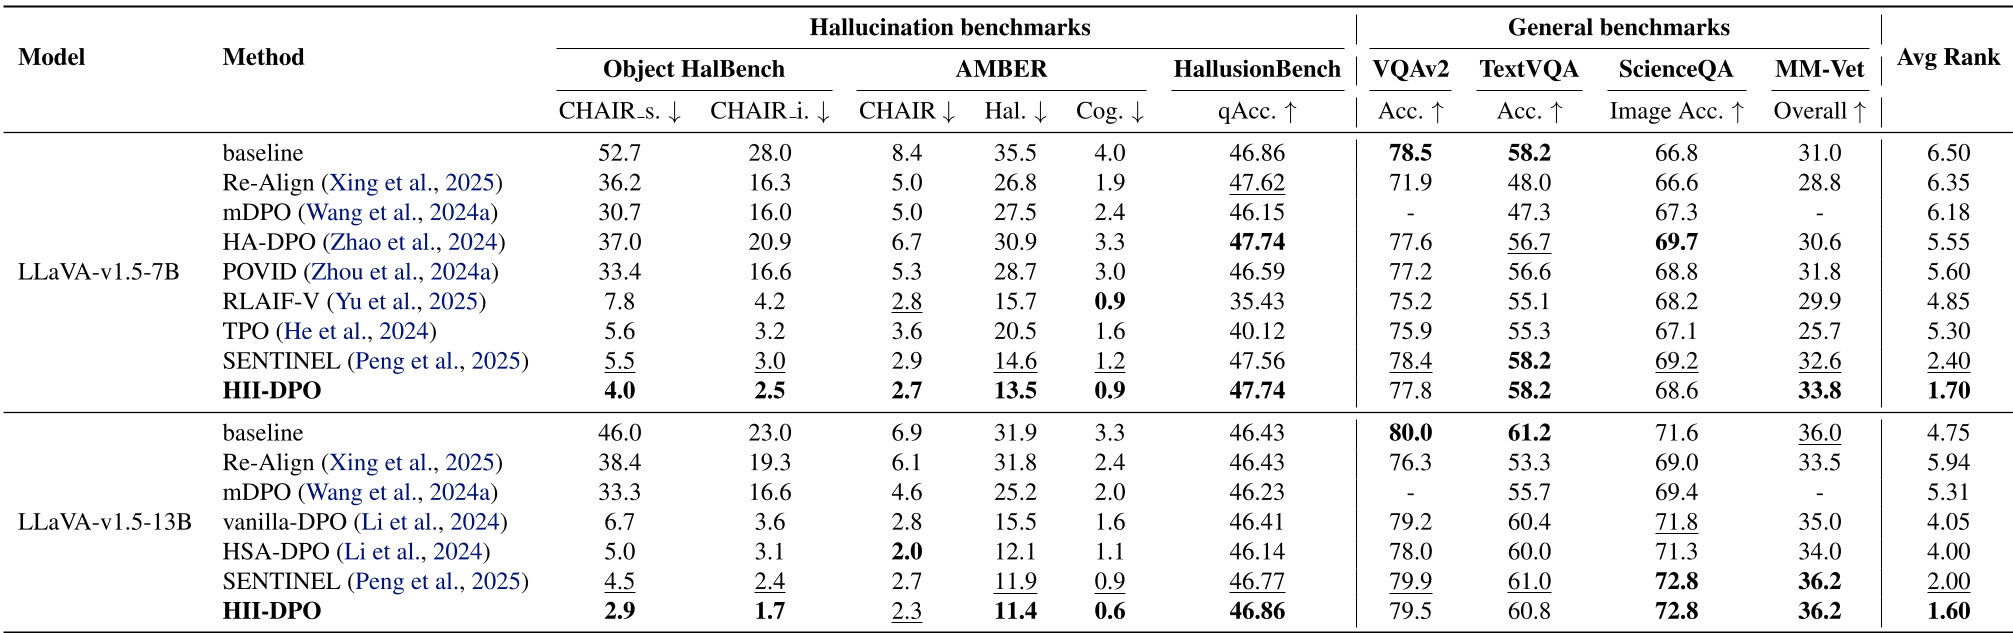
在 LLaVA-1.5-7B 和 13B 上的测试结果令人瞩目:
- 幻觉指标:在 Object HalBench 上,CHAIR_i 指标从 28.0 降至 2.5。
- 通用能力:在 VQAv2 和 ScienceQA 等任务中,性能基本保持持平,甚至略有提升,打破了“去幻觉必降智”的墨菲定律。
在消融实验中,作者证实 迭代掩码(Iterative Masking) 至关重要。单次掩码往往会残留物体的边缘信息,导致训练信号含糊,而迭代掩码确保了视觉上的绝对缺失,从而实现了更清爽的特征解耦。
5. 深度洞察:为什么 VCA(视觉对比对齐)容易翻车?
作者特意讨论了如 mDPO 等 VCA 方法:它们通过改变底图(Negative Image)来让模型学习视觉重要性。但实验发现,VCA 虽然在辨别任务(Is there a sink?)中有效,但在生成任务中会导致模型变得过于保守(变得短促,不敢说话),甚至侵蚀 SFT 阶段学到的内部知识库。HII-DPO 通过保持图像一致、仅改变输出偏好的方式,更温和且精准地解决了问题。
结论
HII-DPO 证明了通过精准构建 “难负样本(Hard Negatives)” 对齐是提升 VLM 可信度的捷径。该方法不仅提供了一个强大的工具集,也为未来自动驾驶、医疗辅助等对事实性要求极高的场景提供了技术底座。
Takeaway: 别再在训练集里加数据了,试着把模型最容易念错的“陷阱”找出来,带它多练几次。