
HRM-Text:1500 美元练出 1B 模型,性能竟直逼 Llama-3 3B?
HRM-Text: Efficient Pretraining Beyond Scaling
本文推出了 HRM-Text,一种基于分层循环架构(HRM)的高效预训练语言模型。通过结合“双时间尺度循环”架构与“任务完成导向”的预训练目标,1B 参数的 HRM-Text 仅需 40B Token 和 1500 美元预算,即可在 MMLU (60.7%) 等多项指标上媲美参数量大 2-7 倍的 SOTA 开源模型(如 Llama 3.2, Qwen 3.5)。
TL;DR
在 LLM 动辄需要数万张 H100 和万亿级 Token 的今天,Sapient Intelligence 与 MIT 的研究者们交出了一份惊艳的答卷:HRM-Text。仅仅使用 16 张 H100 运行不到 2 天(成本约 $1,472),从零预训练出的 1B 模型,在多项推理与理解榜单上,击败了用 100 倍以上数据喂出来的工业界大模型。
背景定位:打破“暴力美学”的统治
目前的主流范式是“更大、更多、更强”的 Scaling Law,但这造成了极大的科研鸿沟。HRM-Text 的核心观点是:既然人脑能高效学习,模型也应该可以。 它通过模仿生物额顶叶回路(Frontoparietal Loop)的功能组织,将计算解耦为战略层和执行层,从而在极小规模的数据下实现了垂直性能的爆发。
核心动机:为什么要改变架构与目标?
- 数据的浪费:标准预训练在预测网页抓取的原始文本,但在实际应用中,我们只需要模型能“根据指令给回复”。HRM-Text 直接转向了 Task-completion Objective(只针对回复计算 Loss)。
- 计算的冗余:Transformer 通过堆叠层数增加深度,但层与层之间参数独立。HRM 采用循环机制(Recurrence),让模型在内部进行“迭代思考”,而不需要无限增加参数量。
架构解析:双时间尺度的魔法
HRM-Text 的核心在于其分层循环架构。模型包含两个核心模块:
- L 模块 (Fast-evolving):负责局部的细粒度精修。
- H 模块 (Slow-evolving):负责维持长期语义和战略上下文。
每次前向传播包含两个大循环(H cycles),每个循环内嵌套 3 次小循环(L updates)。这种设计提供了极强的诱导偏置(Inductive Bias),帮助模型避免陷入局部停滞。
解决稳定性问题:MagicNorm 与 DCA
在递归模型中,梯度爆炸和消失是常客。作者引入了 MagicNorm:
- ** forward 时像 PostNorm**:每步循环结束都有 Norm,约束激活值的方差;
- ** backward 时像 PreNorm**:由于截断梯度(TBPTT),梯度在短序列内流动,保持了恒等路径。
同时,Warmup Deep Credit Assignment (DCA) 随着训练进行动态增加梯度回传的步数,这种“从易到难”的时间课程学习(Temporal Curriculum)极大稳定了早期训练。
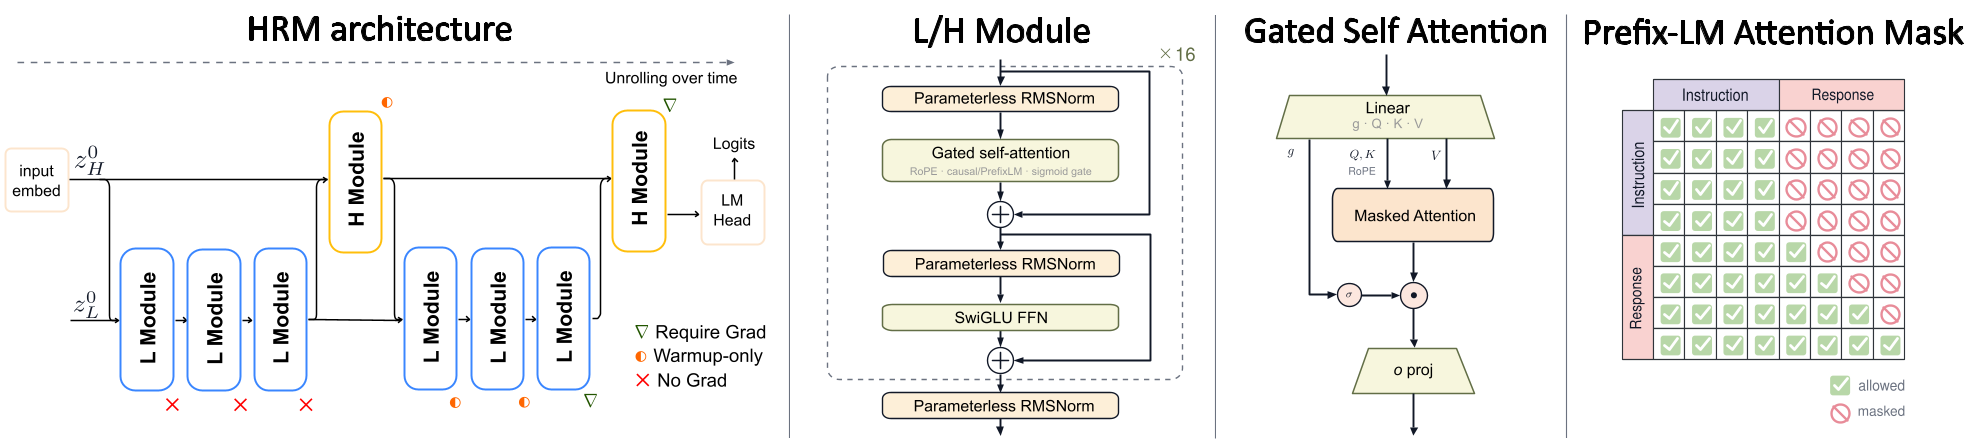 HRM-Text 架构细节:包含双时间尺度循环、MagicNorm 内部结构以及 PrefixLM 掩码。
实验战绩:以小博大的奇迹
在仅 40B Token 的训练下,HRM-Text 1B 展现了恐怖的效率:
- MMLU: 60.7%(超过了 Llama 3.2 3B 的 58.0%)
- GSM8K: 84.5%(推理能力远超参数量更大的开源基线)
- 算力消耗: 相比 Qwen 3.5 2B,估计算力减少了 432 倍。
 HRM-Text 1B 与各大主流开源模型的对比,注意其极其微小的 Token 消耗与算力开销。
深度洞察:有效深度与知识解耦
通过 Logit Lens(逻辑透镜)分析发现,标准 Transformer 在中层就已经稳定了预测分布,深层其实在做“微调”。而 HRM 在深层依然保持着巨大的表征变化(KL Divergence),这意味着它的每一层循环都在进行实质性的逻辑计算。
作者还提出了一个前瞻性的思考:将推理与事实解耦。HRM-Text 证明了小模型可以拥有极强的推理核心,而事实型知识未来可以通过外部检索(RAG)或专门的存储模块来补充,而不需要在预训练阶段死记硬背万亿 Token 的网页。
总结与启示
HRM-Text 为资源受限的学术研究指明了道路:
- 架构与目标的协同设计(Co-design)优于单一参数扩展。
- 循环架构在推理密集型任务中具有天然优势。
- 预训练民主化:只要方法得当,几千块钱也能做出 foundational 级别的研究。
局限性:由于它是一种循环架构,推理时的计算开销虽然稳定,但相比单次前向的 Transformer 仍存在一定的推理延迟(Inference Overhead),未来通过自适应计算(ACT)来动态调整循环步数将是关键。