
人机协同演化:arXiv 论文揭示我们正在“反向训练”学术写作
Human-LLM Coevolution: Evidence from Academic Writing
本文通过对 129 万篇 arXiv 论文摘要的统计分析,揭示了人类与大语言模型(LLM)在学术写作中的“协同演化”现象。研究发现,自 2024 年初 LLM 特征词汇被公开指出后,相关词频显著下降,标志着作者正有意识地修饰 AI 生成内容以规避检测。
TL;DR
一项针对 130 万篇 arXiv 论文摘要的深度研究显示,学者们正经历着一场与 AI 的“协同演化”。当某些词汇(如 delve, pivotal)被公认为 ChatGPT 的“口头禅”后,其使用频率在 2024 年 4 月后迅速崩塌。这表明人类正在有意识地通过修改提示词或手动润色来隐藏 AI 痕迹,这使得现有的机器生成文本检测器正面临前所未有的失效危机。
痛点深挖:被识别的“AI 味”
自从大模型席卷学术界,"delve into the intricate realm" 之类的表达成了识别 AI 生成文本的非官方指标。然而,这种简单的二元对立正在瓦解。现有检测器(MGT Detectors)大多假设 AI 生成的文本具有稳定的统计特征(如低困惑度),但作者指出:人类是具有反馈机制的。 当学术界开始嘲笑特定词汇时,作者会迅速在 Prompt 中加入 Exclude words: delve 这样的指令。这种动态的对抗过程,让传统的检测工具变得捉襟见肘。
核心发现:消失的“特征词”与顽固的“通用词”
作者通过分析 2018-2024 年间的 arXiv 数据,发现了词频变动的有趣分叉:
1. 社交警示效应 (Social Awareness)
如图 1 所示,像 delve、intricate 这种被 Liang 等学者在 2024 年初公开发文“点名”的词汇,在经过一年多的疯涨后,精准地在 2024 年 4 月左右触顶反向。
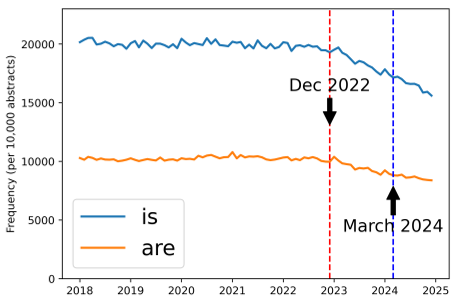 图 1:被“点名”后的特征词频率在 2024 年 4 月后出现显著拐点。
2. 隐蔽渗透 (Subtle Influence)
相比之下,一些相对中性但同样受 ChatGPT 青睐的词汇(如 significant, additionally),其频率依然在稳步上升。作者认为,这是因为这些词“不够显眼”,人类尚未意识到它们也是 AI 指纹的一部分。
方法论详解:如何“逃避”检测
作者利用 GPT-4o-mini 进行了模拟实验,采用两种不同的 Prompt:
- P1 (基础润色):简单要求修改句子。
- P2 (策略润色):要求修改的同时禁用某些 AI 高频词(如 realm, pivotal)。
实验结果(图 4)显示,通过简单的负向约束(P2),模型生成的文本中目标词汇频率大幅下降。最令人担忧的是图 5 的检测结果:SOTA 检测器 Binoculars 对这种“经过人类策略修正”的文本几乎无能为力。
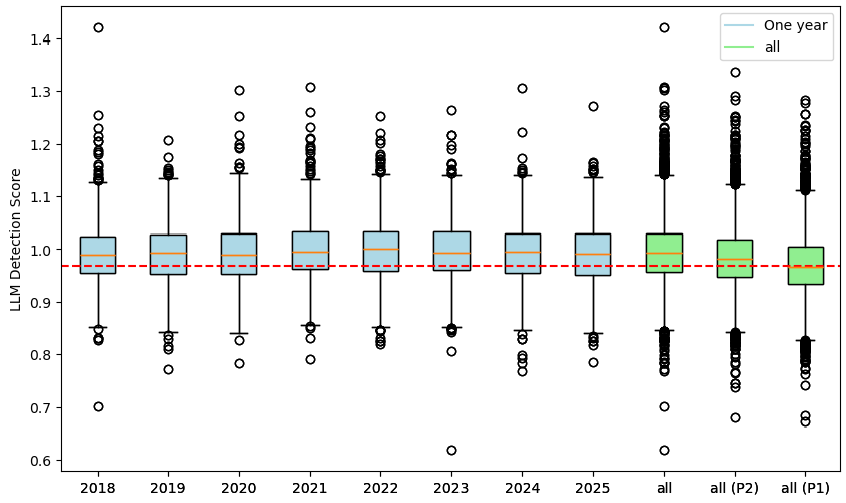 图 5:Binoculars 检测得分在原始摘要与 LLM 修改后的摘要之间没有表现出统计意义上的显著差异。
深度洞察:检测器的终结?
本文不仅是数据的堆砌,它提出了一个深刻的哲学命题:AI 与人类不再是生产者与消费者的关系,而是共生演化的系统。
- 局限性:词频分析虽然在宏观大尺度上有效,但在单篇论文检测(尤其是短文本)中,由于随机性较大,依然难以作为法律级别的证据。
- 未来预测:随着像 Grammarly 这种工具也接入了大模型,纯粹的“人工写作”正在成为历史。未来的挑战不在于“是否用了 AI”,而在于“如何衡量 AI 在创作中的权重”。
结语
学术写作的“AI 化”不可逆转,但人类的“反检测”本能已经跑在了检测器的前面。正如作者所言,也许我们不应再纠结于单篇文本的二分法检测,而应通过更宏观的语料库分析,来审视这场改变人类表达方式的深层变革。