
Hyperloop Transformer:用一半参数挑战 SOTA,边缘侧 LLM 的新曙光
Hyperloop Transformers
本文提出了 Hyperloop Transformer,一种结合了循环层(Looped Transformer)与超连接(Hyper-connections)的新型参数高效架构。该方法通过在循环迭代之间引入轻量级的矩阵值残差流,实现了在参数量减少约 50% 的情况下,性能全面超越同等深度的标准 Transformer 及 mHC 模型。
TL;DR
在 LLM 领域,“越大越好”正逐渐让位于“越精越好”。MIT 的研究者们提出了一种名为 Hyperloop Transformer 的新架构,它将循环层(Looped Layers)与超连接(Hyper-connections)巧妙结合。实验表明,该架构在仅使用 50% 参数 的情况下,性能不仅超越了普通的循环模型,甚至在各种任务上击败了全规模的普通 Transformer。
动机:内存瓶颈与共享参数的尴尬
在云端部署中,我们关注的是推理延迟;但在智能手机等边缘设备,内存容量(RAM) 才是硬约束。虽然 Looped Transformer 允许通过多次迭代同一组参数来模拟深层网络,从而节省内存,但它们通常面临性能折损——因为每一层都必须强制学习完全相同的转换逻辑,缺乏 Inductive Bias 的灵活性。
作者由此产生了一个直觉:如果能在循环之间,以极低的成本增加一些“调节旋钮”,让每一轮循环的表示能有所区别,是否就能弥补性能差距?
核心架构:在中段循环中注入“超能力”
Hyperloop Transformer 并没有全盘推翻 Transformer 结构,而是对残差路径进行了“手术级”改进。其架构分为三个阶段:Begin block、Looped Middle block 和 End block。
1. 矩阵值残差流 (Matrix-valued Residual Stream)
与普通 Transformer 维护一个 维向量残差流不同,Hyperloop 将其扩展为 的矩阵。这意味着模型可以并行处理多个“特征视角”。
2. 精简版超连接 (Simplified Hyper-connections)
在每一轮循环结束后,模型会计算输入相关的投影矩阵 。作者摒弃了前人工作中复杂的 Sinkhorn 归一化,转而使用更为高效的对角矩阵(Diagonal Matrix)。这种设计既保证了参数的高效利用,又提供了足够的非线性变换能力。
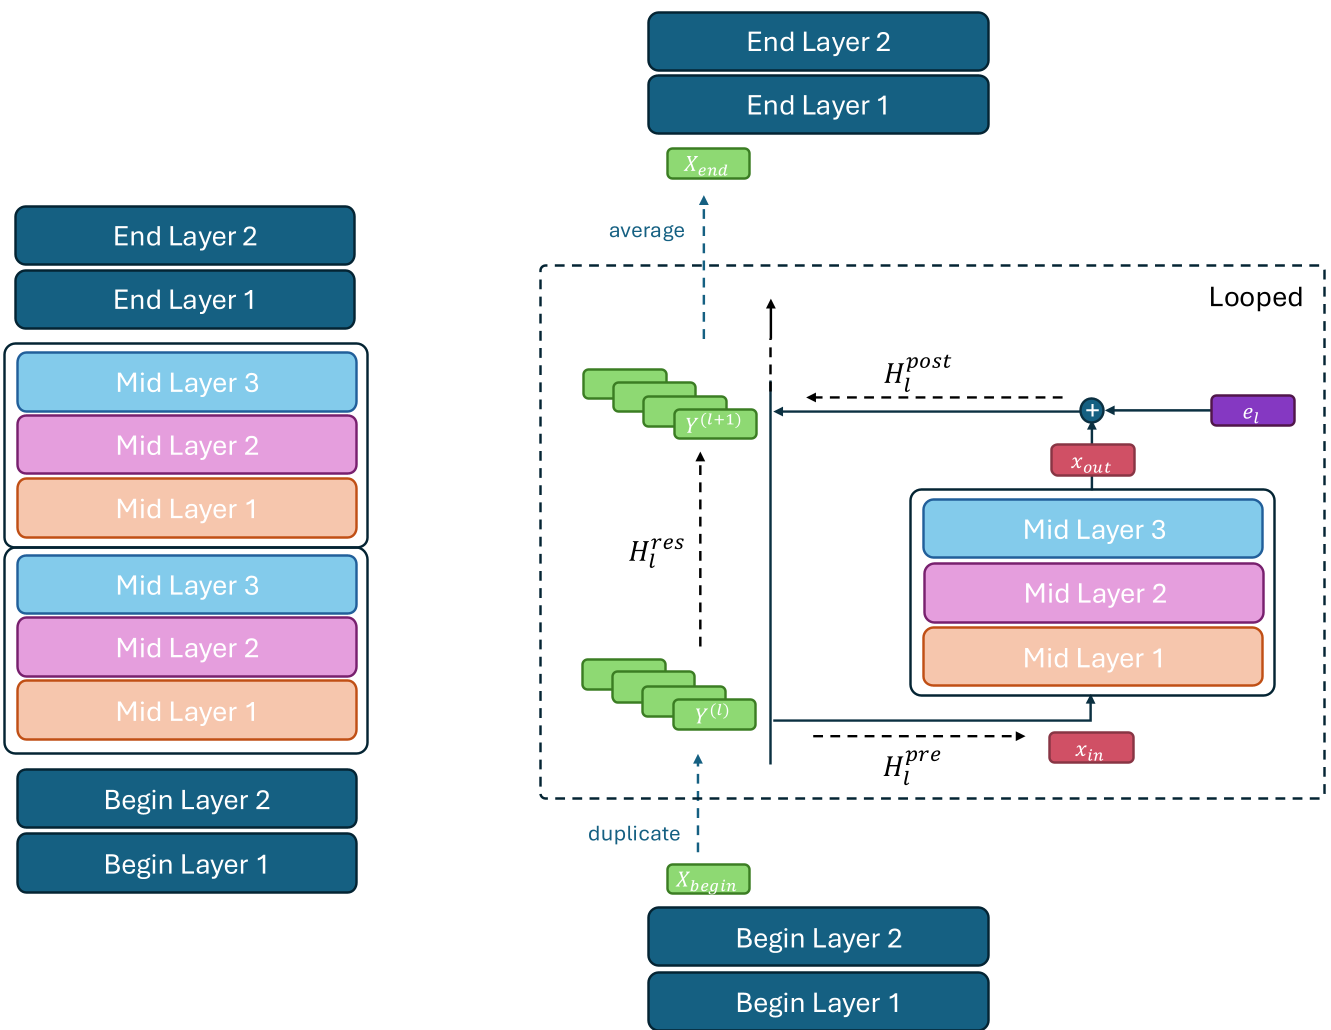 左图为普通循环架构,右图为增加超连接的 Hyperloop 架构,可见其在并行流上的混合机制。
实验结果:小钢炮的逆袭
研究人员在 FineWeb-Edu 数据集上进行了大规模实验,涵盖了从 240M 到 2B 的参数量级。
- 困惑度之王:在 1B 参数级别,Hyperloop 仅需 579M 参数就跑出了 9.65 的困惑度,显著优于 991M 参数的标准 Transformer(10.19)。
- 量化韧性:在 INT4 量化实验中,普通的循环模型性能下降严重,但 Hyperloop 表现出极强的鲁棒性,甚至在量化后依然领先。
- 训练效率:得益于简化的算子,Hyperloop 的训练吞吐量(Tokens/s)几乎与普通 Transformer 持平,克服了以往复杂变体计算开销大的顽疾。
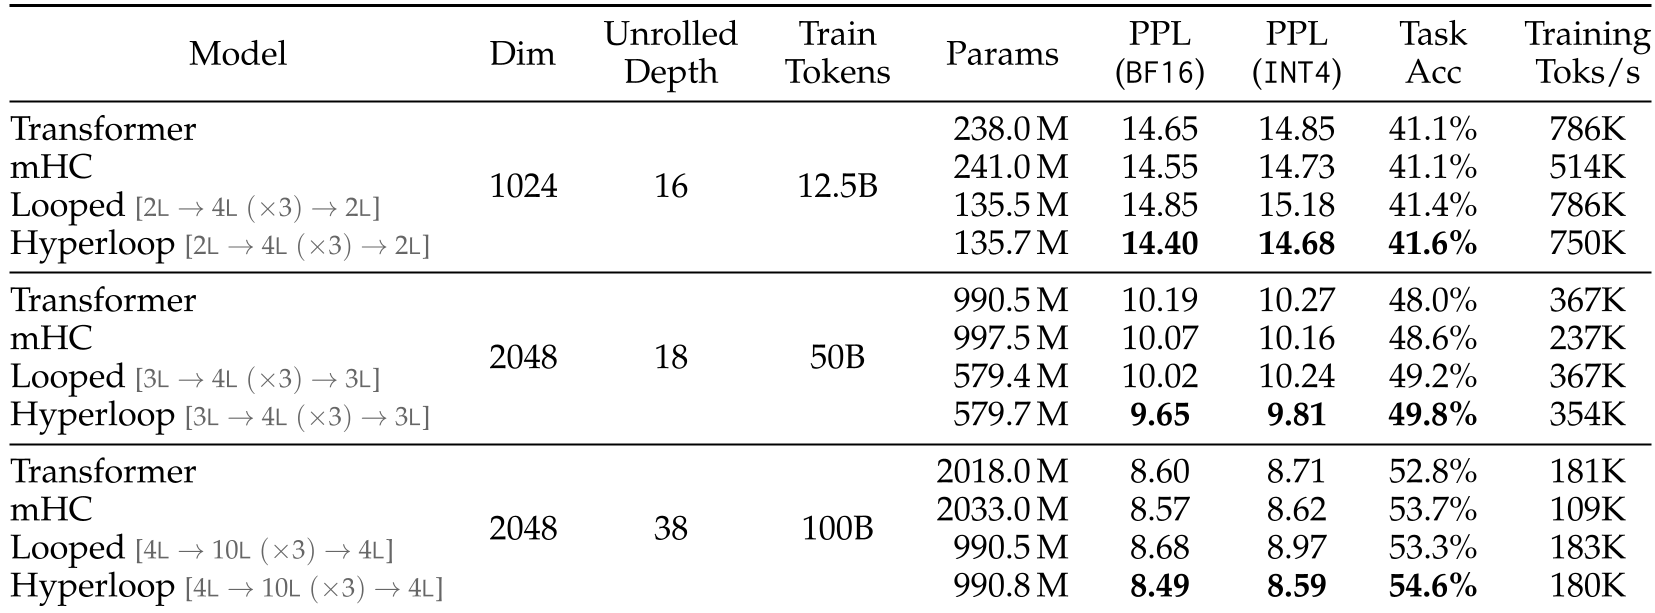 表 1 展示了 Hyperloop 在 BF16 和 INT4 精度下,相比各类基准在 PPL 和下游任务上的全面领先。
深度洞察:为什么它更强?
作者通过 Logit Lens(逻辑透镜)分析发现,Hyperloop 的中间层表示与词表空间的对齐度更高。这不仅意味着模型推理逻辑更清晰,还暗示了一个潜在优势:它非常适合早停推理(Early-exit)。
此外,余弦相似度分析显示,Hyperloop 的各层表示之间比普通循环模型具有更低的重复性。这证明了超连接确实起到了作用,让“重复使用”的参数在每一轮迭代中焕发了“不一样的生机”。
总结与建议
Hyperloop Transformer 证明了:追求模型的参数效率(Parameter Efficiency)不一定要牺牲模型容量。通过对残差连接的一点点改变,我们就能显著提升共享参数的表达上限。
局限性:目前实验尚未触及 10B 以上的超大规模参数。在大模型时代,这种“套娃”式的设计是否能延续 Scaling Laws 仍需进一步验证。但对于想要在手机、电脑端本地运行 LLM 的开发者来说,Hyperloop 无疑是目前最值得关注的架构方案之一。