
SR3:扩散模型在超分辨率领域的逆袭,让人类难辨真伪
Image Super-Resolution Via Iterative Refinement
本文提出了 SR3,一种基于迭代细化(Iterative Refinement)的去噪扩散概率模型(DDPM)图像超分辨率方法。通过将低分辨率图像作为条件输入,SR3 在人脸和自然图像的 4x 到 8x 超分辨率任务中表现卓越,尤其在 8x 人脸合成中达到了接近 50% 的人类受骗率(Fool Rate)。
TL;DR
传统的超分辨率(Super-Resolution)方法常在“模糊(回归法)”与“伪影(GAN法)”之间徘徊。Google Research 推出的 SR3 (Super-Resolution via Repeated Refinement) 彻底改变了游戏规则。它利用去噪扩散概率模型(DDPM),通过上千次的细微迭代,将随机噪声“炼”成细腻的高清大图。在 8 倍人脸放大实验中,受试者几乎无法分辨 SR3 生成的结果与真实照片的区别。
痛点深挖:为何超分辨率这么难?
超分辨率本质是一个病态逆问题(Ill-posed Inverse Problem)。一张 16x16 的模糊图片,对应的可能是无数张清晰的人脸。
- 回归模型(Regression):如果使用 MSE 损失函数,模型为了降低平均误差,会选择输出所有可能结果的“平均值”,导致图像在发丝、纹理处极度模糊。
- 生成对抗网络(GAN):虽然能画出细节,但极其叛逆。训练中容易出现模式崩塌,或者生成一个虽然清晰但“根本不是本人”的面孔。
SR3 的核心动机在于:能否通过一个稳定的随机过程,既保留生成模型的细节表现力,又通过强制条件约束保证结果的真实可靠?
方法论详解:迭代细化的艺术
SR3 的核心机制是条件去噪扩散。它将高分辨率图像 y 的生成过程分解为一系列微小的去噪步骤。
1. 扩散与反向过程
- 正向过程:在清晰图像上不断加入高斯噪声,直到它变成纯噪声。
- 反向过程(SR3 核心):从噪声 开始,模型 根据当前的噪声水平和低分辨率条件图像 x,预测并剔除噪声。
2. 模型架构
SR3 采用了改进的 U-Net 结构。关键的创新点在于:
- 简单有效的 Condition:将低分辨率图像通过双三次插值(Bicubic)放大到目标尺寸,直接在通道维度平铺并与当前图像拼接。
- 噪声水平感知:将噪声方差 作为输入传给模型,让模型能够自适应不同阶段的去噪需求。
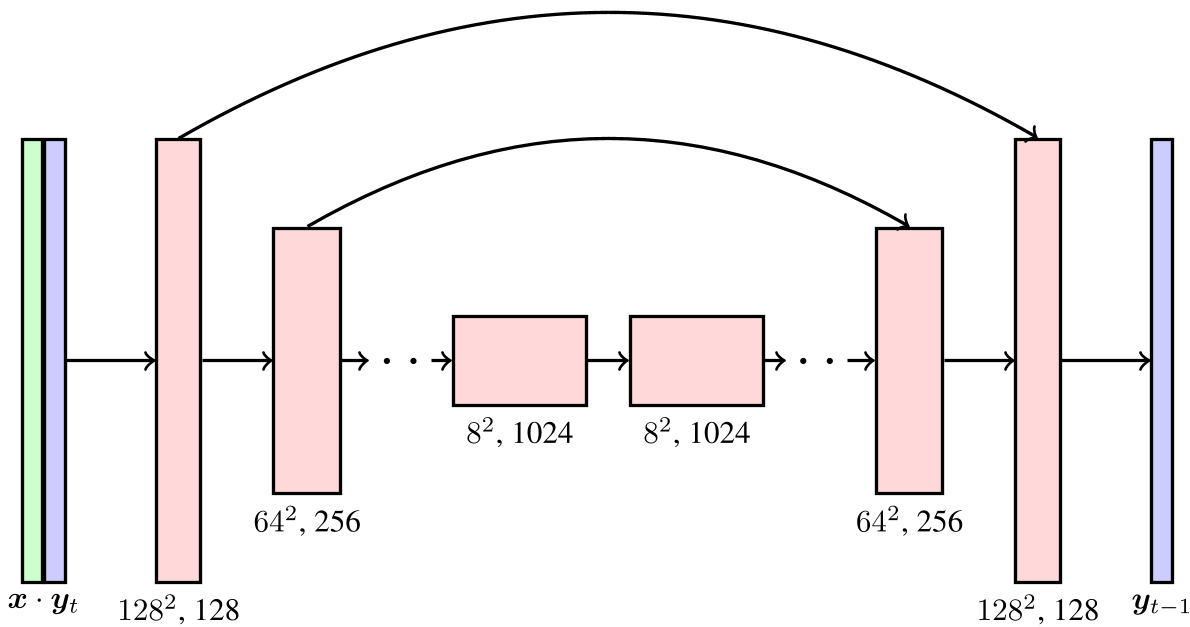 图:SR3 采用的级联 U-Net 架构与条件输入机制
实验与结果:刷新数字与感官
SR3 的强大在于其生成的细节具有极高的感官保真度。
- 人类评估(2AFC):在 Task-1(给出低分辨率参考,选出更好的高清图)中,SR3 的受骗率达到了惊人的 47.4%,这在统计学上意味着它生成的图像几乎等同于真实场景(50% 为理论极限)。
- 一致性(Consistency):SR3 的下采样一致性 MSE 仅为 2.68,远低于 PULSE (161.1) 和 FSRGAN (33.8),这说明它不仅画得好,而且画得准。
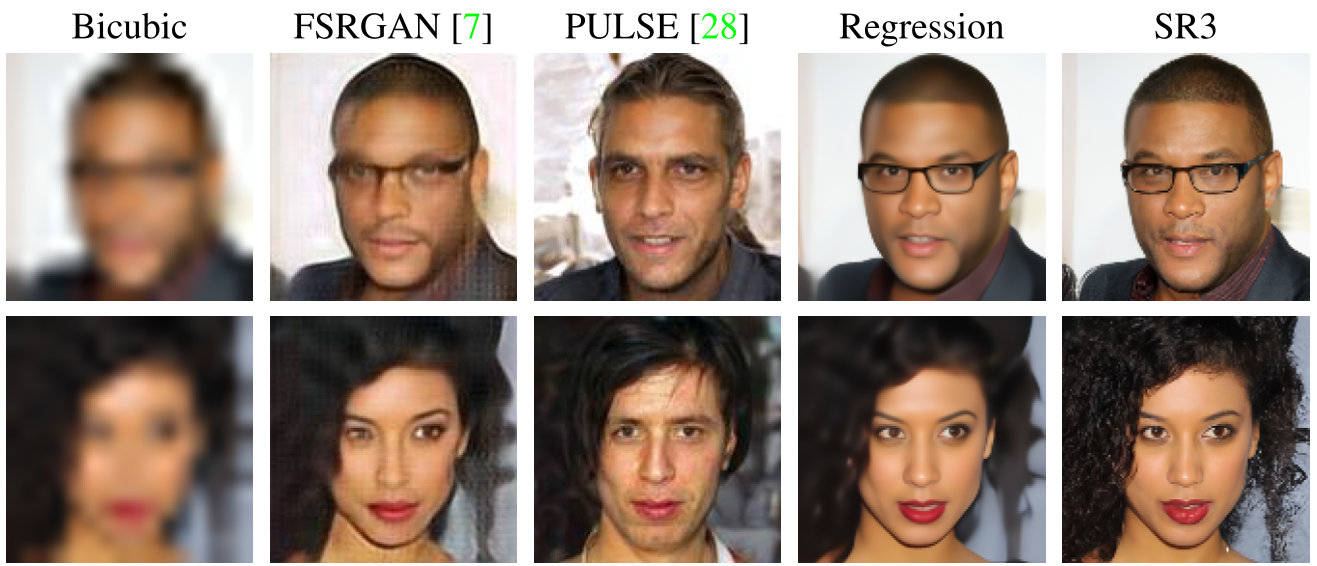 图:不同方法在 16x16 → 128x128 任务上的对比。可以看到 SR3 (最右) 在发丝和面部特征上比 GAN 更加自然。
级联生成:走向 1024x1024
SR3 展现了强大的可扩展性。通过级联(Cascading),研究者将 64x64 的无条件生成模型与两个 4x 取样的 SR3 串联,直接生成了高质量的 1024x1024 巨幅人脸。
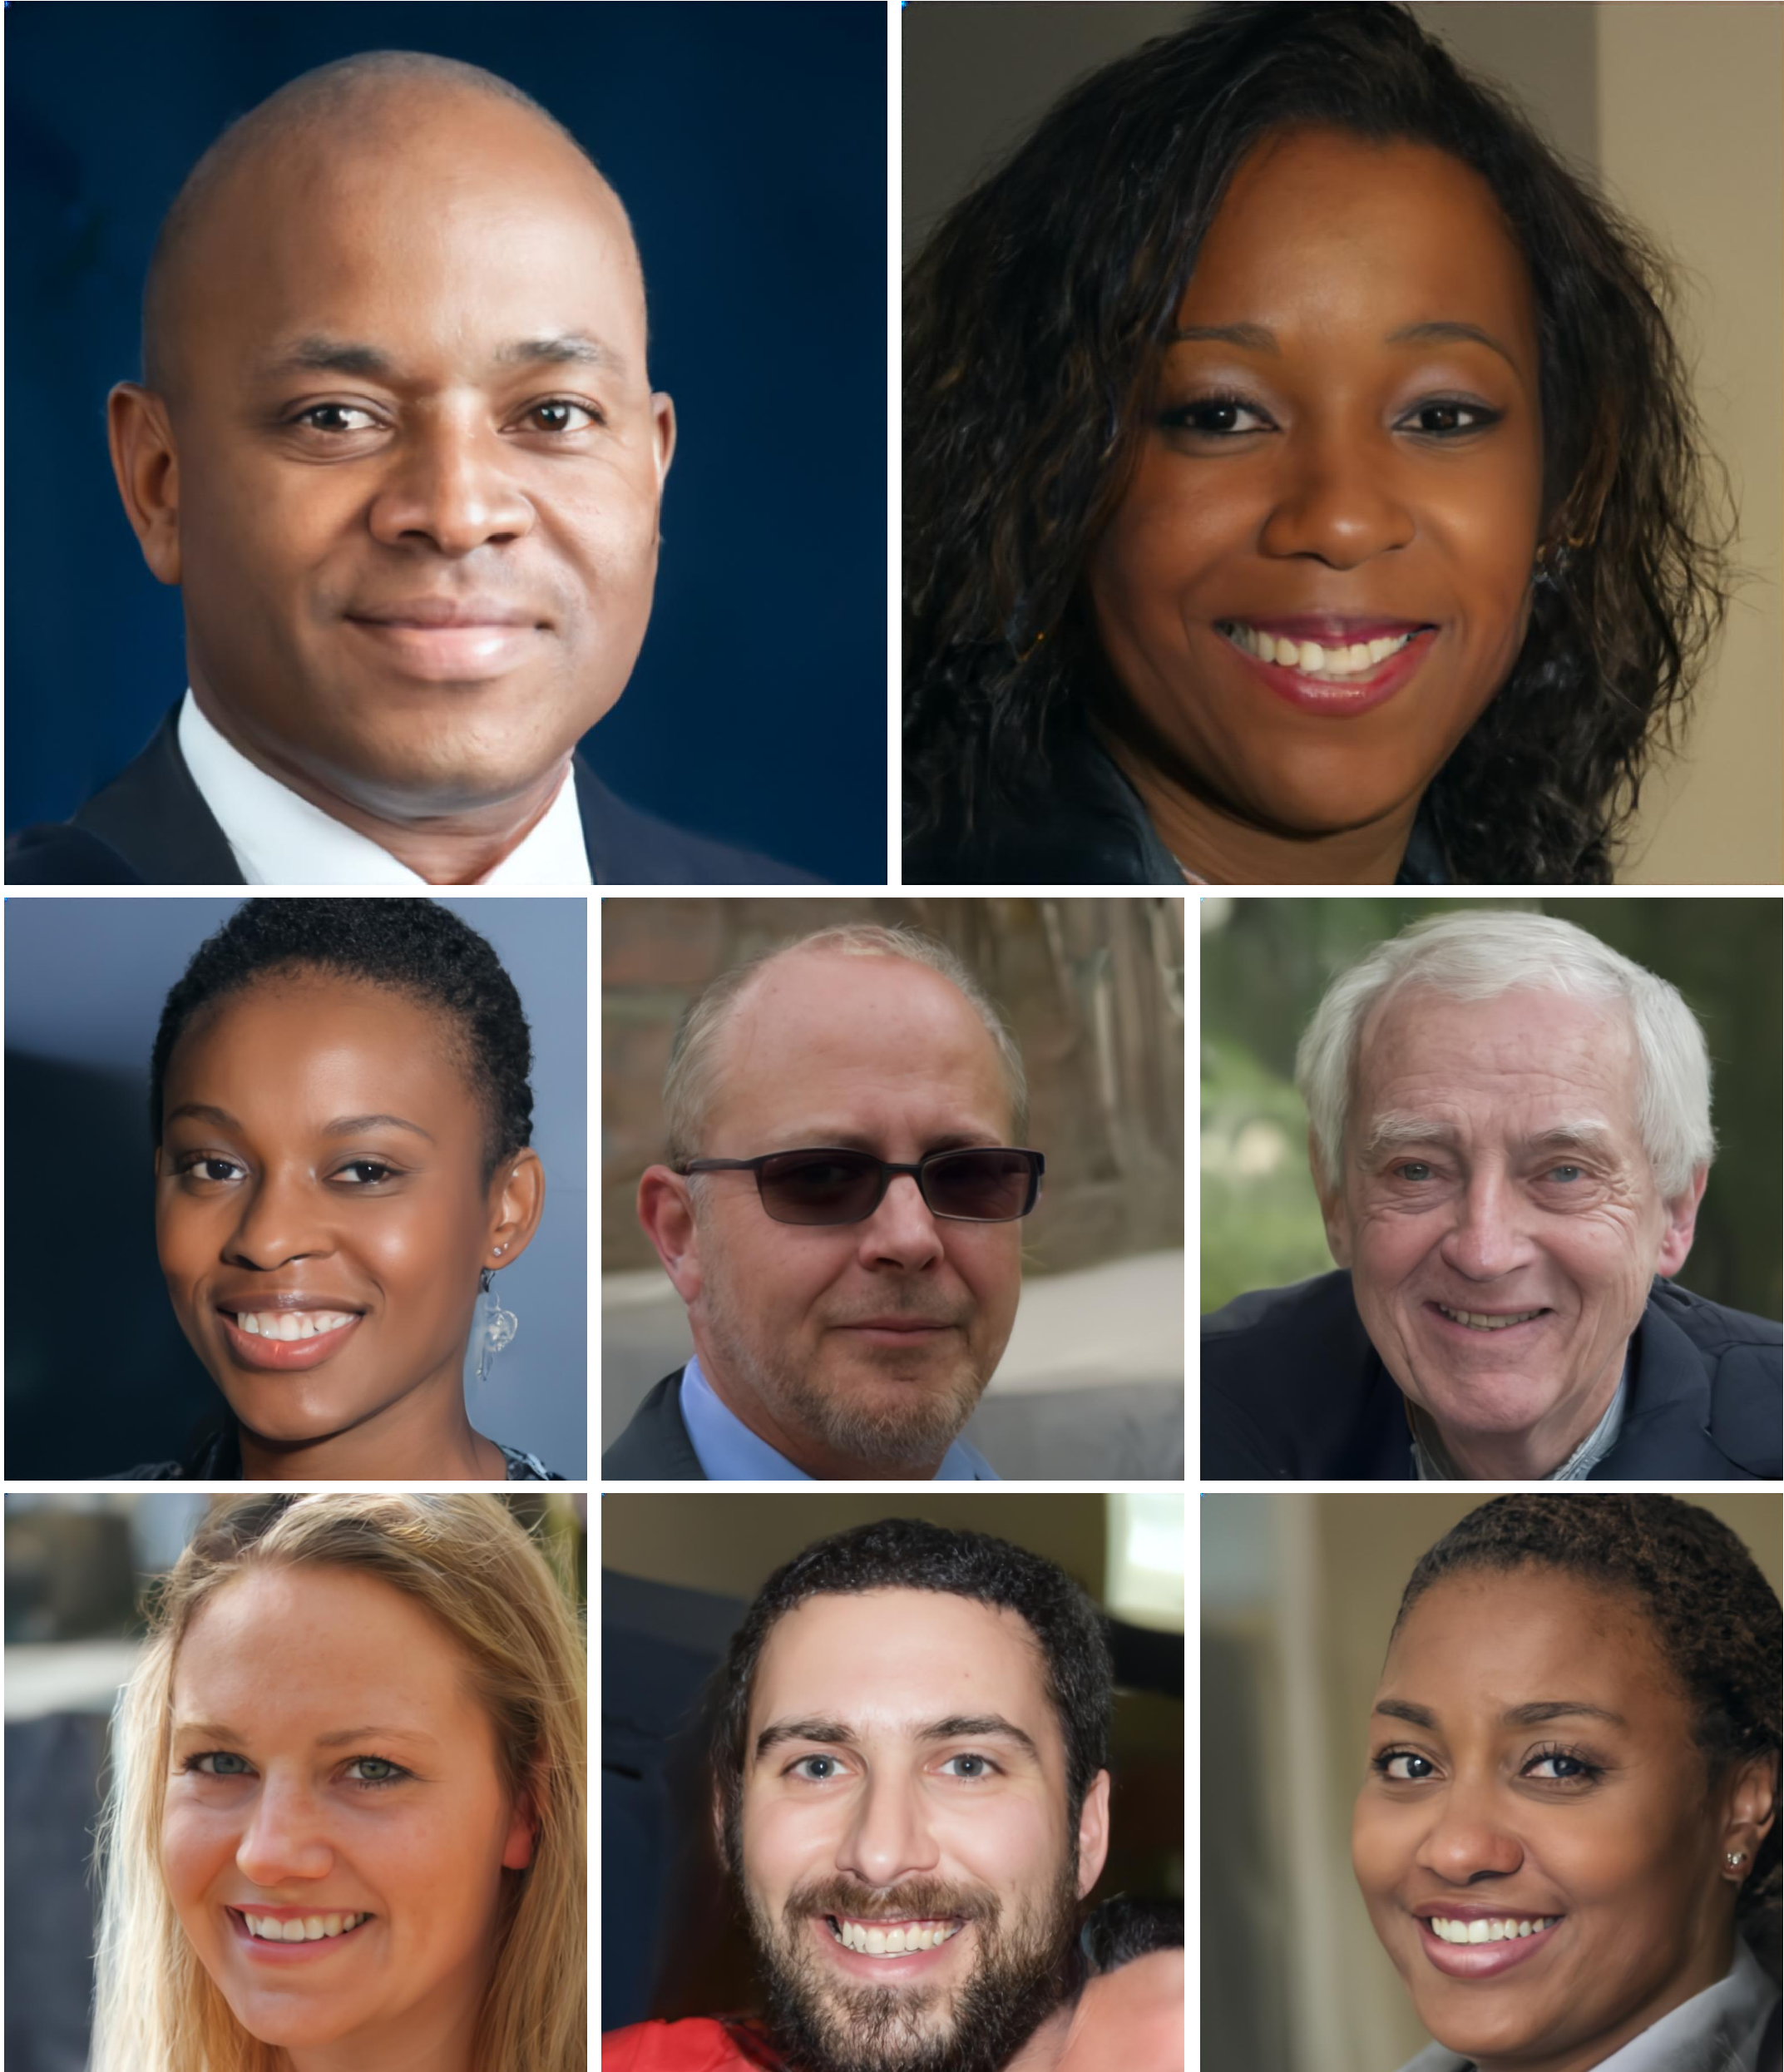 图:通过级联生成的 1024 高清人脸,肤质和毛孔细节清晰可见。
深度洞察与总结
为什么 SR3 有效?
- Loss 的优势:SR3 最小化的是一个定义清晰的 L1/L2 损失,避免了 GAN 训练中的博弈和不稳定。
- 分布覆盖:扩散模型的似然目标函数鼓励模型覆盖数据的全模式,减少了模式丢失。
局限性
- 速度瓶颈:由于需要 T 次(文中设为 2000,推理优化后为 100)迭代,SR3 的生成速度远慢于一阶段的回归模型或 GAN。
- 潜在偏见:模型可能会“平滑”掉一些特征,如痣、细小皱纹或饰品,这是生成模型共有的社会道德风险。
结论
SR3 的出现标志着扩散模型正式进入条件图像生成的主战场。它不仅在学术上提供了高质量的 SOTA 基准,更为电影修复、医学成像等对“一致性”要求极高的领域指明了技术方向。