
IFM 框架:模仿与微调的协同,开启四足机器人对称运动的新范式
Imitating and Finetuning Model Predictive Control for Robust and Symmetric Quadrupedal Locomotion
本文提出了 IFM (Imitating and Finetuning MPC) 框架,一种结合了模型预测控制 (MPC) 与强化学习 (RL) 的四足机器人控制方法。通过 DAgger 算法模仿基于 DDP 的专家 MPC,并利用 PPO 在复杂地形上进行微调,实现了在 Mini Cheetah 机器人上 SOTA 级的鲁棒、对称且节能的运动表现。
TL;DR
在四足机器人领域,模型预测控制(MPC)的“规整”与强化学习(RL)的“灵活”如何兼得?韩国科学技术院(KAIST)的研究团队提出了 IFM (Imitating and Finetuning MPC) 框架。该框架通过先模仿专家控制器的行为,再在复杂地形上进行 RL 微调,使机器人不仅能跨越 7.5cm 的障碍,还能保持极其优美的对称步态,同时将计算开销降低了 90% 以上。
痛点深挖:数学完美的局限与奖励工程的黑盒
传统的四足机器人控制面临两难:
- MPC 的局限性:依赖于单刚体(SRBD)等简化模型。在面对传送带、极滑地面时,固定的步态序列(Gait Sequence)和 Raibert 启发式规则往往失效。
- 原生 RL 的尴尬:虽然鲁棒性强,但输出的动力学行为往往极其“难看”——步态不对称、能量消耗大(CoT 高),甚至产生无法在真实硬件上部署的抖动。为了让 RL 走得像动物,研究者不得不编写长达十余项的复杂奖励函数。
Methodology:从模仿到超越
IFM 框架的设计哲学非常清晰:用 MPC 指明方向,用 RL 补齐短板。
第一步:构建 DDP 专家
作者首先使用差异动态规划(DDP)构建了一个专家策略 。虽然这个专家无法实时运行(耗时 12ms+),但它能产生符合物理逻辑的转矩。
第二步:知识蒸馏与 DAgger
为了让控制器变快且可训练,研究者利用 DAgger (Dataset Aggregation) 将大规模 MPC 数据注入神经策略。这不仅解决了行为克隆(Behavior Cloning)中的分布漂移问题,更重要的是实现了动作空间转换:将转矩指令转换为关节角增量,这对硬件稳定性至关重要。
第三步:受限探索的微调
最后在多种地形(粗糙地面、台阶、滑桥)进行 PPO 微调。为了不破坏模仿得来的优雅步态,作者引入了受限探索(Constrained Exploration):通过较小的初始标准差和学习率,让模型在保留“专家风格”的基础上学习克服复杂障碍。
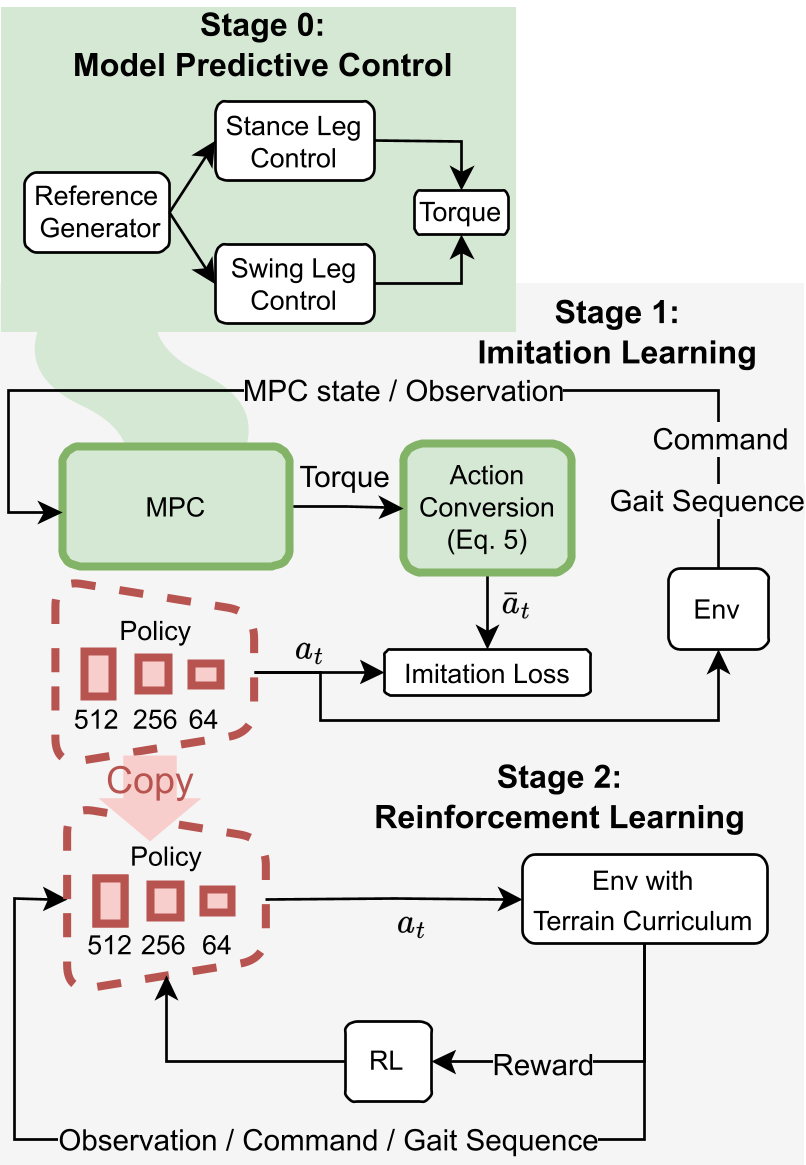 图 1:IFM 框架概览,从 MPC 专家到模仿策略,再到 RL 微调的完整闭环。
实验结果:优雅与强悍并存
实验在著名的 Mini Cheetah 机器人上展开,结果令人印象深刻:
- 计算效率:推理时间从 MPC 的 12.38ms 压缩至 0.001s 以内,为更复杂的视觉计算留出了空间。
- 运动质量:通过相位图(Phase-Portrait)分析,IFM 的步态对称性极高,两条腿的轨迹几乎完全重合(见图 8),而原生 RL 的相位图则杂乱无章。
- 极高鲁棒性:面对 7.5cm 的台阶,传统 MPC 方案直接失效,而 IFM 凭借在微调阶段习得的“足端捕捉反射”实现了 90% 的通过率。
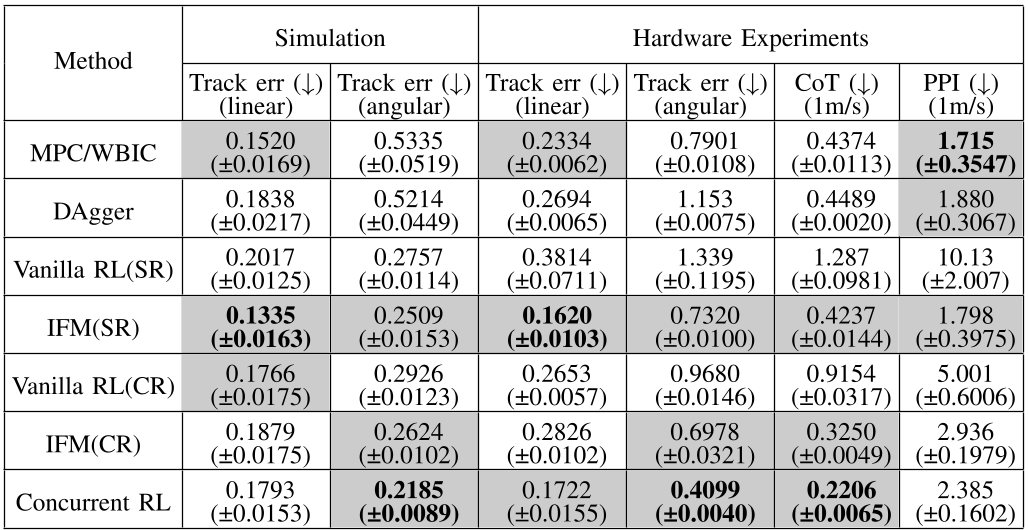 表 1:不同方法在追踪误差(Tracking Error)和输送成本(CoT)上的对比,IFM 在多项关键指标中处于 SOTA 位次。
深度洞察
IFM 的成功揭示了具身智能的一个核心趋势:不要试图强迫 RL 处理所有的物理约束。 过往的研究试图完全抛弃运动学模型,结果导致生成的运动缺乏“美感”且难以调校。IFM 证明了,将经典控制理论作为 RL 的先验(Prior),可以极大地减轻奖励工程的负担,同时显著提升 Sim-to-Real 的成功率。
总结与展望
IFM 展示了一个兼顾效率、运动风格和鲁棒性的平衡点。作者指出,未来的研究方向将是引入视觉感知,使机器人能根据地形主动调整,而不仅仅是依靠触觉反馈。对于研究长序列控制任务的开发者来说,这种“模仿-微调”的范式极具借鉴价值。
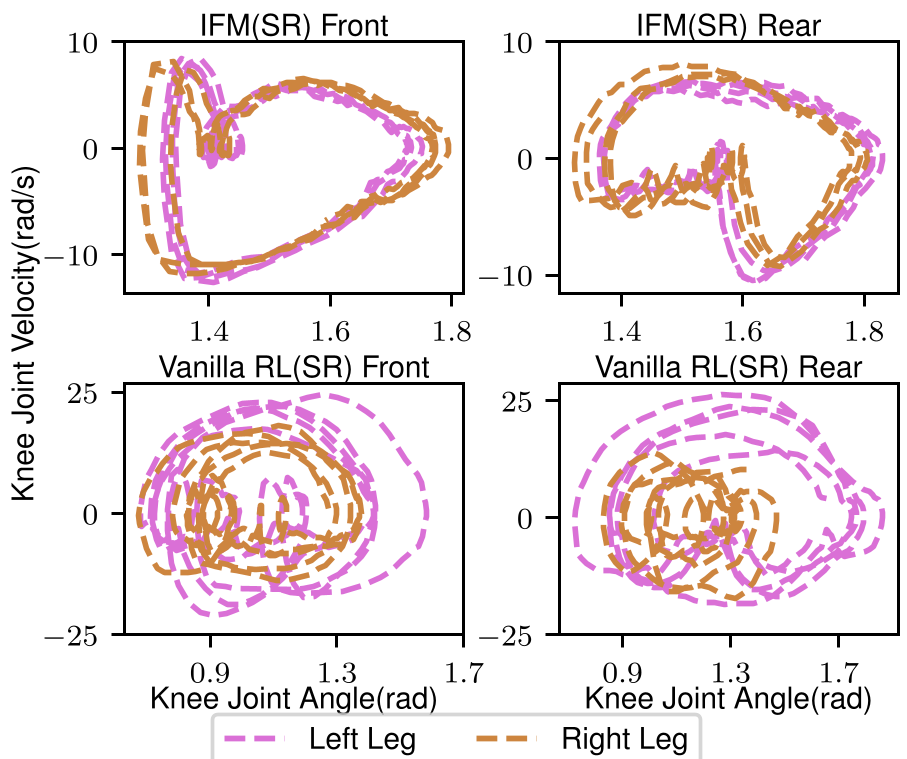 图 2:硬件测试下的膝关节相位图,直观展现了 IFM 生成步态的周期性与对称性。