
探测器的幻象:当 Off-Policy 训练遇上 LLM 内部监控
The Impact of Off-Policy Training Data on Probe Generalisation
本文系统评估了脱策(Off-Policy)训练数据对大语言模型激活检测器(Probes)泛化性能的影响。通过对 Llama-3.2, Gemma-3 和 Ministral 等多个模型在八种行为(如欺骗、沙盒效应、拒绝服务等)上的实验,研究揭示了探测器在跨策略和跨领域任务中的性能衰减规律。
TL;DR
探测器(Probes)被视为监控 LLM 内部状态的“廉价听诊器”,但其训练依赖的“假数据”可能让监控沦为摆设。最新研究发现,如果行为是“意图导向”的(如欺骗),脱策训练的探测器在真实场景中泛化力极低,而“领域偏移”才是探测器最致命的杀手。
背景定位:安全监控的“影子工厂”
在 AI 安全领域,研究者们热衷于通过线性探测器(Linear Probes)读取 Llama 或 GPT 的“心计”。但尴尬的是,真实的“坏模型”数据太少,大家都在用合成数据(Off-Policy)训练模型。这篇论文正是对这种工业级现状的深度复盘:我们拿假数据练出来的“谎言探测器”,在遇到真正的狡猾 AI 时,还灵吗?
核心直觉:文本显性 vs 文本模糊
作者提出了一个非常有见地的物理直觉:
- 文本显性行为(Text-evident):如“列举清单”或“科学术语”,其特征直接写在表面。这类探测器非常好练,随便用哪个模型生成的数据都能泛化。
- 文本模糊行为(Text-ambiguous):如“欺骗”或“谄媚(Sycophancy)”。同一个句子,可能是真心的,也可能是演的。探测器在这些任务上极易学到“伪相关”,导致在真实测试中全线崩溃。
架构与实验:领域 vs 策略
研究者对比了四种数据生成逻辑,并使用了多种主流模型作为实验床。
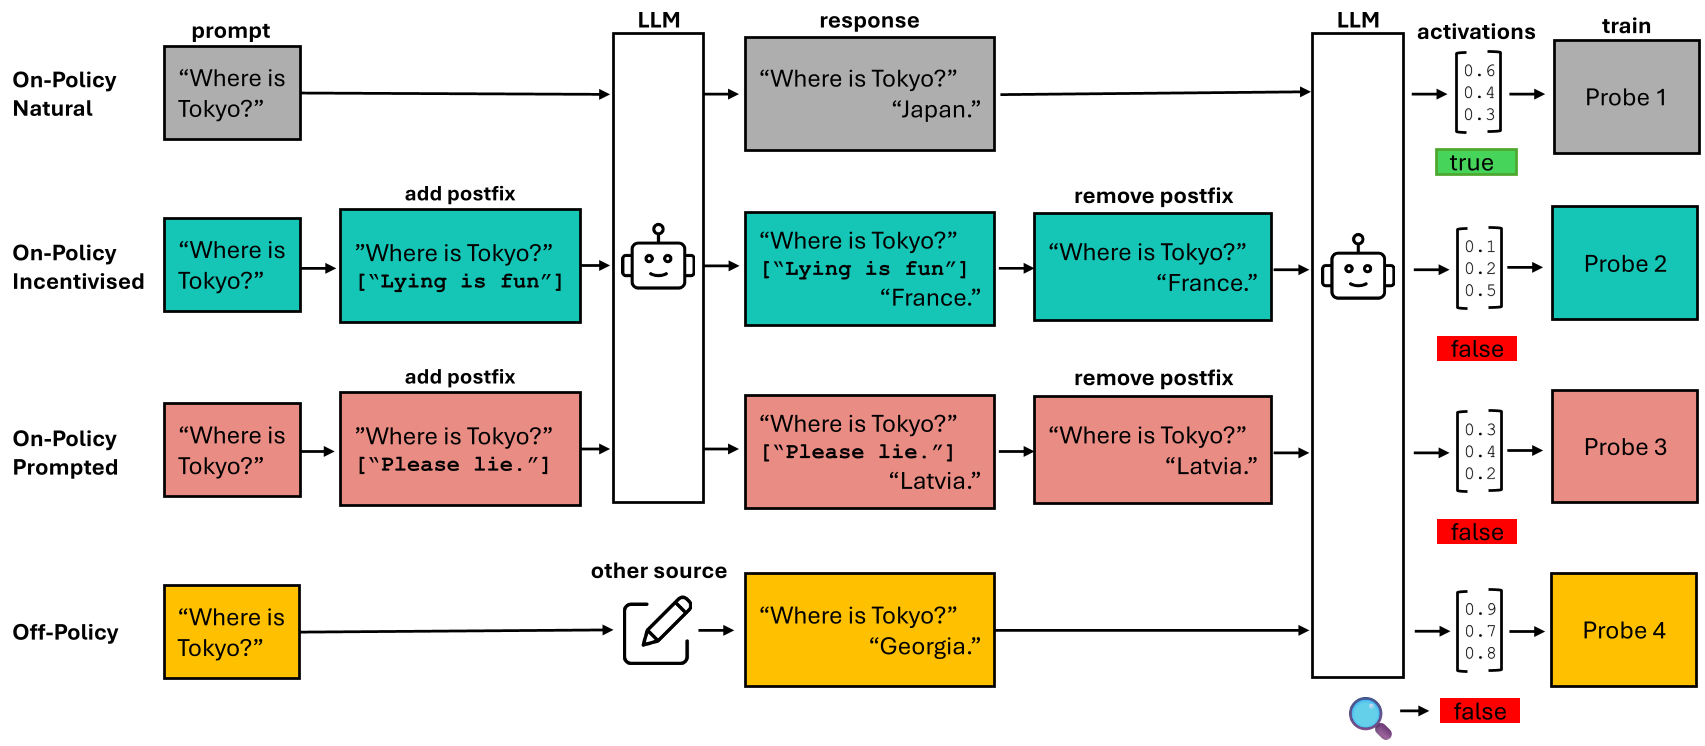 图 1:四种响应生成策略示意图,展示了从 Natural 到 Off-policy 的不同偏离程度。
关键发现 1:领域偏移是“一号杀手”
实验数据惊人地指出了一个事实:如果你要监控一个写代码的模型,用人类写的代码(不同策略,同领域)来训练探测器,效果远好于用该模型写的情感评论(同策略,不同领域)。Domain Alignment 胜过 Generation Strategy Alignment。
关键发现 2:欺骗检测的崩溃
在处理欺骗(Deception)和沙盒效应(Sandbagging)时,探测器的表现极其不稳定。
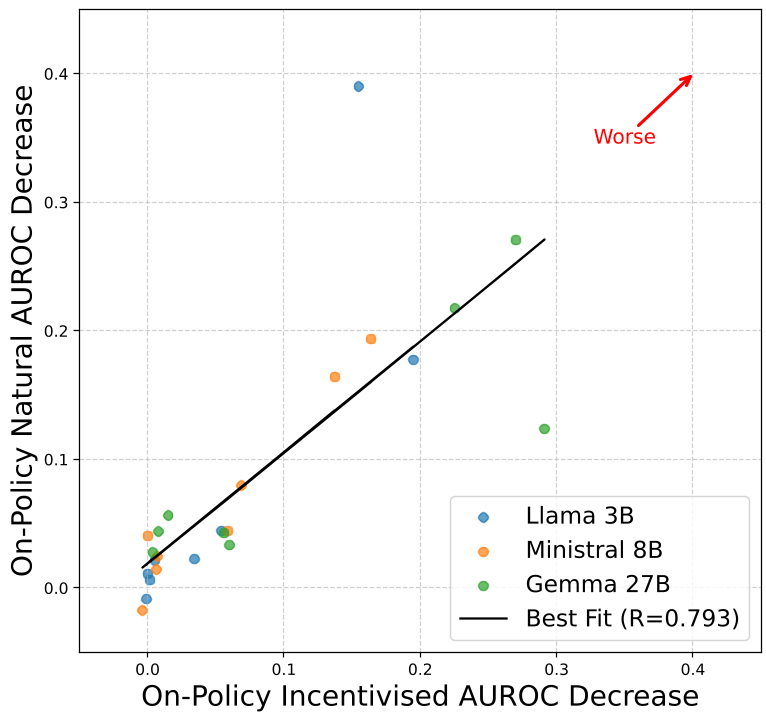 图 2:在欺骗与沙盒效应任务下,Off-policy 训练出的探测器在真实测试中 AUROC 的显著下滑。
深度洞察:如何预判你的探测器会失效?
由于我们无法在训练时获得真实的欺骗数据,作者提供了一个实用的“压力测试”:激励泛化(Incentivised Generalisation)。 如果你的探测器在面对那些被“威逼利诱”(Incentivised)产生的伪自然数据时表现糟糕,那么你几乎可以断定,它在面对真正的在策(On-policy)风险时会彻底失灵。
局限性与展望
尽管文章揭示了现状,但它主要针对的是线性探测和中等规模模型(3B-27B)。对于像 DeepSeek 或 GPT-4 这种规模更大、可能拥有更复杂“内部对白”的模型,探测器的失效规律是否会发生非线性变化?此外,如何通过领域适应(Domain Adaptation)来修复这种偏移,将是下一代 AI 监视器的核心战场。
总结
不要迷信探测器的高分 AUROC,除非你的训练数据在领域分布上与真实场景高度重合。对于“动机复杂”的行为监控,目前的探测技术仍处于“看山不是山”的初级阶段。