
长序列建模的不可能三角:揭秘 AI 记忆、速度与空间的底层博弈
The Impossibility Triangle of Long-Context Modeling
本文提出了长序列建模的“不可能三角”理论,证明了任何模型无法同时实现推理效率 (Efficiency)、状态紧凑性 (Compactness) 和强回忆能力 (Recall)。该研究统一了 Transformer、SSM 和线性循环网络(LRN)等 52 种主流架构,揭示了长序列处理中性能与资源之间的底层权衡。
TL;DR
在 AI 迈向百万甚至千万级上下文的今天,我们是否能拥有一种既不占内存、运行又快、还能精准记住每一个细节的完美模型?来自长沙理工大学的研究者 Yan Zhou 给出了令人遗憾但深刻的答案:不可能。本文通过严谨的信息论证明,效率 (E)、紧凑性 (C) 与回忆能力 (R) 构成了一个不可逾越的“不可能三角”。
背景定位:寻找长序列建模的“圣杯”
自 Transformer 问世以来,长序列建模已成为 LLM 进化的核心。Transformer 凭借 KV-Cache 实现了近乎完美的 Recall (R),但其显存消耗和计算成本随长度线性增长。为了解决这一痛点,SSM (如 Mamba) 和线性注意力模型 (如 GLA) 纷纷涌现,它们通过固定大小的隐藏状态实现了极致的 Efficiency (E) 和 Compactness (C)。然而,开发者们发现,这些模型在“大海捞针”测试中往往后劲不足。
本文的贡献在于:它不仅观察到了这一现象,还通过数学手段将其上升为一种类似分布式系统 CAP 定理 的普适准则。
核心直觉:为什么“鱼和熊掌”不可兼得?
作者提出了 在线序列处理器 (Online Sequence Processor, OSP) 的概念。无论模型内部多么复杂,它本质上都在做两件事:
- State Update (): 读取新 Token,更新状态 。
- Readout (): 根据状态回答查询。
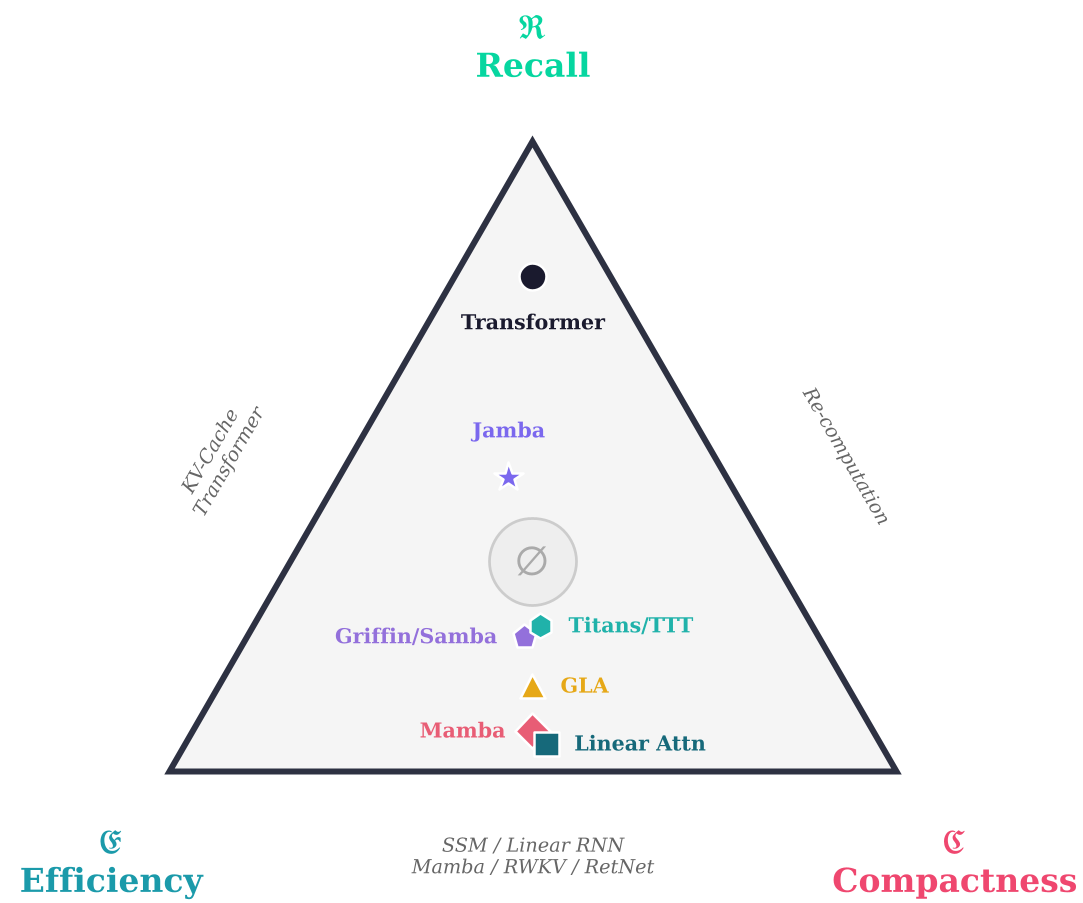
不可能三角定义了三个极点:
- Efficiency (E): 每步计算量不随序列长度 增加(固定 FLOPs)。
- Compactness (C): 状态所占比特数不随 增加(固定内存占用)。
- Recall (R): 能够召回与 成比例的历史事实(强回忆能力)。
数学证明:信息论的宣判
证明的核心利用了 Fano's Inequality。简单来说,如果你想以极高的准确率召回 个键值对,你的隐藏状态 必须包含至少 比特的信息。
如果模型满足 Compactness (C),意味着它的状态大小被限制在 这样一个常数比特内。随着序列长度 趋于无穷大,状态能容纳的信息量是死的,但需要记住的事实却越来越多。这就导致了公式 (6) 的结论: 只要状态不随长度增长,回忆能力 就会在某个点触及天花板,无法实现相对于 的线性增长(即 )。
52 种架构的大阅兵
作者系统性地将现有的 52 种模型填入了这张“不可能三角”地图:
- Region R (Transformer 系列): 牺牲了 E 和 C,换取了完美的 R。包括 FlashAttention、MLA 等,虽然优化了常数,但未改变线性增长的本质。
- Region E ∧ C (SSM & Linear RNN): Mamba, RetNet, RWKV 等,它们位于高效紧凑的顶点,但在超长序列的回忆任务中必然受限。
- Interior (混合架构): 如 Jamba 和 Zamba。它们通过交替堆叠 Attention 层和 SSM 层,在三角形内部寻找平衡点。
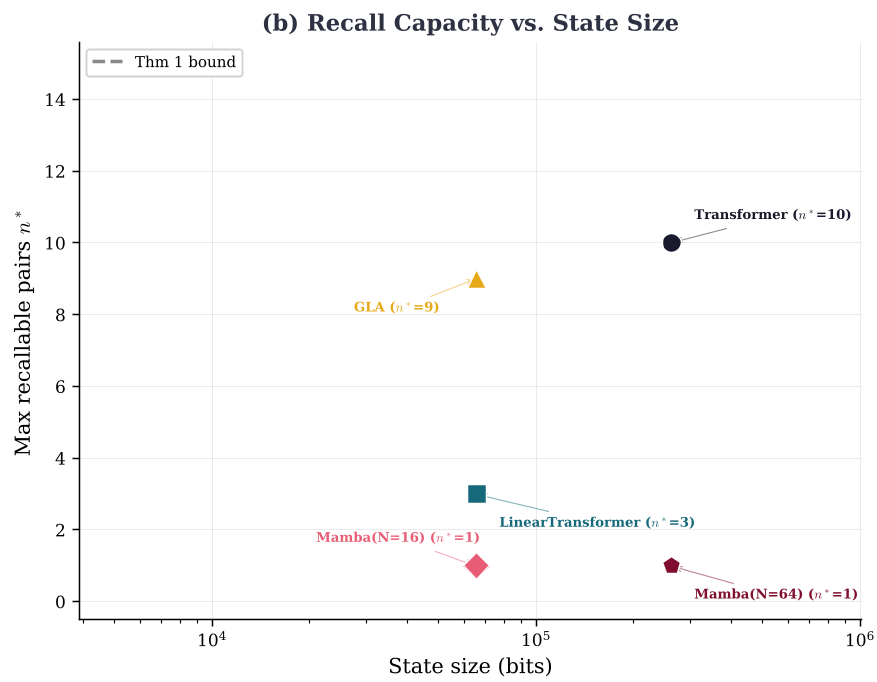 图中可清晰看到,Transformer 的召回能力保持恒定(紫色线),而所有固定状态模型(GLA, Linear Transformer等)的召回率都随着序列增长而快速崩塌。
深度洞察:我们能逃离三角形吗?
作者讨论了几种潜在的“越狱”路径,并逐一证伪:
- 动态状态容量: 虽然可以根据输入调整内存,但在最差输入(随机 KV 对)下依然受限。
- 外部存储 (RAG): 如果外部存储不算状态,那么检索成本将违背 Efficiency。
- 测试时训练 (TTT/Titans): 这种方法虽然提高了状态比特的利用效率,但只要权重参数量固定,依然逃不脱固定比特上限的制约。
总结与启示
这篇论文更像是一部“工程避坑指南”。它告诉我们:
- 不要试图寻找长序列建模的“银弹”,这种架构在数学理论上不存在。
- 因地制宜: 追求极致推理速度时选 Mamba;追求深度逻辑推理和长文精确检索时,请老老实实给 Transformer 堆显存。
- 未来方向: 如何通过动态注意力比例或分层压缩,让模型更接近三角形的“Pareto 前沿”,将是下一步研究的重点。
正如分布式架构师必须在 C 属性和 A 属性间做抉择,未来的 AI 架构师也将在这个三角地带里,完成最精妙的取舍艺术。