
[CVPR 2024] DMD2:突破蒸馏上限,4 步推理超越 SDXL 教师模型
Improved Distribution Matching Distillation for Fast Image Synthesis
本文提出了 DMD2,这是对分布匹配蒸馏(Distribution Matching Distillation)的重大改进,旨在将复杂的扩散模型转换成极速的一步或多步生成器。DMD2 通过去除回归损失、引入 GAN 目标函数以及多步模拟技术,在 ImageNet 和 COCO 数据集上实现了超越教师模型的 SOTA 性能。
TL;DR
扩散模型的推理速度一直是其大规模应用的阿喀琉斯之踵。麻省理工学院(MIT)与 Adobe Research 联手推出的 DMD2,通过革新分布匹配机制,彻底抛弃了造价昂贵的预训练数据集(Regression Loss),利用判别器让学生模型学会“青出于蓝而胜于蓝”。它不仅让 1 步生成达到 SOTA,其 4 步采样生成的图像在人类评价中甚至击败了运行 100 步的 SDXL 原始模型。
核心定位
如果说早期的蒸馏技术(如 Progressive Distillation)是在努力“模仿老师的解题步骤”,那么 DMD2 就是在教模型“理解答案的分布”。它是对前作 DMD 的降本增效进化版本,在学术坐标系中处于 加速生成(Acceleration)与对抗训练(GAN-based Refinement)的交汇点。
1. 痛点深挖:昂贵的“学费”与受限的“天花板”
传统的蒸馏方法(包括原始 DMD)为了训练稳定,不得不引入一个 回归损失 (Regression Loss)。这意味着你需要先用昂贵的教师模型跑几百万次采样,存下“噪声-图像”对。
- 计算昂贵:对于 SDXL 级别模型,仅造数据就需要数百个 A100 天。
- 潜力受限:学生模型被强行绑定在教师的特定采样轨迹上,永远无法超越教师的画质上限。
DMD2 的动机非常直观:能不能只匹配分布,而不去死记硬背轨迹?
2. 方法论详解:三位一体的改进方案
2.1 双时间尺度更新 (TTUR)
作者发现,直接删掉回归损失会导致训练极其不稳定(像素亮度剧烈波动)。其本质原因是负责估计生成分布的 fake score 模型更新太慢,跟不上生成器的变化。
DMD2 引入了 TTUR:每更新一次生成器,就更新 5 次 fake critic。这种不对称的节奏确保了梯度导航的精准性。
2.2 GAN 损失的华丽回归
由于预训练扩散模型(教师)本身也是一种近似,其梯度可能存在偏差。DMD2 在 U-Net 的 bottleneck 处接入了一个轻量级判别器。
- 直击真实:直接用真实图片训练判别器。
- 纠偏机制:当教师模型的评分函数(Real Score)不准时,GAN 的判断能拉回生成的真实感。
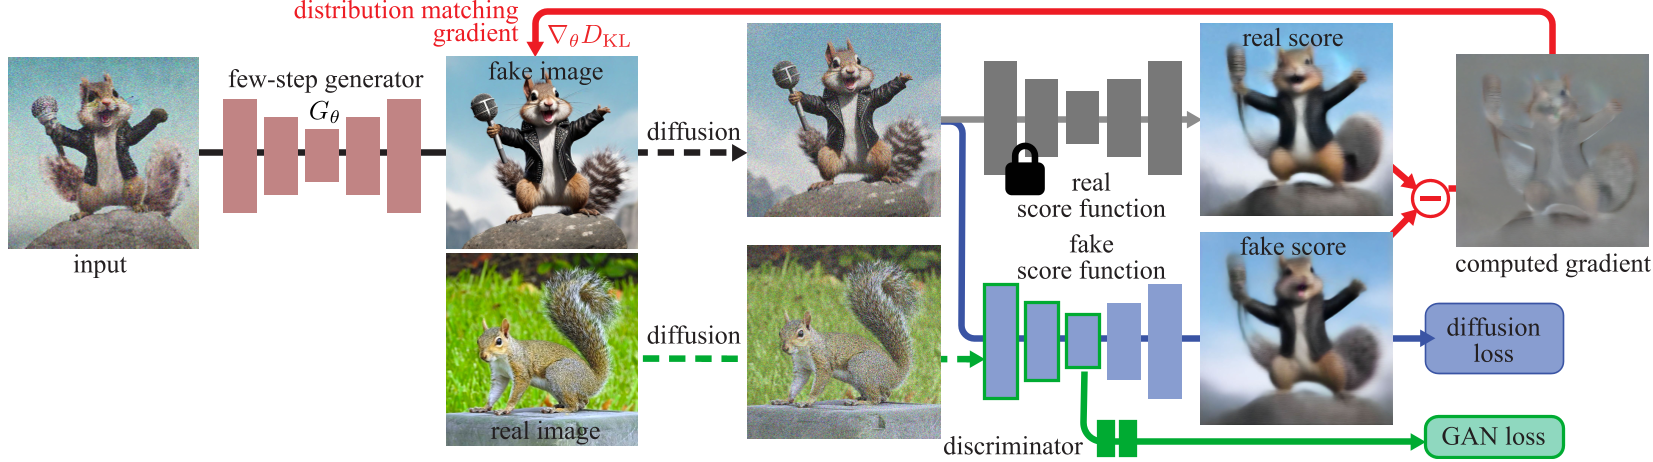 图1:DMD2 整体架构。可见左侧生成链路与右侧由教师模型、假样本评分模型组成的分布匹配链路,下方则是新增的 GAN 判别分支。
2.3 反向模拟 (Backward Simulation)
多步采样时的“训练-推理不匹配”是很多模型的顽疾。DMD2 在训练时不再使用加噪的实图,而是直接让学生模型跑一遍生成流程(模拟推理),用产生的“合成图像”作为训练输入。
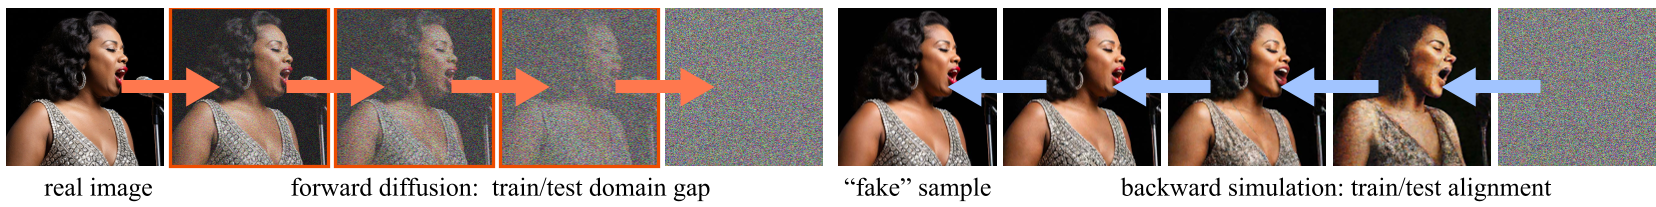 图2:相比传统方法(左),DMD2 的模拟方案(右)确保了模型在推理时看到的输入分布与训练阶段完全一致。
3. 实验战绩:极致的性能释放
3.1 惊人的 FID 表现
在 ImageNet-64x64 上,DMD2 跑出了 1.28 的 FID,这不仅远超前代 DMD(2.62),甚至比使用 ODE 采样的老师(2.32)还要强。
3.2 SDXL 蒸馏实战
在处理百万像素高清图时,DMD2 仅需 4 步即可生成极具质感的细节。
- 对比基线:在 FID 和 CLIP Score 的综合博弈中,DMD2 显著优于 LCM-SDXL 和 SDXL-Turbo。
- 消融证据:如表 3 所示,加入 GAN 损失后,FID 从 2.61 骤降至 1.51,证明了“真实数据”直接监督的必要性。
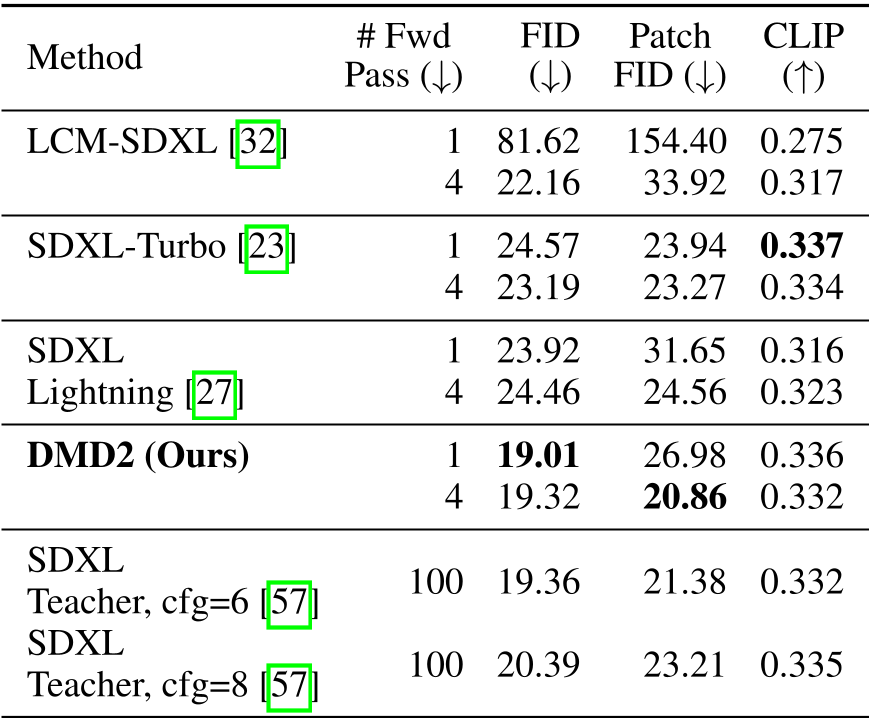 表:DMD2 在 SDXL 上的各项指标位居前列,尤其是在 Patch FID(细节质量)上表现亮眼。
4. 深度洞察与总结
核心贡献 (Takeaway)
DMD2 的成功在于其 “既要分布匹配的稳健,也要对抗训练的灵气”。它通过去除对配对数据的依赖,极大降低了大规模蒸馏的门槛,同时通过模拟推理过程解决了多步采样的累计误差问题。
局限性与展望
尽管画质无敌,但 DMD2 同样面临蒸馏模型的共性问题:多样性略微下降 (Diversity Trade-off)。由于专注于拟合高质量分布,它可能会丢失教师模型中一些古怪但多样的长尾样本。 未来的研究方向可能会集中在:
- 如何在 1 步推理中进一步保留概率分布的方差(多样性)。
- 将该方案推广到可控性更强的引导机制(Variable Guidance Scale)中,增加用户的灵活度。
总而言之,DMD2 为内容创作者提供了一个几乎无需等待的“大师级”画笔,预示着实时高清生成时代的真正到来。