
RRL:当 LLM 学会“复盘”,强化学习不再遗忘灵感
Improving RL Exploration for LLM Reasoning through Retrospective Replay
本文提出了 Retrospective Replay-based Reinforcement Learning (RRL),一种旨在提升大语言模型(LLM)复杂推理任务探索效率的强化学习算法。通过引入动态回放机制,该方法在代码生成(APPS+)和数学推理(MATH)等任务上显著超越了 Vanilla PPO。
TL;DR
在强化学习(RL)优化大语言模型(LLM)的过程中,我们常发现一个尴尬的现象:模型在“变强”的同时也变得更加“保守”。复旦大学研究团队在最新论文中提出的 Retrospective Replay-based Reinforcement Learning (RRL) 算法,通过一种类似于“存档点续读”的机制,让处于训练后期的强大模型去重新探索早期被冷落的奇思妙想,成功在代码生成和数学推理任务中刷新了性能基准。
痛点深挖:策略梯度是探索的“杀手”?
在复杂的推理任务中,正确答案往往隐藏在极深的搜索空间之后。
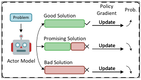
- 早期(Weaker Model):模型像个充满好奇心的学生,虽然经常能想到正确的解题思路(Promising States),但由于手感欠佳(能力不足),总是在最后几步写错。结果是:整条路径获得负奖励,策略梯度(Policy Gradient)无情地告诉模型:“这个思路也是错的,以后别想了。”
- 后期(Stronger Model):模型能力增强了,但因为早期的惩罚,它已经永久地“封杀”了那些潜在的正确思路。此时,模型的行为空间(Action Space)发生坍缩,陷入了局部最优。
核心方法:回顾式回放 (Retrospective Replay)
RRL 的核心直觉是:不要让好点子因为一次失败而被永久埋没。
1. 灵感捕获 (Identifying Promising States)
模型在探索过程中,RRL 会利用 Value Model (价值模型) 评估每个 Token 后的中间状态。即使最终答案错了,但如果中间某个节点的估值极高,说明这可能是一个“天才的开端”,RRL 会将其存入 Buffer。
2. 接力探索 (Dynamic Replay)
随着训练步数增加,系统会以概率 触发“回放模式”。此时模型不再从原始题目(Problem )开始生成,而是直接从 Buffer 里的高价值中间点(State )开始“接力”。
- 双源补给:状态不仅来自模型自己的历史探索,还来自于 Standard Solution(标准答案)的中间截断,增强了探索的质量上限。
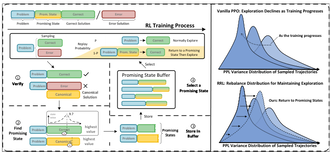 左图展示了 RRL 的回放流程,右图揭示了训练中 PPL 方差(代表多样性)的演变趋势。
实验与结果:全线突破
研究者在开源界最硬核的几个榜单上验证了 RRL 的威力:
- 代码生成 (APPS+):RRL 整体 Pass@1 达到 35.2%,显著优于 Vanilla PPO 的 31.7%。尤其在复杂的对话式代码生成的 Interview 和 Competition 级别题目中,提升幅度更巨。
- 数学推理 (MATH):在极具挑战性的 MATH 数据集上,RRL 实现了 34.3% 的准确率,相比 GSI 等强基线有明显优势。
(注:RRL 在复杂题目上的提升比例远高于简单题目,证明了其处理长程推理的优越性)
消融分析:谁才是关键?
实验显示,单独从模型生成的点回放或单独从标准答案回放,效果都差强人意。双管齐下效果最好,这表明:RL 既需要正确的“外部指引”,也需要对“自身探索历程”的修正。
深度洞察:跳出 RL 的“探索悖论”
在大模型后训练(Post-training)时代,大家都在追求更强的 Reward Model。但 RRL 提醒我们:算法框架本身的缺陷(如策略梯度带来的探索退化)可能比奖励信号的噪声更致命。
通过“存档点”机制,RRL 实际上在 RL 训练中引入了一层“课程学习”的色彩,让模型能够通过回顾过去来校准未来。对于那些正在做 LLM 推理优化的团队,RRL 提供了一个极其宝贵的思路:如果模型现在解不出难题,不妨让它回到昨天解到一半的地方再试一次。
局限性与未来
尽管表现强劲,但 RRL 依然依赖 Value Model 的准确性。如果 Value Model 在初期过于波动,可能会存入错误的“高分状态”。未来的研究方向在于如何更精准地筛选这些“潜力股状态”,并进一步优化回放的动态权重。
总结:RRL 不仅仅是一个算法优化,它更像是一种思维方式的转变——从“只看结果”到“珍惜过程中的闪光点”。