
人工好奇心的信息几何:统一勘探策略的新范式
An Information-Geometric Approach to Artificial Curiosity
本文提出了一种基于信息几何(Information Geometry)的统一框架来重新诠释人工好奇心(Artificial Curiosity)。通过引入 (\alpha)-信息奖励,作者证明了该方法能在数学上统一现有的“计数勘探”(Count-based Exploration)与“最大熵勘探”(Maximum Entropy Exploration)方法,并在 SOTA 强化学习任务中提供了理论支撑。
TL;DR
传统的强化学习勘探策略(如基于计数的或最大熵的)长期被视为不同的分支。苏黎世大学与 ETH 的研究者 Alexander Nedergaard 等人通过信息几何 (Information Geometry) 视角,证明了所有“合理”的内在奖励本质上都是占据率流形 (Occupancy Manifold) 上的曲率表现。通过一个简单的标量参数 (\alpha),他们成功将多种勘探方法归纳为一个统一的模型,并揭示了勘探-开发权衡背后的测地线插值直觉。
1. 痛点:为什么内在奖励总是“靠猜”?
在强化学习中,当环境奖励像大海捞针一样稀疏时,我们需要给智能体一点“好奇心”。但问题在于:
- 启发式泛滥:无论是基于预测误差(Surprise)还是访问计数(Novelty),形式五花八门。
- 缺乏一致性:同样的算法换个表示方式(Representation)可能就不再有效。
作者提出,理想的内在奖励应该具有表示不变性 (Representation-invariant) 且符合信息单调性 (Information Monotonicity)。这意味着无论你如何重新编号状态,好奇心的本质不应改变。
2. 核心机制:占据率流形上的几何学
研究的核心在于占据率 (Occupancy) (p_\pi),即智能体在某种策略下访问各状态的频率。
测地线插值 (Geodesic Interpolation)
作者证明,由于信息几何中 Čencov 定理的约束,唯一合法的内在奖励函数族是 (\alpha)-信息((\alpha)-Information):
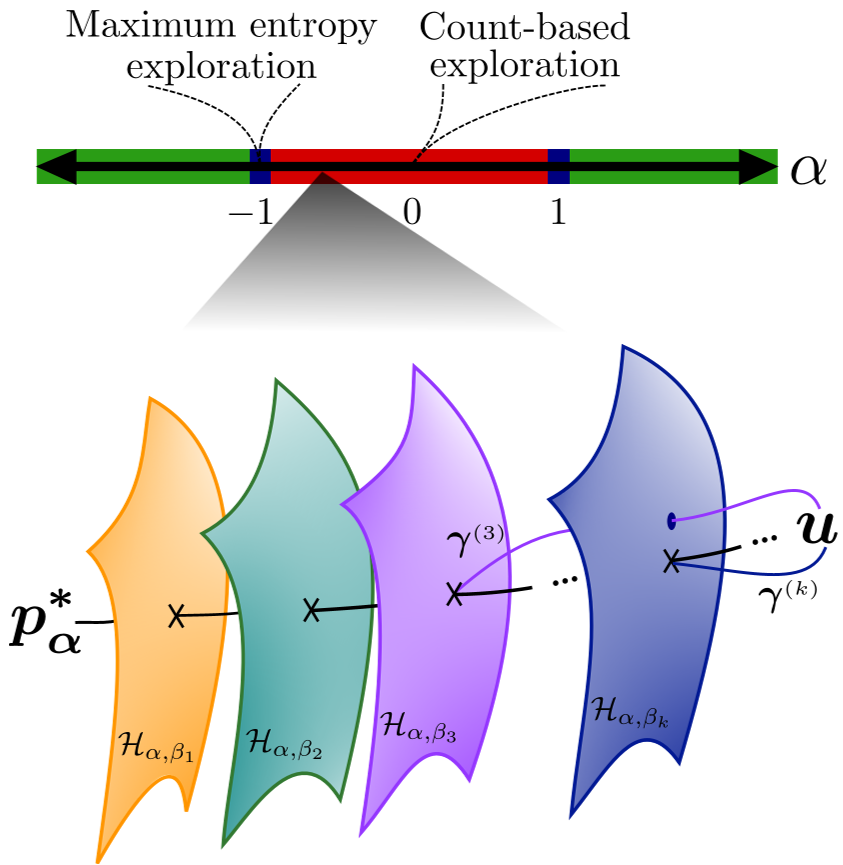
如图 1 所示:
- (\alpha = 0):对应黎曼几何(球面),此时算法表现为基于计数的勘探(如针对有限空间的 SOTA 棋类模型)。
- (\alpha = -1):对应平坦几何,此时算法表现为最大熵勘探(广泛应用于连续空间任务)。
- 参数 (\beta):控制智能体在该流形上沿着测地线 (Geodesic) 从“最大奖励占据率”向“均匀分布占据率”移动的程度。
3. 方法论详解:数学背后的直觉
论文最精妙之处在于将内在奖励定义为 (f)-信息的泛化: [ I_f(s; p) = f[1/p(s)] ] 其中 (f) 必须是严格凹函数。作者通过复杂的推导显示,只有特定的 (\alpha)-发散梯度才能确保勘探是在“最短路径”上寻找未知的状态。
这种几何视角的物理含义非常直观:曲率 (\alpha) 决定了你对“罕见状态”的敏感程度。
- 负 (\alpha) 会放大占据率的峰值(聚焦明显目标);
- 正 (\alpha) 则更强调对低概率“山谷”的填补(深度探索冷门路径)。
4. 实验验证:可视化勘探权衡
作者在一个 3 状态的可视化实验中展示了 (\alpha) 和 (\beta) 如何共同塑造智能体的行为:
在图中可以看到:
- (\beta) 的作用:随着 (\beta) 增加,最优分布((p_{\alpha,\beta}))平滑地从追求最大外部奖励转向均匀全局探索。
- (\alpha) 的演变:不同的 (\alpha) 轨迹展现了在占据率空间中完全不同的搜寻倾向。这解释了为什么在某些复杂机器人任务中,微调熵奖励的凹度能带来性能飞跃——其实是在隐式调整流形曲率。
5. 深度洞察:神经科学的呼应
这项工作不仅在工程上有价值,作者还提出了一个前瞻性的推论:新颖性 (Novelty) 与惊喜 (Surprise) 只是同一光谱上的两个点。
- 基于生成模型的“新颖性”对应 (\alpha = 0);
- 基于预测误差的“惊喜”对应 (\alpha = -1)。 这为理解哺乳动物多巴胺系统中的好奇心机制提供了统一的理论基础。
总结与局限
Takeaway:本文为多样的人工好奇心算法提供了一套“度量衡”。开发者不再需要盲目尝试奖励函数,而是可以通过选择 (\alpha) 来决定探索的几何偏好。
局限性:理论推导假设了智能体能够准确估计占据率密度。在极高维的原始像素输入下,如何构建鲁棒的非参数密度估计器依然是通往实际部署的“最后一公里”。
资深主编评价:这是一篇具备“理论美感”的论文。它没有堆砌 SOTA 榜单,而是回溯到信息论的本源,用简洁的几何语言重新定义了一个混乱的子领域。对于想深入理解 RL 勘探本质的研究者,这是必读之作。