
Intern-Atlas:将百万论文编织成网,打造 AI 科学家的“技术进化指南”
Intern-Atlas: A Methodological Evolution Graph as Research Infrastructure for AI Scientists
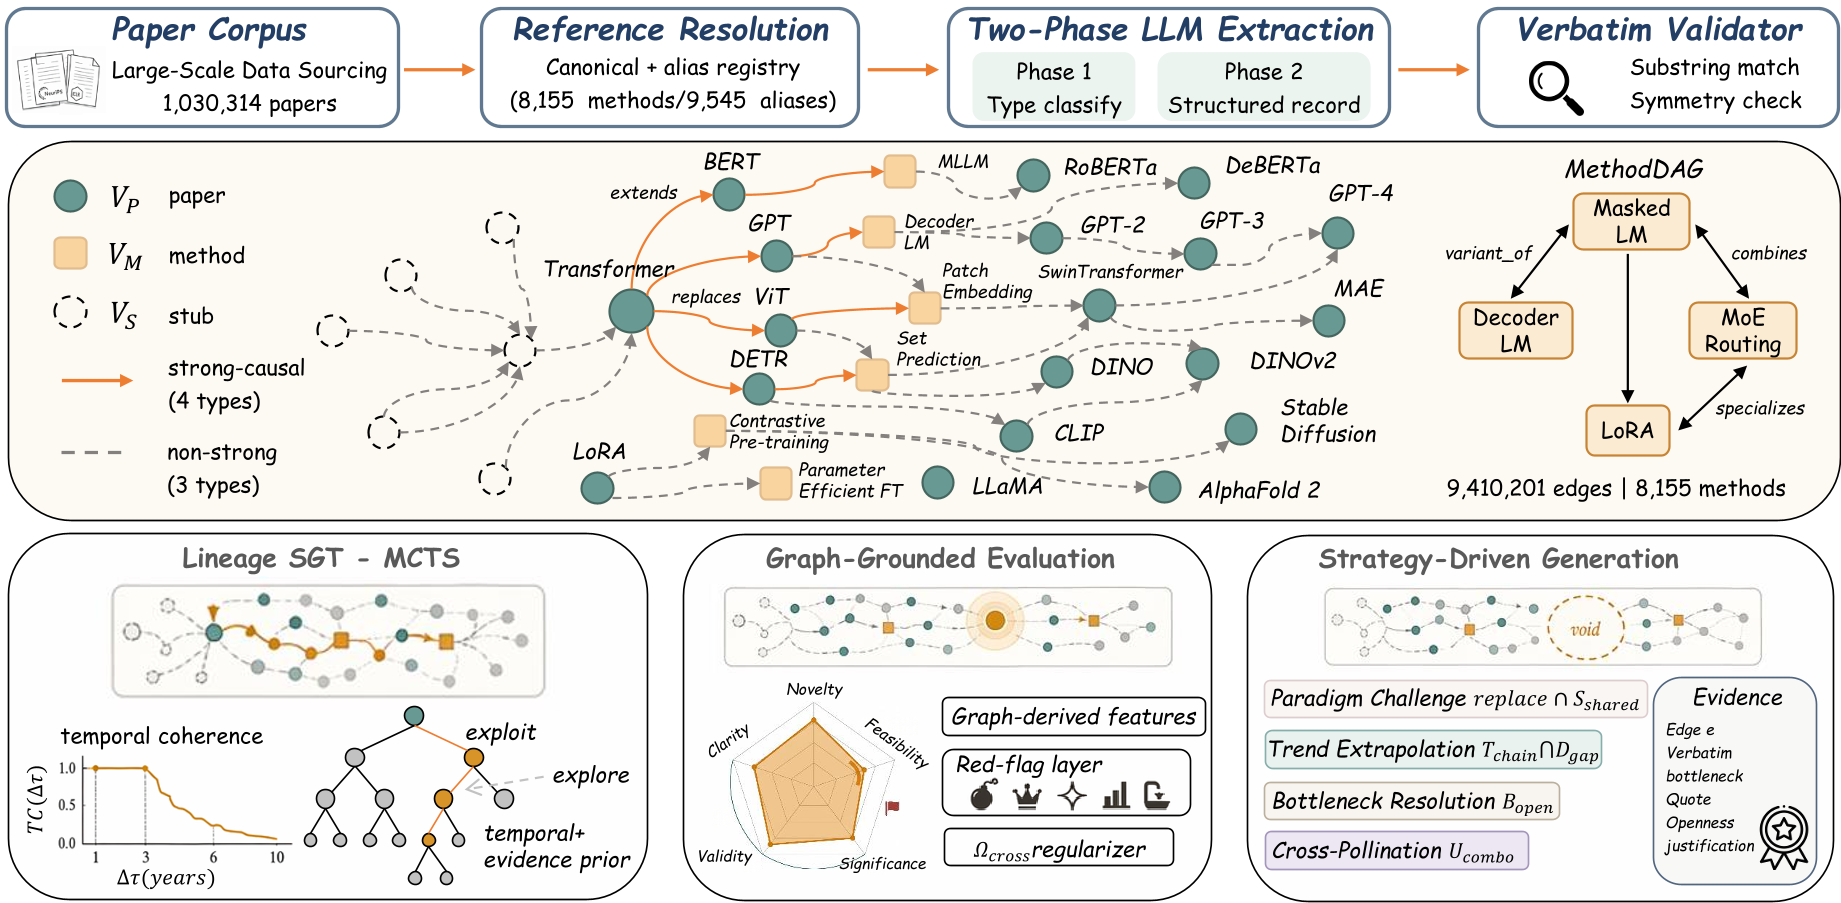
本文推出了 Intern-Atlas,这是一个专门为 AI 科学家(及 AI Agent)设计的技术演进图谱。它从超过 100 万篇 AI 论文中提取了 941 万条具有语义类型的因果边,将扁平的文献引用网络转化为可查询、可推理的方法论演进拓扑,实现了从“以文档为中心”到“以方法为核心”的范式转变。
TL;DR
如果说 Google Scholar 是论文的“图书馆”,那么 Intern-Atlas 就是 AI 技术演化的“族谱”。它通过 941 万条语义化的引用边,揭示了 AI 方法论如何针对特定**瓶颈(Bottleneck)**进行演进。这项研究不仅为人类提供了清晰的技术脉络,更关键的是,它为下一代 AI 研究 Agent 提供了结构化的、可逻辑推理的科研“底层大脑”。
背景定位
目前学术界正从“人类读文献”转向“AI 研究员(AI Agent)自动产出想法”。然而,现有的基础设施(如 Semantic Scholar, OpenAlex)极其简陋——它们只告诉你 A 引用了 B,却不告诉你 A 是改进了 B,还是全盘否定了 B。Intern-Atlas 填补了这一空白,成为了首个大规模、自动化的学术方法论演进基础设施。
痛点深挖:文档中心的局限性
- 隐性知识重建难:人类研究者在阅读时能脑补出 Transformer 如何变成 BERT,但 AI 模型的参数化内存是“有损压缩”,难以复原长尾的方法细节。
- 虚假的新颖性:AI Agent 在生成想法时,由于缺乏对技术瓶颈的全局视野,往往会堆砌流行术语,产出看似“可行”实则“平庸”或“已存在”的方案。
方法论详解:如何从 100 万篇论文中构建进化论?
Intern-Atlas 的构建涉及一个严密的流水线,将扁平的文本转化为多维的因果网络。
1. 实体对齐 (Alias Resolution)
在学术圈,同一个东西有无数种叫法。Intern-Atlas 建立了一个包含 8155 个标准方法节点、9545 个别名的注册中心,确保 "vanilla Transformer" 和 "Transformer" 被归到同一节点。
2. 语义化边与证据链
这是本文的核心突破。系统通过双阶段 LLM 协议,将引用关系细化为:
- 强因果边:
Extends(扩展),Improves(优化),Replaces(替换),Adapts(适应)。 - 辅助证据:每条边不仅有类型,还附带了三个核心字段:瓶颈(Bottleneck)、机制(Mechanism)、折中(Trade-off)。这一切都由原文摘录支撑。
3. SGT-MCTS:重建历史的“搜索仪式”
为了从复杂的图中找出一条最合理的技术路线,作者提出了 自我引导的时间蒙特卡洛树搜索 (SGT-MCTS)。它引入了“时间相干性优先验”(Temporal Coherence Prior),更倾向于搜索那些在时间顺序上合理且证据置信度高的分支。
实验与结果:比专家更懂人类想什么
实验结果不仅展示了图谱的完整度,更体现了其对科研生产力的真实辅助作用:
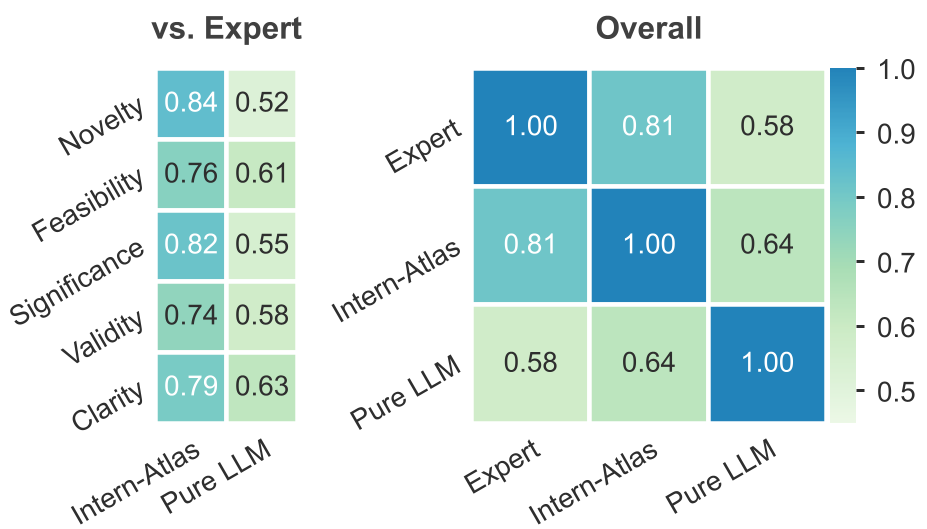
- 评审一致性:基于图谱计算出的“新颖性”和“重要性”分数,能够完美地对顶会论文、核心会议论文和被拒稿论文进行阶梯化分层。
- 盲测胜率:在由 10 位 AI 博士参与的对比实验中,Intern-Atlas 辅助生成的 Idea 在新颖性和显著性上大幅领先。
深度洞察与总结
Takeaway:
- 从“引用”转向“因果”:未来真正强大的 AI 研究工具不能仅仅依赖 RAG 检索一堆相似论文,而是必须理解方法论之间的继承与竞争关系。
- 自驱动进化:Intern-Atlas 通过确定哪些“瓶颈”尚未被解决,为 AI Agent 指明了真正有价值的科研方向。
局限性: 尽管目前在分类准确率上表现优异,但在处理跨学科术语(如同一个名字在生物和 AI 领域指代完全不同的东西)时仍存在微小偏差。此外,对于未在论文中正式引用的“博客发布、项目更新”等非正式知识的捕捉还有待加强。
展望: 正如 ImageNet 催生了计算机视觉的爆发,Intern-Atlas 这类结构化方法论图谱,极有可能成为“自动科学发现(ASD)”时代的蛋白质数据库(PDB),是未来 AI 独立完成诺贝尔级科研工作的数字基石。