
InternVL-U:轻量级 4B 战舰,开启多模态理解与生成的“大一统”时代
InternVL-U: Democratizing Unified Multimodal Models for Understanding, Reasoning, Generation and Editing
本文推出了 InternVL-U,这是一个 4B 参数规模的轻量级统一多模态模型(UMM),通过集成 SOTA 的理解模型与自定义的 MMDiT 生成头,实现了多模态理解、推理、生成与编辑的全面统一。
TL;DR
上海人工智能实验室(Shanghai AI Lab)等机构发布了 InternVL-U,一个仅有 4B 参数的超级多模态模型。它通过巧妙的“解耦”架构设计,完美化解了机器“看懂(Understanding)”和“绘画(Generation)”之间的矛盾。在保持 SOTA 级理解能力的同时,其图像生成与编辑能力在多项榜单上逆袭了比它大数倍的万亿级、百亿级参数模型。
核心定位:打破“全原生”与“全集成”的僵局
在 InternVL-U 出现之前,多模态领域存在两大派系:
- Fully-native(原生派):从头训练,试图在一个 Transformer 里搞定一切。虽然理论优美,但训练极难平衡模态分配,且烧钱。
- Fully-ensemble(集成派):把现成的理解模型和生成模型强行“缝合”。结果往往是架构臃肿,语义理解与视觉生成之间存在厚厚的屏障。
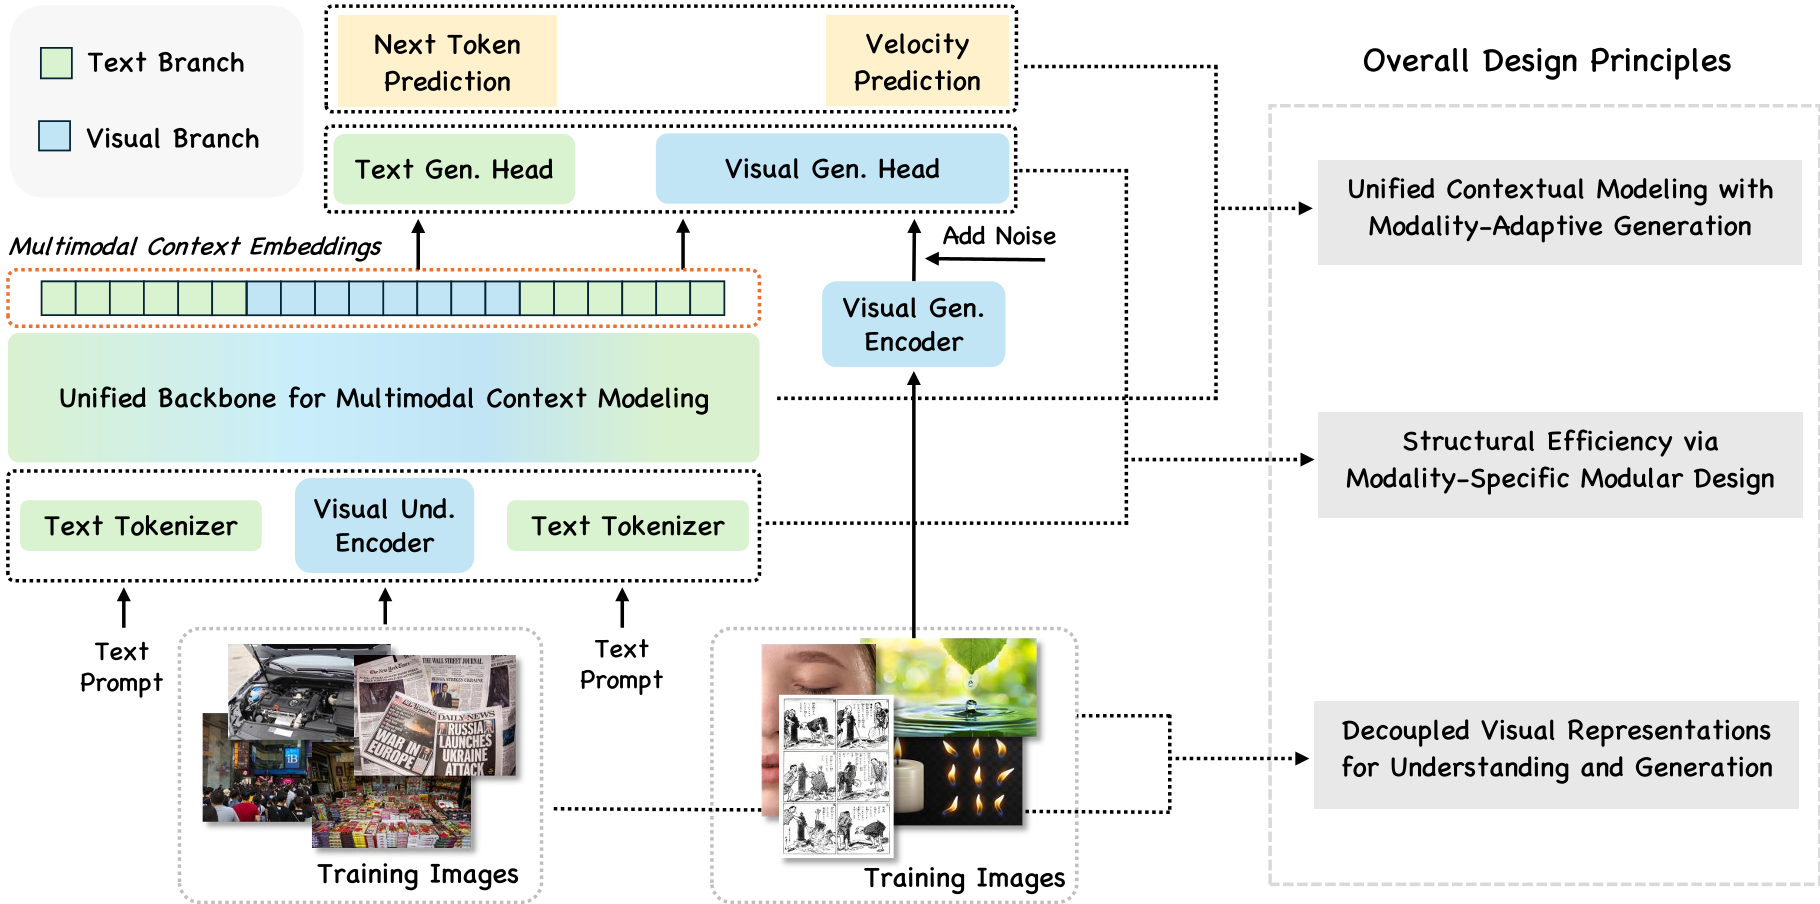
InternVL-U 的定位是:以架构的确定性解决任务的不确定性。它基于 InternVL 3.5 强大的语义背锅,通过解耦视觉表征,实现了效率与效果的指数级平衡。
痛点深挖:为什么多模态大一统这么难?
作者指出,图像理解需要的是高层语义特征(类似人类看一眼知道是“猫”),而图像生成需要的是底层像素细节(类似画家要勾勒每一根毛发)。强行用同一个视觉编码器(Visual Encoder)去适配这两个完全相反的目标,会导致模型在对抗中产生性能折中(Trade-off)。此外,传统生成模型缺乏推理能力,面对“明天会是什么样”这种需要逻辑推演的编辑指令时往往会“翻车”。
方法论详解:解耦与统一的艺术
InternVL-U 的核心架构基于三大支柱:
- 解耦视觉表征:输入端使用预训练的 ViT 获取语义令牌,而输出端(生成目标)则使用专门的 VAE 潜空间。
- 模态专用模块化:并没有把像素重建任务塞进 LLM 主干,而是外挂了一个精心设计的 MMDiT(多模态扩散 Transformer) 生成头。
- 混合建模目标:文本部分用自回归(AR),视觉部分用流匹配(Flow Matching)。
创新点:Gated Attention 与 MSRoPE
在生成头的设计上,作者首次将 Gated Attention(门控注意力) 引入 MMDiT。这种设计增强了非线性表达能力并解决了高分辨率下的“注意力沉没”问题。同时,通过统一的 3D MSRoPE(多尺度旋转位置编码),模型即便在进行复杂的局部图像编辑时,也能保持精准的空间定位感。
实验与结果:小参数力压大模型
1. 语义密度的胜利:文字渲染与科学推理
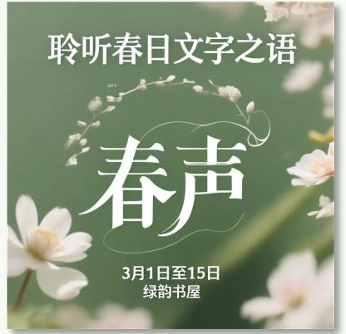
InternVL-U 最令人惊艳的是它在“高语义密度”任务上的表现。由于它继承了 InternVL 强大的 OCR 和知识库,它在图像中写字(Text Rendering)的准确率远超 Ovis-U1 和 BAGEL。
2. 推理驱动的编辑(RISEBench)
在复杂的逻辑编辑任务中(如“把二叉搜索树中插入 88”),InternVL-U 展示了其 Reasoning-centric 数据训练的威力。通过引入 Chain-of-Thought (CoT),模型会先规划操作步骤,再执行生成。
- RISEBench Score: 3.6 (无 CoT) -> 9.4 (有 CoT),提升幅度达 160%。

深度洞察与总结
核心启示: InternVL-U 的成功在于它承认了“理解”与“生成”的异质性。它没有追求盲目的参数统一,而是通过语义对齐界面将两个专业的模块连接在了一起。
局限性: 尽管在静态图像上表现卓越,但对于超长序列的视频流理解与生成(World Models 方向),InternVL-U 4B 的轻量级架构是否仍能保持优势还有待观察。此外,生成头与主干模型的端到端协同在中后期训练中对计算资源仍有一定要求。
未来展望: InternVL-U 为开源社区提供了一个极佳的基准。它告诉我们:通过高质量的合成数据(尤其是包含 CoT 的推理数据)去对齐模型,其价值远大于单纯堆砌参数量。 这种“小而精”的统一模型,将是端侧 AI 与垂直行业智能体(Agent)的最佳选择。