
InternVL-U:推理驱动的 4B 轻量级全能多模态先锋
InternVL-U: Democratizing Unified Multimodal Models for Understanding, Reasoning, Generation and Editing
本文推出了 InternVL-U,一个轻量级(4B参数)的统一多模态模型(UMM),集成了理解、推理、生成和编辑四大能力。通过将 SOTA 的理解模型 InternVL 3.5 与改进的 MMDiT 生成头结合,该模型在显著降低参数规模的情况下,在生成与编辑任务上超越了 BAGEL (14B) 等大型模型,实现了性能与效率的平衡。
TL;DR
上海人工智能实验室等机构联合发布了 InternVL-U,这是一款参数仅为 4B 的统一多模态模型(UMM)。它不仅继承了 InternVL 系列强大的语义理解基因,还通过特殊的 MMDiT 生成头 和 推理中心(Reasoning-centric) 数据策略,解决了长久以来统一模型“能看不能画”或“画得好但没逻辑”的痛点。尤其在中文文字渲染(Text Rendering)和科学图像编辑领域,表现出了惊人的 SOTA 实力。
痛点深挖:理解与生成的“左右脑”博弈
在多模态 AI 领域,开发者一直面临一个尴尬的局面:
- 语义理解层:需要高层抽象,过滤掉冗余的像素细节。
- 图像生成层:需要精确的像素控制,任何纹理的丢失都会导致结果“虚假”。
现有的统一模型往往强行将二者压缩在同一空间,导致“顾此失彼”。此外,用户指令通常是模糊的(如“画一张看起来很累的猫”),模型缺乏中间逻辑层来拆解这些抽象意图,导致生成结果随机性强,难以满足精密任务(如科学作图、文字精准排版)的需求。
核心架构:模块化设计与表示解耦
InternVL-U 的成功得益于其清醒的架构设计原则,作者将其总结为 “解耦”与“专用”。
1. 架构解析 (Architecture)
- 统一上下文 backbone:基于 InternVL 3.5-2B,负责将文本和图像投影到同一隐藏空间进行语义对齐。
- 专用的 MMDiT 生成头:引入了 1.7B 参数的生成头,基于 Multimodal Diffusion Transformer 架构,专门处理从语义空间到像素空间的映射。
- 双路径表征:使用 ViT 提取语义(用于“看”),使用 VAE 进行潜在空间重建(用于“画”)。这种非对称策略避免了传统模型在平衡抽象逻辑与具体细节时的优化冲突。
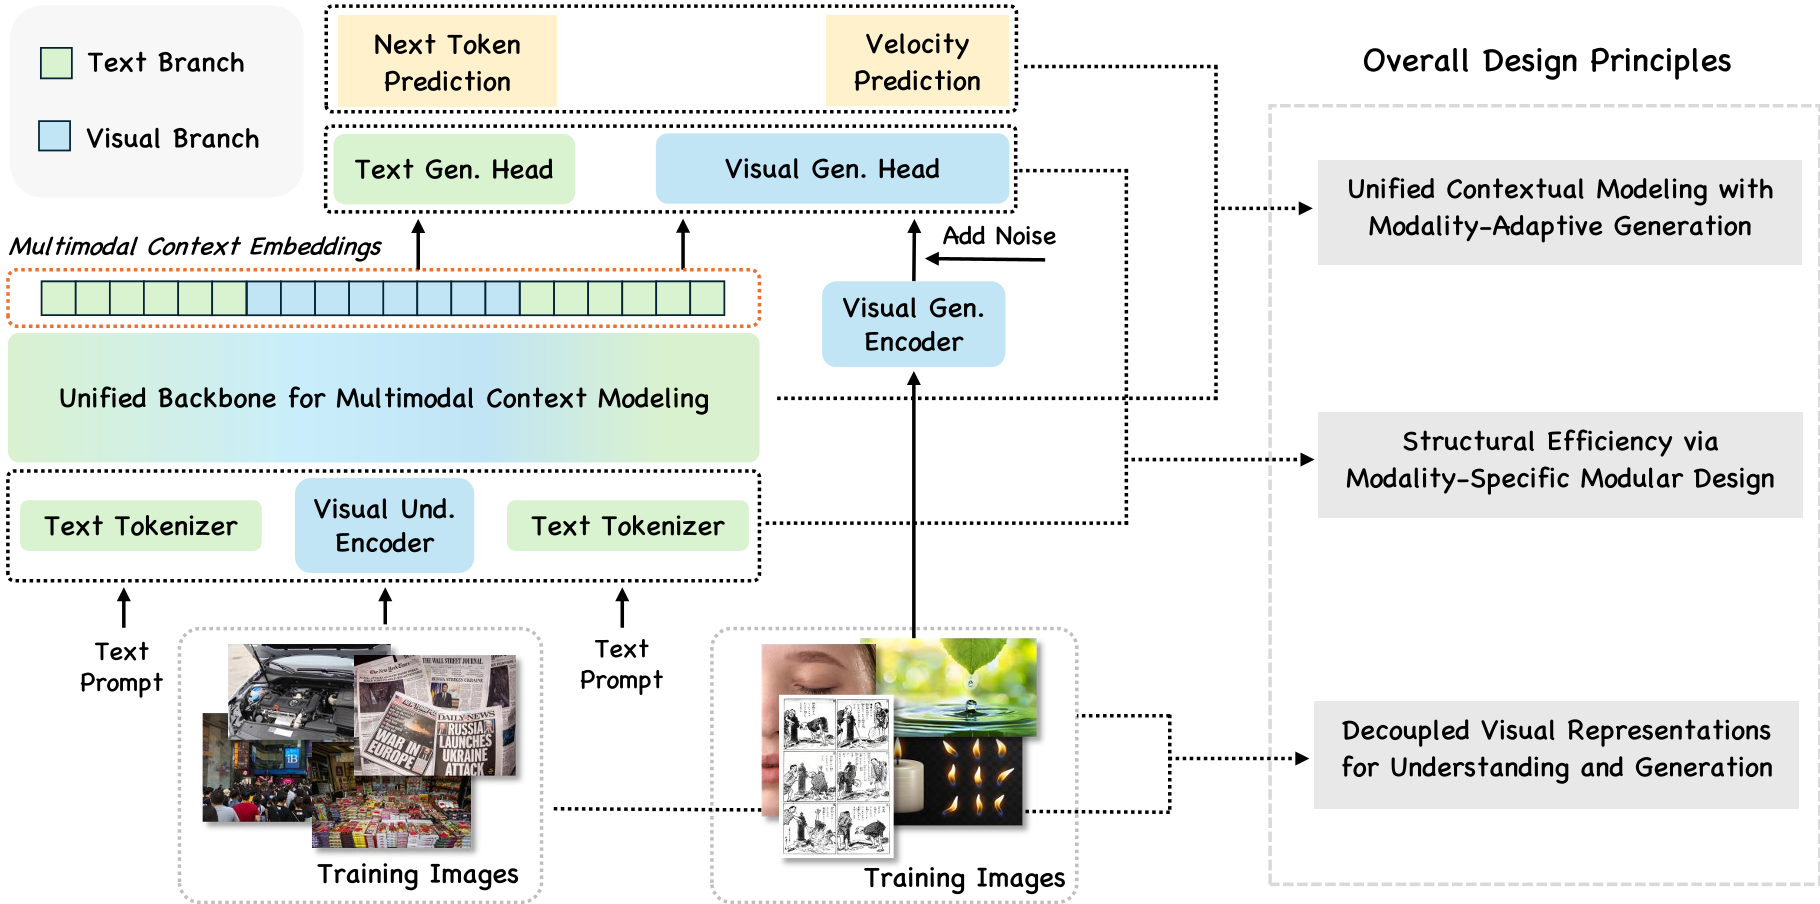 图注:InternVL-U 架构展示了三种设计原则:统一建模、特定模块化、解耦表征。
2. 推理中心化数据 (Reasoning-centric Paradigm)
这是本文最有洞见的创新。作者认为:模型能力的上限由数据决定,而指令的清晰度决定了生成的精度。 他们构建了一个包含 CoT(思维链)的数据管线。例如,在生成彩色柴犬表情包时,模型会先输出思考过程:“画一只毛茸茸的柴犬,眼睛要圆...脸颊泛红...”,最后才调用生成头。这种方式将“模糊意图”桥接到了“精确执行”。
实验战绩:以小博大的性能跨越
文本渲染 (Text Rendering) 的突破
长期以来,在图片里写对中文是 AI 的重灾区。InternVL-U 通过大规模文本中心化数据合成,实现了极高的排版准确率。在 LongText-Bench 中,其中文渲染能力远超参数规模更大的模型。
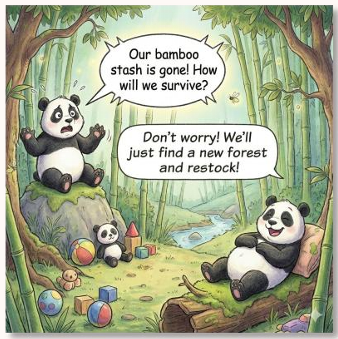 图注:InternVL-U 对中文、英文及数学公式的渲染展示,对比 BAGEL 和 Ovis-U1 具有明显优势。
科学与逻辑推理生成
在 RISEBench(推理驱动的图像编辑)测试中,InternVL-U 在引入 CoT 后分数从 3.6 提升至 9.4。这证明了模型能够理解复杂的逻辑约束,如“将图中的金字塔沿坐标向量移动”。
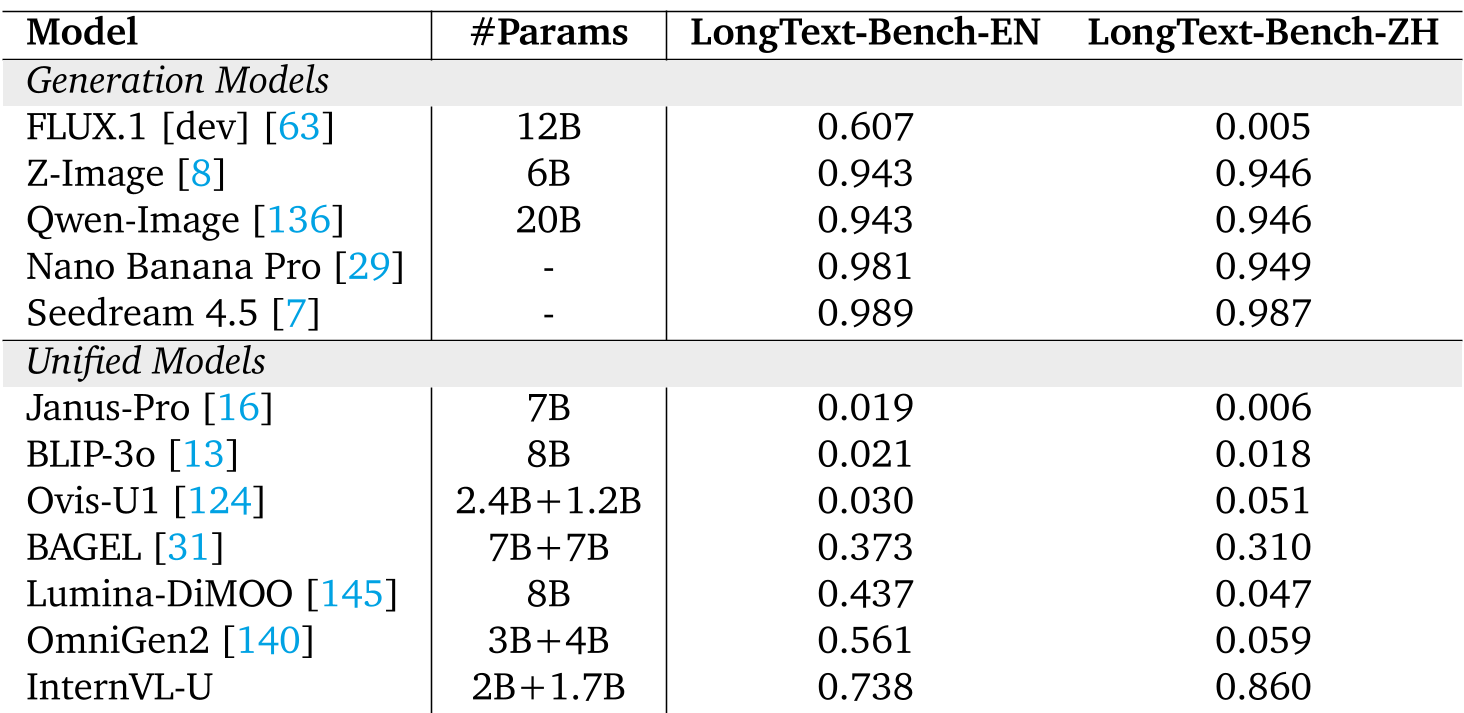 图注:表格展示了 InternVL-U 在长文本渲染基准上相比其他统一模型的巨大领先优势。
深度洞察:为什么 4B 能赢 14B?
InternVL-U 的成功并非靠堆叠算力,而是靠任务分解的合理性:
- 计算效率:通过 Encoder-based 初始化,避免了像 MoT 架构那样浪费 FLOPs 处理冗余视觉斑块。
- 训练策略:三阶段课程学习(从生成头预训练到全参数微调)确保了模型在学习新技能时不会“遗忘”原有的理解能力。
- 知识溢出:利用了 InternVL 3.5 强大的世界知识,通过 CoT 降维打击纯生成模型。
总结与局限
InternVL-U 标志着轻量级统一模型进入了“高语义密度”时代。它不再仅仅是生成一张好看的照片,而是能听懂人话、理解科学逻辑、并能精准排版的智能体。
局限性:虽然 4B 模型在很多垂直领域表现出色,但在处理极其复杂的多概念组合(Multi-concept composition)时,相较于 20B+ 的专用生成模型(如 Qwen-Image)仍有微弱差距。未来如何进一步在更小的体积下实现更强的涌现能力,将是开源社区的下一个目标。