
2-GRPO:揭开 GRPO 的面纱——它其实是“在线版”DPO
It Takes Two: Your GRPO Is Secretly DPO
本文提出了 2-GRPO,一种将 Group Relative Policy Optimization (GRPO) 组大小精简至 2 的极简化变体。研究揭示了 GRPO 本质上是 DPO 的在线强化学习版本,通过对比学习机制而非精确的优势函数估计来实现性能提升,并在多个推理任务中达到 SOTA 效率。
TL;DR
在 LLM 后训练(Post-training)领域,DeepSeek 提出的 GRPO 一直被视为高效的代名词。但业界始终存在一个迷思:为了算准那点组内统计数据,我们真的需要一次性采样 16 甚至 64 个结果吗?本文作者给出了一个大胆的结论:GRPO 本质上就是 DPO(Direct Preference Optimization)的在线版。基于这一发现,作者推出的 2-GRPO 仅需 2 个样本即可完成训练,速度提升 5 倍,且性能几乎无损。
核心直觉:从“统计学”转向“对比学习”
传统的强化学习理论(如 PPO)告诉我们,为了降低策略梯度的方差,我们需要一个精准的 Critic 网络来估计 Baseline。GRPO 的创新在于用组内平均值取代了 Critic,因此人们惯性地认为“组越大,均值越准,效果越好”。
然而,本文作者从数学层面戳破了这层窗纸:GRPO 的梯度公式在结构上与 对比学习(Contrastive Learning) 是等价的。组内采样的真正作用是通过“对对碰”,为模型提供哪些更好、哪些更坏的对比信号。
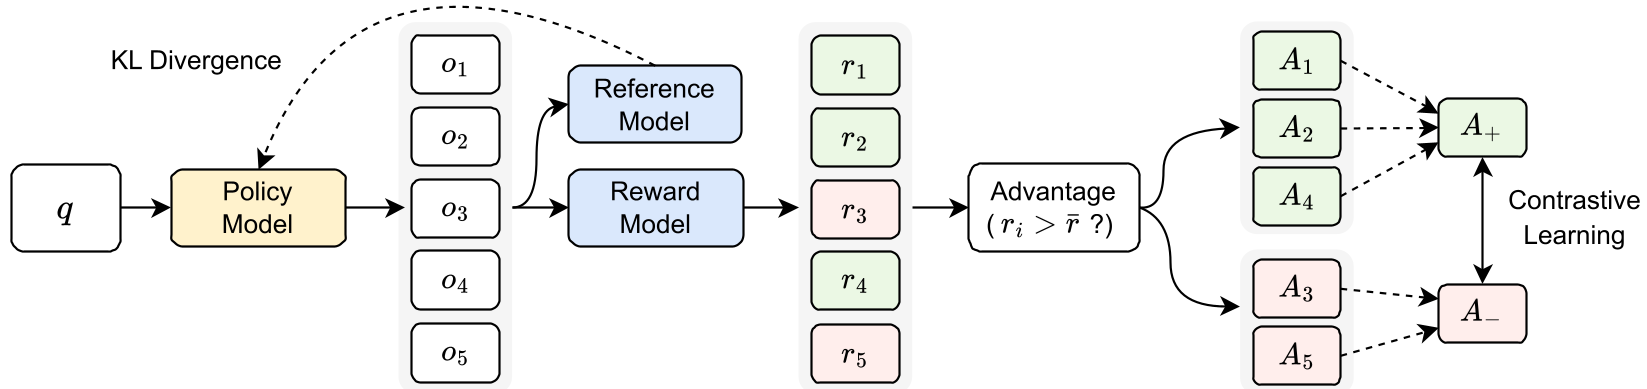 图 1:GRPO 与 DPO 的梯度结构对比及对比学习示意图
2-GRPO:极简主义的胜利
既然核心是对比,那么最极端的情况就是采样 两个 样本(一正一负或两个互相对比)。在传统统计学看来,样本量 n=2 时的均值和标准差估计是极其不稳定的(Cauchy 分布,方差无穷大)。但实验结果却令人大跌眼镜:2-GRPO 完全能跑通!
为什么 2-GRPO 不会崩?
作者提出了两个关键洞察:
- 隐式重加权 (Implicit Weighting):虽然每个 Prompt 内部的统计不准,但在随机梯度下降(SGD)的大量迭代中,不同梯度的累积效应抵消了单次噪声,实现了一种跨 Batch 的“大组效应”。
- 方差缩减 (Variance Reduction):利用控制变量法(Control Variate),只要正负样本之间存在相关性(它们由同一个模型生成,天然相关),对比梯度就能有效抑制噪声。
实验战绩:效率的质变
在 MATH、AMC、OlympiadBench 等高难度数学推理任务上,2-GRPO 展现了惊人的效率:
- 计算开销:Rollout(推理生成)量降至 1/8。
- 训练速度:总训练时间仅需原来的 21%。
- 性能维持:在 Qwen-7B 等模型上,2-GRPO 的表现与 16-GRPO 基本持平。
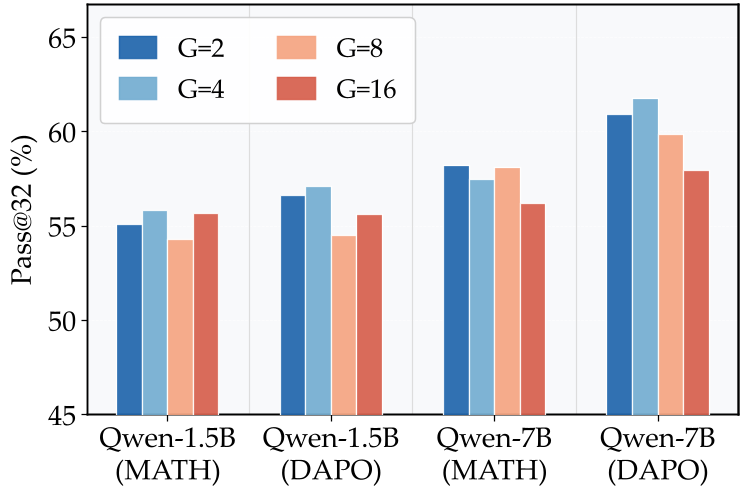 图 2:不同组大小(G=2, 4, 8, 16)在数学基准测试中的表现对比,可以看到 G=2 依然稳健
为了解决 2-GRPO 可能由于两个样本得分相同而导致的“样本浪费”问题,作者还引入了 2-GRPO+RS (Resampling)。当两个采样结果无法分出胜负时,立即重新采样。这一改进让 2-GRPO 在多个任务上甚至反超了笨重的 16-GRPO。
总结与洞察
2-GRPO 的成功具有深远的行业意义:
- 算力普惠:它大幅降低了 RLVR(可验证奖励强化学习)的门槛,让中小型研究机构也能在大模型上跑 RL。
- 理论统一:它模糊了在线 RL 与离线 Preference Learning(如 DPO)的界限,揭示了后训练对齐的本质是“在动态生成的对比中寻找方向”。
正如标题所言,“It Takes Two”,有时候,两个样本就足以让 AI 学会思考。
局限性注脚:尽管在推理任务(Binary Reward)中表现优异,但在需要细粒度连续分数(Continuous Reward)的任务中,极小组大小是否依然能保持这种优势仍有待进一步验证。