
便宜决策型评审的适用边界:JEV 作为置信级联的第一关
JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
本文评测 TypeSafe JEV 1.13 作为决策型评审的准确率、置信度、延迟和费用。作者将 JEV 与多个生成式评审和奖励模型比较,发现它在普通偏好和证据事实性任务上接近 GPT-6,费用显著更低,但在复杂推导和对抗风格任务上明显落后。置信级联可在适当负载中接受确定判断并升级不确定判断,从而以较低费用保留 GPT-6 的绝大多数准确率。
核心速览
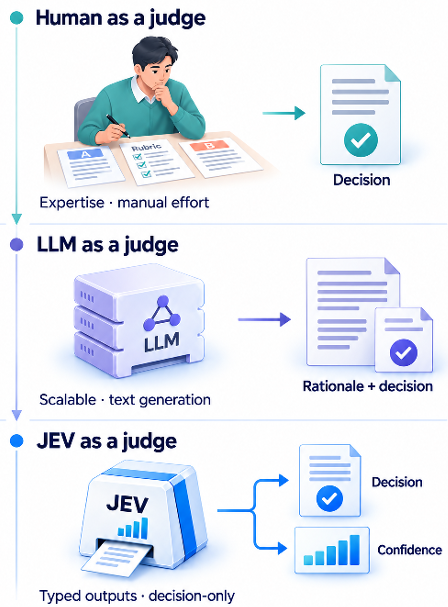
本文研究一个很具体的工程问题:一个只输出类型化结论和标签概率的便宜评审,能否在大规模自动评测中承担第一关,并在不确定时把输入升级给更强模型。作者比较 JEV、多个生成式 LLM 评审、现代奖励模型和 PairRM,并用匹配面板测量费用和延迟。结果显示,JEV 在普通偏好和证据事实性任务上能在三个百分点内接近 GPT-6,费用约为其 0.36%;但一旦判断需要检查多步推导或抵抗更华丽的错误答案,差距扩大到十几个百分点。
这项工作的定位不是提出新路由算法,而是给出一份托管决策型评审的操作档案。论文把可用性、准确率、校准、延迟和费用放在一起测,因此对“便宜评审能不能用”的答案不是单一分数,而是一张负载地图:哪些任务可以直接接受,哪些任务必须升级,哪些任务上的置信信号本身不可靠。
问题与动机
LLM-as-a-judge 正在替代一部分人工评估,但规模化的代价并不低。生成式评审通常会输出理由,而推理模型还可能为简单判断生成大量中间 token,造成延迟和 token 费用上涨。论文在开篇指出,评估重复发生在大量回复和模型修订上,评审自身的成本会成为开发和运行系统成本的一部分。这里的关键矛盾不是“便宜模型是否准确率略低”,而是评审的 token 消耗、输出接口和置信可靠性被耦合在一起,难以拆分比较。
第二个矛盾来自置信度。口头置信度或自报自信并不稳定校准,模型可能给错误答案高概率。自动评估系统需要的不是一个漂亮数字,而是能够在决策点区分常规案例和困难案例的信号。论文的核心直觉是:如果评审器直接返回标签分布,最大标签概率可以作为第一关的升级线索;但这个直觉只在“模型知道自己哪里不确定”的负载中成立。
核心章节:决策、概率和费用必须同时测
1 评测协议:把判决、概率和费用拆开
论文的出发点是先定义一个统一合同。JEV 接收结构化状态、自然语言指令和允许的输出类型,返回候选判决与标签概率;所有生成式基线也收到同一合同,被要求输出判决和概率但不输出理由。这样比较的是完整评审配置,而不是单纯比较概率接口是否更干净。原始数据中 JEV 在 1312 个 base 判断上全部满足输出合同,Table 1 和 Appendix Table 6 把无效输出计为错误,因此不能把“有效输出少”与“有效输出准确率高”混为一谈。
置信统计被固定为最大标签概率:
其中 是评审器对第 个允许标签给出的概率, 是这些概率中的最大值,取值在 0 到 1 之间。论文用 绘制置信分布、计算错误检测 AUROC,并在 上使用“将错误判为正类、用 作为分数”的方法。相比口头置信度,这个量来自类型化概率分布;相比生成理由,它不需要额外 token。但它也不是校准证书:同一语义在 Choice、Noul 和 Score 原语之间会出现平均 0.055 的差距,四舍五入、共同问题上下文和随机波动都会影响概率值,因此论文保留原生置信度只用于接口诊断,而不是替代 。
2 操作包络:JEV 在何种负载接近 GPT-6
Table 2 是论文给出的核心地图。它不是按单一基准排序,而是按判断所需的认知工作分负载,并与每个负载中最强对照比较。
Table 2 报告了 JEV 与最强对照在不同负载上的准确率和配对差值:
| 负载 | 样本 | JEV | 对照 | 差值与区间 | 指导 |
|---|---|---|---|---|---|
| 普通偏好 | RewardBench 400 | 92.2 | GPT-6 93.5 | −1.3,−3.8 到 1.5 | 使用 JEV |
| 证据事实性 | HaluEval 240 | 87.5 | GPT-6 86.7 | +0.8,−1.3 到 2.9 | 使用 JEV |
| 最终答案裁决 | Existing labels 150 | 94.0 | GPT-6 96.7 | −2.7,−6.5 到 0.7 | 使用 JEV |
| 困难正确性 | JudgeBench 350 | 78.6 | GPT-6 93.1 | −14.6,−18.9 到 −10.3 | 升级 |
| 对抗风格配对 | RM-Bench hard 480 | 74.8 | GPT-6 94.6 | −19.8,−27.7 到 −12.7 | 升级 |
| 同风格配对 | RM-Bench normal 480 | 84.0 | GPT-6 93.3 | −9.4,−16.7 到 −2.9 | 升级 |
| 四选一选择 | RewardBench 2 100 | 73.0 | Skywork 79.0 | −6.0,−13.0 到 1.0 | 先验证 |
| 有文档摘要 | HaluEval summaries 80 | 71.2 | GPT-5.4 72.5 | −1.2,−10.0 到 7.5 | 先验证 |
| 无参照散文 | HaluEval general 80 | 52.5 | GPT-5.4 55.0 | −2.5,−11.2 到 6.2 | 不支持 |
表格背后的规律很明确:当输入自带参照答案或证据片段时,JEV 能接近最强模型;当判断变成“验证推导”或“抵抗写作风格”时,它无法仅靠便宜类型化接口补上。RewardBench 和 HaluEval 的差值接近零或区间包含零,论文也给出费用优势。Section 5 的匹配面板显示,JEV 中位延迟为 0.152 秒,每千次判决费用为 0.044 美元;GPT-4.1 mini 为 0.548 秒和 0.390 美元;GPT-6 为 1.885 秒和 12.182 美元。因此同一负载上,JEV 的 0.044 美元对 GPT-6 的 12.182 美元形成约 0.36% 的费用比例。
但基准标签本身不能直接作为最终裁判。Appendix I 的人裁显示,在 RewardBench 29 个分歧项中,人工裁定 17 次支持 GPT-6、5 次支持 JEV、7 次无法决定,人工差值为 −3.0 点,区间 −5.3 到 −0.8。HaluEval 上,GPT-6 在 10 个分歧项中赢 8 次,人工差值 −2.5 点;同时两个评审都判错的 26 项中有 24 项其实是标签不支持证据,修正标签后 JEV 为 95.8%,GPT-6 为 98.3%。这说明 HaluEval 的表面接近 partly 来自接近天花板处的标签噪声,真正稳健的结论是:在有证据的常规事实性判断上,JEV 与 GPT-6 的差距在三个百分点以内。
3 置信级联:用平均后的最大概率做路由
论文的核心机制不是让 JEV 永远正确,而是让它给出一个可门控的第一关。对于成对偏好判断,单次呈现顺序会带来不稳定,因此作者采用两阶平均:先按 和 两种顺序询问,再把概率折算回同一语义标签。
其中 表示当候选按 呈现时,JEV 给第一位置候选 的概率; 表示反向呈现时给第一位置候选 的概率,因此 被折算回语义候选 。这个式子的作用是把位置漂移压进置信分布中,而不是把它当成模型偏好。若两次都选择 , 接近 1;若一次选 、一次选 , 接近 0.5,门控更可能拒绝接受并触发升级。论文对 exact tie 给半分,并在 Table 14 中显示反转会改变 JudgeBench 11.14% 的决策,而 JEV 的第一位置选择率接近 50%,说明问题不是单纯位置偏好,而是同一语义在不同顺序下概率不稳定。
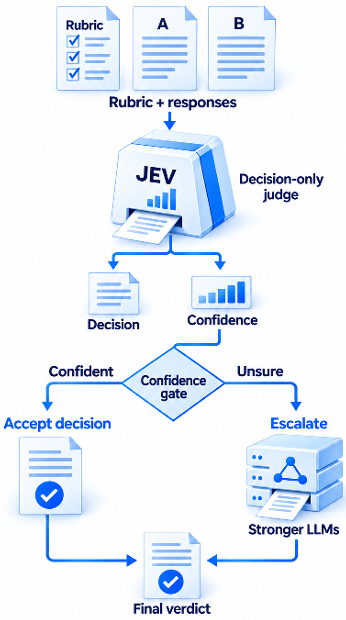
冻结策略的证据来自 Table 3。三个策略在 510 个扩展配对上离线模拟,阈值先在 96 个 pilot selection pairs 上选定,再在扩展集上评估。
Table 3 报告了三条冻结两阶 JEV 级联策略的结果:
| 备用模型 | 阈值 | 接受比例 | 级联准确率 | 备用模型准确率 | 差值与区间 | 费用比例 |
|---|---|---|---|---|---|---|
| GPT-5.4 | 0.90 | 53.7 | 91.4 | 91.6 | −0.2,−1.2 到 0.8 | 0.639 与 1.096 |
| GPT-5.6 Sol | 0.70 | 81.0 | 91.0 | 93.3 | −2.4,−4.5 到 −0.2 | 0.288 与 0.380 |
| GPT-6 Astra | 0.90 | 53.7 | 92.5 | 93.1 | −0.6,−1.8 到 0.6 | 0.568 与 0.622 |
GPT-6 策略最能说明级联的意义:它接受一半多一点判断,准确率仅比 GPT-6 单独运行低 0.6 点,却只花 56.8% 的费用;保守费用上限为 62.2%。GPT-5.6 策略也接受 81% 配对,但下降 2.4 点,超出了论文设置的两点容忍区间。Appendix Table 11 还显示,三条阈值为 0.5 的策略实际上退化成完全不升级的顺序平均,因此不能只看接受比例高低,必须看阈值是否真的把错误留出来。
Figure 5 给出置信排序为什么有效。JEV 在 低于 0.6 的 65 项 pooled 判断上只对 47.7%,在 为 1 的 322 项上达到 99.1%。单阶级联在阈值 0.90 时 pooled 准确率 91.3%,GPT-6 单独为 91.7%,保留 99.6% 的 GPT-6 准确率,费用为 47%;随机升级同比例只能达到 88.1%,标签知晓 oracle 为 94.4%,说明 大约捕捉到可获得收益的一半。
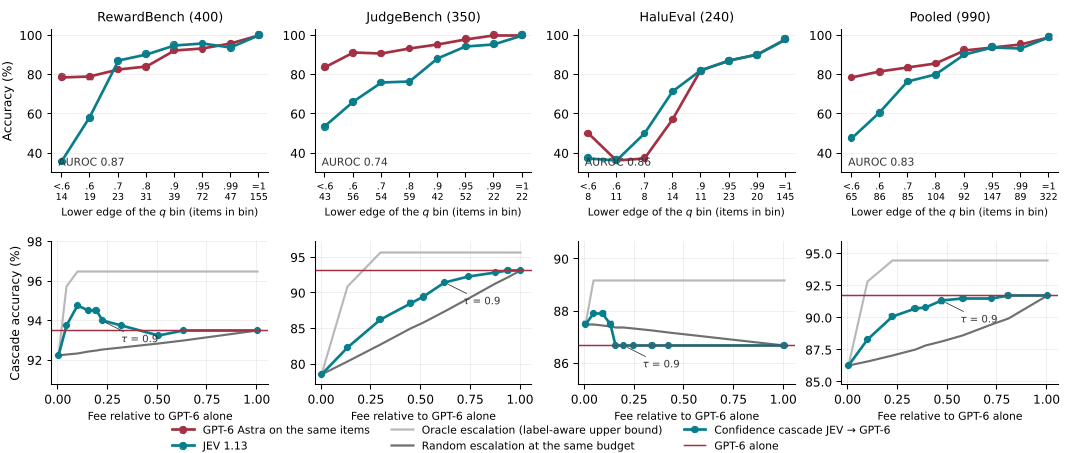
级联的边界同样清楚。RM-Bench hard pairs 上, 对正确性的 AUROC 从 easy pairs 的 0.918 和 normal pairs 的 0.902 掉到 0.770;在 位于 0.9 到 0.95 的判断中,JEV 错掉三分之一,在 0.95 到 0.99 中错掉 15%。无参照散文中,JEV 错误检测 AUROC 为 0.518,接近随机,任何阈值都不能帮助路由。换言之,置信级联只在“第一关有能力但知道自己不确定”的区域工作;当第一关被错误风格误导时,高置信本身成为陷阱。
实验与证据
主结果来自 Table 1。JEV 在 RewardBench、JudgeBench、HaluEval 和 existing labels 上分别为 92.2、78.6、87.5 和 94.0;GPT-6 为 93.5、93.1、86.7 和 96.7。这个对比不能简单读成“JEV 全面接近 GPT-6”,因为 JudgeBench 的差距 14.5 点很稳定,且 Figure 7 显示 reasoning 和 coding 子集差距最大,分别低 27.5 点和 21.4 点。知识子集差距最小,只有 6.5 点,这与任务是否要求多步验证高度相关。
拆解性证据主要有三类。第一是稳定性:Table 14 显示 JEV 在 96 次重复请求中不改变决策,但 48 个改写规则中有 4 个改变;反转后 RewardBench 决策变化 3.25%,JudgeBench 决策变化 11.14%,两阶都正确的准确率分别为 91.0% 和 74.0%。第二是概率质量:JEV 在 RewardBench、JudgeBench 和 HaluEval 的 Brier score 为 0.111、0.297、0.176,GPT-6 为 0.104、0.095、0.245。GPT-6 在更难的 JudgeBench 上更强,但 HaluEval 的误差排序中 JEV 的 Brier 更低而 GPT-6 的 AUROC 更高,说明校准与错误排序是两个不同性质。第三是人工裁定:Appendix I 的 S2 stratum 暴露了 HaluEval 标签噪声,24 个“两个评审都错”的项目中,人裁支持评审而不是基准标签;修正后两者都到 95% 以上。
论文还提供了少量控制实验。Appendix H 的 rubric ablation 将 JudgeBench 指令改为优先最终答案正确性,JEV 的 base accuracy 从 78.6% 升到 79.4%,paired 变化 0.86 点,区间 −1.14 到 3.14,因此规则措辞不足以解释与 GPT-6 的差距。Appendix J 显示同一内容从多项选择改为自由文本时,JEV 直接 agreement 从 100.0% 降到 92.5%,下降 7.5 点,但这一差距远小于任务负载之间十几个百分点的差距,说明答案格式不是主要失效机制。
证据质量方面,论文自己指出比较的是完整 hosted 配置,不是计算量匹配的架构研究。JEV 是专有服务,训练重叠和 benchmark contamination 未知;本地 Qwen 与 hosted 服务使用不同推理设置;Skywork 的标量 reward 不参与概率校准;扩展分析是在看到 pilot 结果后加入的,因此多模型比较是探索性。级联费用是离线模拟,不能推出真实串行延迟;单阶级联阈值是事后读取,只有 Table 3 和 Appendix Table 11 的冻结两阶策略构成预先规定的测试。
深度洞察与总结
这篇论文最实质的推进,是把 LLM 评审从“模型能力排名”改写成“工作负载操作策略”。JEV 的贡献不是证明便宜模型更聪明,而是证明在一个明确接口下,类型化决策和最大概率可以共同支持接受或升级。只要任务有参照、有证据,或者只需要提取最终承诺,JEV 就能接近 GPT-6 并大幅降低费用;只要任务需要检查推导链条、抵抗冗长风格或处理无参照散文,置信信号就会退化。
这项工作的价值在于可操作性。工程上可以把 JEV 用作 prefilter,而不是 final judge:对所有判断先做两阶顺序平均,再按本地选择集拟合阈值;接受高置信项,升级低置信项。论文给出的清单很具体:偏好成对判断要两阶平均;阈值不能跨 fallback 或负载直接迁移;无效输出必须计入错误;置信度是升级信号而不是可靠性证书;新负载需要小范围本地验证。
局限性同样应被读成使用警告。JEV 只有一个专有版本,费用估计不是发票,延迟只反映一个客户端和服务窗口;人裁只覆盖 183 个分歧项,不是随机审计,也不是多人共识;基准标签保留原样,人工修正准确率只是 sensitivity analysis。若把这些限制放到一起,论文的稳健结论并不是“所有评审都可以用 JEV”,而是“JEV 是某些负载下的低成本第一关,其价值取决于能否在本地验证中识别自己何时不可信”。