
Just-in-Time Memory:把 Agent 记忆从写时固化改成读时重塑
Just-in-Time Memory: Learning to Curate Task-Adaptive Memory for LLM Agents
本文提出 Just-in-Time Memory,亦即 JITMEM,用于让大语言模型智能体在读取记忆时依据当前任务重构经验。核心做法是存储原始轨迹并在任务到来时用训练过的 memory curator 合成 task-adaptive payload,再由 frozen executor 执行任务。该方法在 ALFWorld、WebShop 和 tau2-bench 上超过 no-memory 与 write-time memory baselines,相对最强 baseline 分别提升 16.2、16.3 和 3.9 个绝对成功率点。
TL;DR
JITMEM 重新安排了 LLM agent 记忆系统中的 curation 时刻:不再在任务结束后把轨迹压成固定 artifact,而是在新任务到来时,从持久化的 raw trajectories 中检索若干段经验,并由 memory curator 依据当前任务合成一段即时可用的 task-adaptive payload。这个设计把 curator 的学习目标从“未来是否有用”转为“现在是否让本任务成功”,从而绕开写时记忆常见的长程 credit assignment。论文在 ALFWorld、WebShop 和 tau2-bench 上报告了明显增益,相对最强 baseline 分别提升 16.2、16.3 和 3.9 个绝对 SR 点;同时,未经 RL 训练的 read-time curator 也已经在多个设置上接近或超过 write-time baselines。
背景定位
如果把 agentic memory 领域按“记忆何时被塑形”划分,JITMEM 不是单纯在某个检索器或提示模板上做增量优化,而是在挑战主流范式:大多数 Reflexion、Voyager、Agent Workflow Memory、ReasoningBank、MemP、SkillOS 一类方法都在任务完成时生成可复用摘要,然后靠相似检索把摘要重新塞回 context。JITMEM 更像是一个系统层面的重新分配:它保留完整 episode 作为 episodic store,把压缩与改写推迟到任务已知之后。论文最有力的一点并非 RL 训练本身,而是它通过 Table 1、Table 2 和 Table 9 证明,即使 curator 未训练,仅靠 read-time task-adaptive curation 也能产生可观优势;RL 训练则是在这个已经正确的结构上进一步放大收益。
问题与动机
写时记忆的问题不是“摘要质量不够好”,而是摘要形成时刻太早。一个任务结束后,系统必须决定哪些细节值得留下。 household trajectory 里可能同时包含状态转换模式、物体放置策略、搜索措辞偏好和工具调用顺序,但未来某个 query 只需要其中一类信息。若系统已经把它蒸馏成固定 skill 或 reflection,之后任务再需要另一种视角时,无法恢复被丢弃的信息。这个失效机制在论文中被称为“premature and irreversible information loss”。它还有一个学习侧困难:一次写入的价值要等到若干任务之后被相关 query 命中才显现,因此训练写时 curator 会面对 delayed reward 和 task grouping 问题。
作者的核心直觉来自认知科学中的 reconstructive memory:记忆不是被动回放,而是根据当前目标重建。这个直觉不是纯工程猜测,论文用三类证据支撑:第一,未训练的 JITMEM 在 WebShop 上使用 Gemini-2.5-Pro 达到 61.0 SR,而 SkillOS-gemini 只有 41.0 SR;第二,消融显示去掉当前任务条件、丢弃原始轨迹或强制空检索都会显著掉点;第三,GRPO 训练曲线表明 curator 的提升伴随执行步数下降,说明它学到的是如何服务当前任务,而不是单纯生成更长提示。
核心章节:从写时蒸馏到读取时合成
写时记忆的隐含形式:固定 artifact 必须服务未知未来
主流 write-time memory 的共同流程可以概括为:任务 完成后,生成轨迹 ,再立即蒸馏为一个可检索对象,例如反思、洞察、workflow、skill 或 reasoning strategy。之后的检索只依赖未来 query 与该对象的相似度,而不是依赖未来 query 与原始 episode 的任意细节。ReasoningBank 是其中较有代表性的实例:论文第 2 节指出它用 prompted LLM 蒸馏 transferable reasoning strategies,并用 cosine similarity 检索。SkillOS 更把 curator 写成 RL-optimized policy,但因为它仍发生在写时,奖励必须延迟到未来任务命中,所以论文特别指出它需要 grouping related tasks,并且需要额外 content-quality judge 来构造复合奖励。
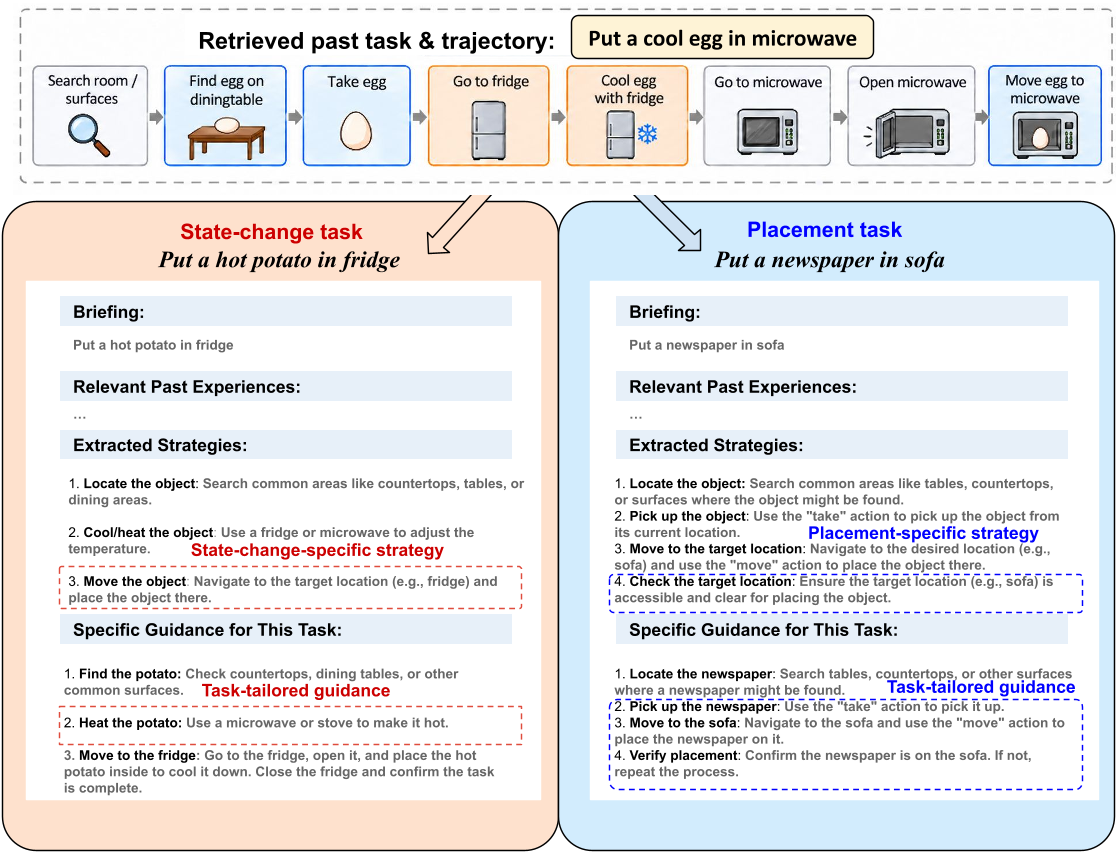
这一范式的失效机制是双重的。第一重是信息论意义上的不可逆压缩:只要某个字段在蒸馏时没被保留,后续任务就无法请求它。第二重是任务适配性缺失:同一段经历对不同任务可能意味着不同 lesson,但固定 artifact 只能预先选择一种 lesson。论文在 Figure 3 中用两个 ALFWorld 任务直观说明这一点:两个不同任务检索到同一段过去经验,一个被 curator 强调 state-change,另一个被强调 placement;如果这条经验已经在写时被蒸馏成单一摘要,系统就无法同时保留这两种读法。
JITMEM:存储无损,蒸馏发生在任务已知之后
JITMEM 把系统拆成四个动作:检索、策展、执行、更新。论文 Section 3 给出的核心形式可以写成:
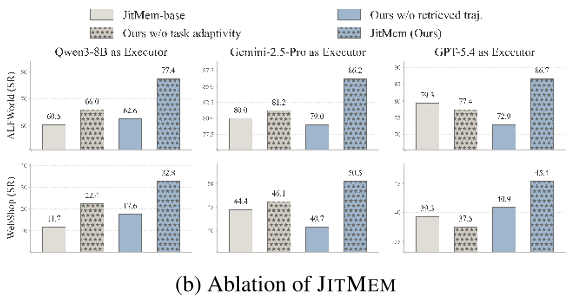
其中 是当前任务, 是截至第 步的 memory bank, 是检索器, 是被取回的 top-k 原始轨迹, 是 memory curator, 是任务条件化的 payload, 是 frozen executor, 是本次交互产生的新轨迹, 是任务奖励。这个式子承担整篇论文的机制转换:它把“检索什么”从相似摘要扩展为相似原始 episode,把“如何使用记忆”从直接拼接 artifact 变成先由 curator 按当前任务重组。相比写时方法, 不进入 memory bank,只是临时给执行器看的 briefing;真正持久化的是 raw trajectory。若把式中的 从 curator 输入移除,系统退化成 query-independent summarizer;论文 Table 9 的 “w/o task adaptivity” 显示这会使 JITMEM-base 在 ALFWorld 上最多掉 3.1 SR,在 WebShop 上最多掉 4.6 SR,RL 后的掉点更扩大到 11.4 和 10.4。
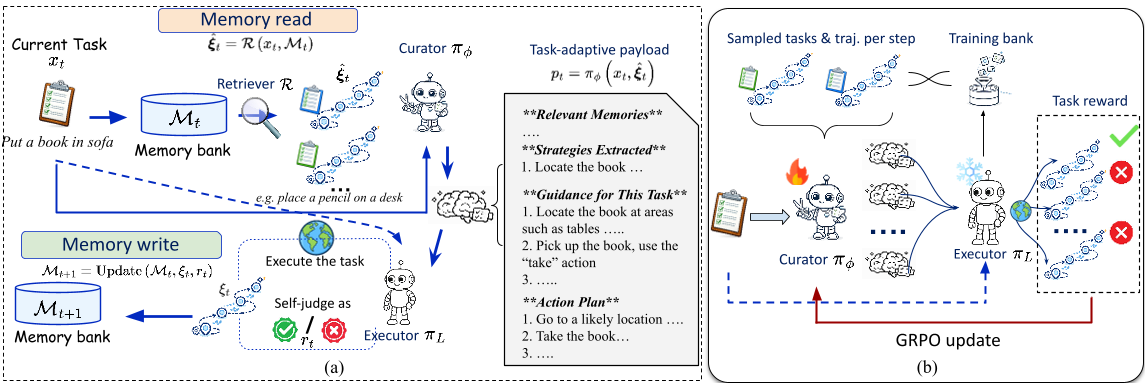
Figure 1 上半部分是 inference pipeline:给定 ,retriever 从 memory bank 取回 raw trajectories,curator 生成 payload,executor 执行任务,随后 executor-as-judge 判断轨迹是否成功,成功者写回 bank。下半部分是 training pipeline:采样一个任务,从 fixed training bank 检索轨迹,curator 生成多个候选 payload,frozen executor 分别尝试并返回 same-task reward,再更新 curator。论文 Appendix A 指出主结果使用 BM25,只基于任务描述检索,而非轨迹内容,并且 ;这个选择是为了保持 retrieval 轻量并与 baseline 一致,同时不让框架依赖特定检索器。Appendix Table 8 进一步显示 与 在 WebShop 上的 SR 变化小于 2 点,说明主结果对 不敏感。
这里还有两个容易被忽略的设计边界。第一,memory bank 存储的是完整 trajectory,包括任务描述和 observation-action 序列;论文第 4.2 节消融显示,如果用 ReasoningBank-style write-time distillation 替代 raw storage,JITMEM-base 在 ALFWorld 上掉 1.7 至 2.9 SR,在 WebShop 上掉 6.8 至 8.2 SR。第二,论文用 executor 自己作为 LLM-as-judge,在部署时无法获得 ground-truth success labels 的情况下只存 judge 认为成功的轨迹。Table 9 消融显示,把“过滤失败轨迹”改成“存储全部轨迹并标注成功或失败”会让 JITMEM-base 在 ALFWorld 上掉 1.5 至 2.9 SR、在 WebShop 上掉 2.3 至 3.4 SR。也就是说,即使 curator 能看到正确性标签,失败轨迹仍会污染 retrieval signal,这支持了 quality-filtered storage 的价值。
GRPO 把 credit assignment 压到一步:任务奖励就是 curator 奖励
JITMEM 的 curator 使用 GRPO 训练。论文 Section 3 给出的目标是:
其中 是同一个任务和检索上下文下生成的候选 payload 数量, 是第 个候选, 是 frozen executor 使用该候选完成同一任务 后得到的即时奖励, 是组内优势。论文说明优势按 构造,并遵循 Liu 等人 2025 去掉标准差归一化。这个式子在论证链中的关键不是算法新颖,而是 reward-to-action 的时间距离为零:curator 生成了用于当前任务的 payload,当前任务的成败直接评分这个 payload。相比写时 curator,它不需要判断“这个记忆未来是否会被某个任务需要”,也不需要人为把相关任务分组制造延迟依赖。Appendix Table 7 给出训练配置:base curator 为 Qwen3-8B non-thinking,group size 8,最大 RL steps 100,learning rate ,并启用 low-variance KL loss,coef ,reward 内 KL disabled。
若去掉组内 baseline 而直接用 ,梯度会保留共同偏好,方差更高;若把 替换为无关的 content-quality judge score,curator 可能学会写得像总结但未必帮助执行。论文的消融支持前一种担忧确实存在:在 RL-trained JITMEM 中强制 retriever 返回空集,ALFWorld SR 最多下降 14.8,WebShop SR 最多下降 15.2。这说明 RL 学到的不是绕过 retrieved experience 的 parametric hints,而是如何蒸馏被检索到的 episodic traces。Figure 4 进一步显示,untrained curator 给出通用动作序列,RL-trained curator 则恢复环境特定 workflow,例如 ALFWorld 中先移动到 desklamp 再用它检查 bowl。由于 curation prompt 并没有指定这类环境细节,论文认为这是 immediate task reward 促使 curator 学习任务相关程序性指导的证据。
实验与证据
主结果:read-time 优势来自机制而非单纯 curator 能力
Table 1 的第一块报告 Qwen3-8B 作为执行器、Qwen3-8B 作为 curator 的结果:
| 方法 | Curator | ALFWorld SR | WebShop Score | WebShop SR |
|---|---|---|---|---|
| No Memory | 无 | 47.9±1.2 | 33.3±0.7 | 9.8±0.5 |
| ReasoningBank | Qwen3-8B | 55.7±3.1 | 35.4±1.1 | 11.4±0.9 |
| MemP | Qwen3-8B | 49.7±0.7 | 35.7±0.9 | 12.0±0.5 |
| SkillOS-base | Qwen3-8B | 53.1±2.5 | 38.6±0.9 | 13.6±0.8 |
| SkillOS | Qwen3-8B | 61.2±4.6 | 40.6±0.7 | 16.5±0.7 |
| JITMEM-base | Qwen3-8B | 60.5±2.6 | 32.5±3.2 | 11.7±0.5 |
| JITMEM | Qwen3-8B | 77.4±2.9 | 61.1±0.9 | 32.8±1.7 |
这组数字揭示了两层贡献。第一层是 read-time 机制本身:JITMEM-base 未训练时已在 ALFWorld 上接近 RL-trained SkillOS 的 60.5 对 61.2,但在 WebShop SR 上明显落后 11.7 对 16.5,说明未训练 curator 还不足以在所有环境都发挥机制潜力。第二层是 RL 训练:JITMEM 把 ALFWorld SR 从 61.2 提升到 77.4,把 WebShop SR 从 16.5 提升到 32.8,论文分别标注 +16.2 和 +16.3 absolute SR points。Table 1 的 Gemini-2.5-Pro 块也保持同向:JITMEM 在 ALFWorld 达 86.2±1.9,较 SkillOS 的 80.2±3.1 提升 6.0 点;WebShop SR 达 50.5±0.8,较 SkillOS 的 41.3±0.8 提升 9.2 点。GPT-5.4 块中,trained curator 以 Qwen3-8B curator 身份在 ALFWorld 达 86.7±0.7,较 no-memory 的 62.6±0.3 和 ReasoningBank-gpt 的 77.9±4.2 均明显更高,说明收益并不依赖 curator 和执行器同属最强模型。
tau2-bench 更强调多轮工具调用和 domain policy。Table 2 显示,在 GPT-5.4 执行器下,JITMEM-gpt 的 micro average SR 为 75.6±2.3,高于 ReasoningBank-gpt 的 71.7±3.9 和 SkillOS-gpt 的 66.4±1.9,论文摘要给出较最强 baseline 提升 3.9 点。分域看,Telecom 增益最大,正文写为 +11.0,而 Airline 和 Retail 多数记忆方法相对 no-memory 没有稳定超出方差。这个现象说明 read-time curation 更适合需要 procedural guidance 的任务,而不是单纯 fact retrieval。
拆解性证据:每个设计选择都被消融命中
论文 Table 9 和 Figure 2 对三个主要设计选择逐一移除:task-adaptive conditioning、quality-filtered storage、raw trajectory retention。Figure 2a 对 training-free JITMEM-base 的结论是:去掉当前任务会降低 ALFWorld 与 WebShop 表现,去掉成功轨迹过滤也会掉点,而把 raw trajectory 换成 write-time distillation 在 WebShop 上造成最大损失之一。Figure 2b 则对 RL-trained JITMEM 给出两个更有价值的探针:去掉 retrieved trajectories 后,模型掉到甚至低于 untrained JITMEM-base;去掉 task conditioning 后,训练模型掉点幅度大于未训练模型。论文第 4.2 节解释为 RL 学到的是如何利用 task signal 重组经验,而不是单纯把轨迹压缩得更短。
效率证据同样重要。Table 4 报告 ALFWorld 上 GPT-5.4 executor 的平均 token 和 step:
| 方法 | 输入 Token | 输出 Token | 执行步数 |
|---|---|---|---|
| No Memory | 9.0 | 1.40 | 17.8 |
| ReasoningBank | 19.7 | 1.26 | 16.2 |
| SkillOS-base | 22.4 | 1.36 | 16.9 |
| JITMEM-base | 10.9 | 1.00 | 13.2 |
| JITMEM | 9.8 | 0.87 | 11.6 |
这张表反驳了一个常见误解:记忆系统变强只是因为塞进更多 context。JITMEM-base 相对 no-memory 只多 1.9K 输入 token,而 ReasoningBank 多 10.7K、SkillOS-base 多 13.4K。JITMEM 则几乎与 no-memory 的 9.0K 持平,却把执行步数从 17.8 降到 11.6。论文摘要概括为相对 write-time methods 输入 token 减少 50.3% 至 56.3%,执行步数减少 28.4% 至 31.4%。这与其说证明 curator 更会写长提示,不如说证明它提高了 context 的信息密度,使 executor 更少绕路。
迁移能力是方法解耦价值的直接证据。Table 3 报告 ALFWorld 上的 executor transfer:
| Curator training | Qwen3-8B executor SR | GPT-5.4 executor SR |
|---|---|---|
| No training | 60.5±2.6 | 79.3±3.6 |
| Trained with Qwen3-8B executor | 77.4±2.9 | 86.7±0.7 |
| Trained with GPT-5.4 executor | 论文未给出 | 88.1±0.9 |
从 Qwen3-8B 训练出的 curator 迁移到 GPT-5.4 执行器时达到 86.7±0.7,与直接用 GPT-5.4 执行器训练的 88.1±0.9 只差 1.4 SR 点。论文正文还指出该 curator 相对 JITMEM-base 在两个强执行器上 ALFWorld 提升 6.2 和 7.4 点,WebShop 提升 6.1 点。这说明 curator 学到的是较通用的 curation strategy,而不是只适配训练执行器的特定 prompt pattern。
证据质量方面,JITMEM 的主结论在 ALFWorld 与 WebShop 上较强,因为三个执行器、多个 curator 组合、RL 与 non-RL 变体都有数字;tau2-bench 只评测 training-free variants,原因是论文指出该 benchmark 缺少标准 training split,且合成有效训练数据仍是 open problem。因此 tau2-bench 的 3.9 点提升更支持 read-time 机制,而非 RL 训练本身。静态 training bank 也带来 mild distribution shift:Table 5 显示 staged bank refresh 仅在 Qwen3-8B WebShop SR 上带来 2.8 点、GPT-5.4 带来 0.9 点,Gemini-2.5-Pro 没有变化,说明这个近似已足够支撑主要性能,但仍不是完全闭环的训练设置。
深度洞察与总结
JITMEM 的真正贡献是把 agent memory 的设计问题从“如何压缩过去”转移到“何时压缩过去”。它在架构上分离了 storage 与 curation:storage 负责无损保留 episodes,curation 负责在任务已知时做选择性重建。这个分工让同一个 stored trajectory 可以派生不同 payloads,也让 curator 的优化目标从 delayed utility 变为 immediate task success。GRPO 在这里不是为了让记忆系统获得某种神秘 RL 能力,而是把“读时策展”变成一个可微分策略:curator 生成候选 briefing,frozen executor 立即用任务成败投票,优势项直接强化有效 briefing。Table 4、Table 3 和 Figure 2 分别证明这个机制同时改善紧凑性、迁移性和对 retrieved experience 的依赖。
局限性也很具体。首先,retriever 是 BM25,且只基于任务描述检索;论文第 5 节承认 memory bank 变大变杂时它可能成为瓶颈,但论文未报告大规模 bank 下的检索召回或延迟曲线。其次,quality gate 使用同一 executor 作为 judge;如果 judge 把失败轨迹误判为成功,positive exemplar 假设会被破坏,论文虽在 tau2-bench 附录给出 strict judge prompt,但没有报告 judge precision 和误存率。第三,主训练设置中 curator 只在 Qwen3-8B 上训练 100 GRPO steps,训练 bank 是 fixed training bank,staged refresh 只带来较小增益,说明长期在线 bank 增长下的训练动态仍缺少证据。第四,payload format 是每个 benchmark hand-designed,Appendix A 的 prompts 显示 ALFWorld、WebShop 和 tau2-bench 各有不同 brief;论文未证明自动学习 payload schema 是否比固定 schema 更优。第五,tau2-bench 没有 RL-trained JITMEM 结果,因此 3.9 点提升不能直接归因于 GRPO,只能归因于 read-time curator。
后续工作最有技术价值的方向不是简单更换更大模型,而是把 read-time 机制继续展开:第一,把检索器与 curator 联合优化,因为当前 BM25 只按任务描述取 top-3,可能限制复杂工具调用任务的覆盖;第二,把 task-level curation 细化到 turn-level 或 step-level,使新 observations 到来时能动态改写 payload;第三,为 memory bank 增加长期维护策略,例如 episodic aging、hierarchical indexing 或失败轨迹的可控使用,而不是默认只保留成功 exemplars;第四,把 LLM-as-judge 替换为可验证 reward 或双模型仲裁,降低误存轨迹进入 bank 的风险。JITMEM 已经说明记忆的关键不只是“记住”,而是“在正确任务上下文里以正确粒度重构”。