
KVMEM:把百万 token 智能体工作区虚拟到一张笔记本 GPU 上
KVMem: Virtualizing Million-Token Agent Workspaces on a Consumer GPU
KVMEM 将长期运行智能体的溢出历史虚拟化为跨 GPU、主机内存和 NVMe 的分页 KV 工作区,在每个智能体步用模型原生注意力索引选取相关历史块,并在受限上下文中构造可执行视图。相比文本压缩与检索重预填充,它在多个长历史基准上保持高任务保真度,同时把恢复延迟降低到约一秒量级。论文还证明在 24GB 笔记本 GPU 上可支持 1M token 虚拟工作区和约 50 tokens/s 的单会话生成。
核心速览
TL;DR
KVMEM 是面向长期运行 LLM 智能体的 KV 上下文虚拟化系统。它不再把溢出历史压缩成文本摘要,而是保留为可分页的 KV 状态,并在 GPU、主机内存和 NVMe 之间按需迁移;每个智能体步使用由服务模型自身注意力空间派生的 Mean-K 索引选择相关历史块,再在原生窗口预算内重建位置一致的执行视图。论文中,KVMEM 在 LongMemEval-S、MemoryAgentBench 和 AgentLongBench 上普遍保持接近或高于文本检索式压缩的任务效用,同时将 Compact+RAG 的恢复延迟从 26.63 秒到 416.38 秒降低到 0.48 秒到 1.81 秒;在消费级 24GB RTX 5090 Laptop GPU 上,它可以支持 1M token 虚拟工作区,并维持约 50 tokens/s 的单会话生成速度。
背景定位
这篇论文更像一篇系统工程与推理调度方向的工作,而不是新的模型训练算法。它处理的是当前 coding agent、notebook agent 和长会话智能体共同遇到的真实限制:模型标称上下文窗口、GPU KV 容量和持久工作区规模并不相等。论文的贡献不在于证明某个注意力数学性质,而在于把虚拟内存、分页、页表、缓存层级和 RoPE 位置重建结合起来,让“曾经处理过的 KV”重新成为可访问资源。它与 vLLM、LMCache、CacheBlend 的关系是互补而非替代:KVMEM 需要构建一个随查询变化的稀疏历史执行视图,而这超出了传统请求级前缀缓存的抽象。
问题与动机
智能体工作区可以持续积累文件读取、工具输出、执行日志、中间产物和用户约束。论文指出,这里存在两层不同的限制:第一,即使全部历史仍在模型原生窗口内,GPU 也未必能同时容纳所有 KV 状态;第二,历史可能直接超过模型原生窗口,例如 Qwen3.6-27B 的原生窗口为 256K token,而 AgentLongBench 中的轨迹可超过百万 token。无论哪一种,都必须让一些曾经处理过的上下文离开活动输入。
现有系统通常采用文本中心处理:用压缩摘要替换旧历史,或者把旧历史存入外部文本库,之后检索片段并重新放入 prompt。论文第 2.2 节用一个不可区分性论证说明了这一方法的理论边界:
其中 和 是两条不同的历史工作区, 是压缩函数。该式的意义是,如果压缩是有损的,就可能把两个未来答案不同的历史映射到同一个摘要上。此后面对依赖差异细节的查询 ,模型只看到同一个 ,无法从摘要本身恢复被删差异。若增大摘要预算,只能缓解而不能消除该问题,因为预算仍然消耗活动上下文,最终仍受窗口限制。
文本检索可以恢复一些被删证据,但它带来第二个代价:检索到的文本曾经被预填充过,之后又被重新处理。论文第 2.3 节把传统路径写成:
其中 是当前步骤检索到的历史文本, 是其 token 数。相比直接丢弃旧历史,这个式子揭示了检索恢复的隐性成本:检索本身可能很快,但把文本重新变成可用 KV 仍然需要 prefill。若未来查询依赖更多历史片段, 增大,成本随之上升。KVMEM 提出的替代路径是:
其中 是选择相关 KV 块的成本, 是从下层存储搬运 KV 的成本, 是把位置编码重建到当前紧凑视图中的成本。相比前一个式子,改动在于用“加载和重建已计算状态”替代“重新 prefill 文本”。这个路径是否更快取决于存储带宽、传输碎片和 RoPE 修复开销;但关键洞察是,只要历史已经被模型处理过,就不必仅仅因为它离开活动窗口就丢弃其计算结果。
核心机制:从文本记忆到可分页 KV 工作区
瓶颈定位:可寻址工作区必须独立于 GPU 驻留容量
论文把历史工作区切分为逻辑 KV 块,并定义三个容量限制:模型原生窗口、GPU 可驻留 KV 预算、以及主机内存和 NVMe 构成的后备工作区。活动执行视图的有效预算是:
其中 是模型原生 token 窗口, 是在给定权重、运行时缓冲、推测解码状态和 KV cache 竞争下可驻留 GPU 的 token 等价容量。这个式子在论文中承担“物理边界”角色:它说明实际可用上下文不是厂商标称最大值,而是窗口与显存共同决定的交集。若只考虑 而忽略 ,系统会错误地认为 256K token 历史可以全部保留;论文的消费级实验则显示,在 24GB RTX 5090 Laptop GPU 上,直接引擎只能提供约 10K 或 80K 的上下文执行能力,而 KVMEM 能把执行视图与虚拟工作区解耦,扩展到 1M token。
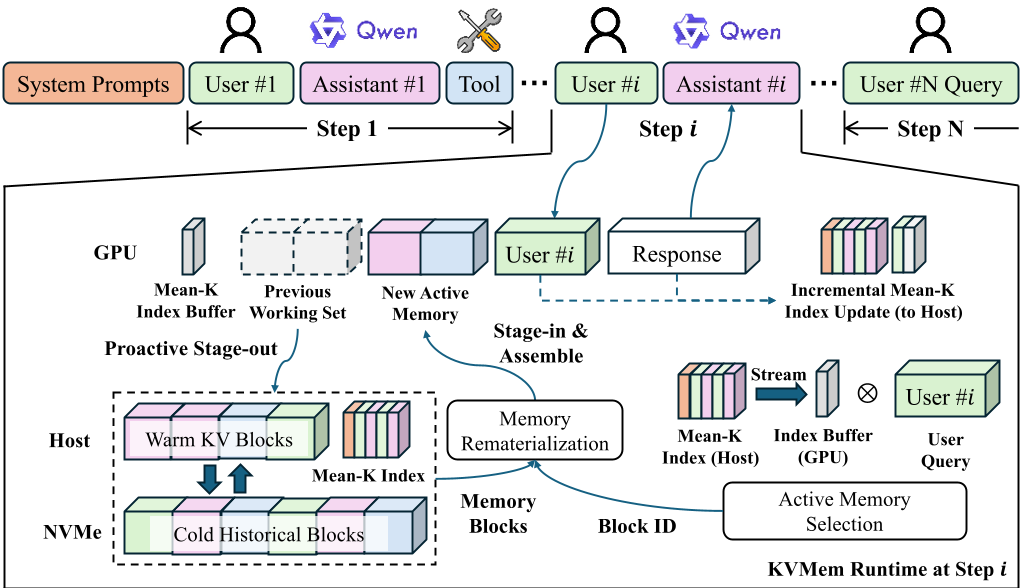
Figure 1 展示了 KVMEM 的三大机制:步级调度决定何时回忆,注意力空间检索决定回忆什么,分层 KV 管理决定如何恢复。三者共同构成一个步骤生命周期:当前 query 先预填充以产生检索信号,随后选择并恢复历史工作集,将当前上下文重放到组装后的执行视图,最后解码。解码期间历史工作集固定,新生成 KV 在尾部增长。
设计与权衡:步级注意力触发与 Mean-K 模型原生检索
KVMEM 的第一个问题是“何时回忆”。论文分析了八个 OpenHands SWE-bench Lite 轨迹,用相邻 128-token 滑动窗口比较注意力分布的 KL 散度。结果显示,同一个智能体步内相邻窗口的平均 KL 只有 0.070 bits,而跨越步边界的平均 KL 为 2.59 bits,高 37.3 倍。这说明历史相关性在步内变化缓慢,在步间发生突变。因此 KVMEM 选择每个 agent step 更新一次工作集,在 prefill 后、解码前执行,而不是每生成一个 token 都重选。这个设计用调度粒度换取更低的工作集重建成本。
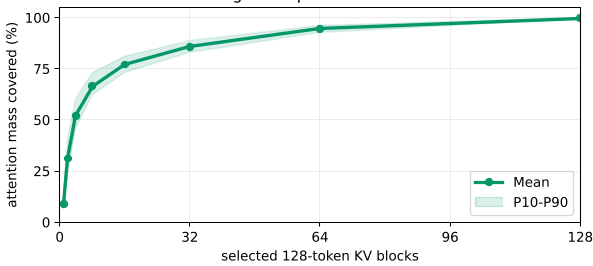
Figure 2 还显示历史注意力高度稀疏:每个窗口平均包含 103.1 个历史块,但 top-8 块覆盖 66.5% 的历史注意力质量,top-16 覆盖 77.0%。这为“不必物化整个工作区”提供了经验依据。
第二个问题是“回忆什么”。若逐 token 维护历史相关性,百万 token 工作区的索引容量和查询延迟都会失控;若用独立文本 embedding 检索,则信号未必对齐服务模型自身在注意力中对历史的使用方式。KVMEM 的解法是把 token 级检索降为块级检索,同时保留在模型原生 attention space 内。对于每个历史块 、层 和 KV head ,它构造:
其中 是 token 在移除 RoPE 后的位置无关 K 向量。这个式的核心作用是压缩检索索引:每个块每层每个 KV head 只存一个 Mean-K 向量,而不是全部历史 K tensor。若不做 RoPE 移除,块被重新映射到新的逻辑位置后,旧位置编码会污染相关性判断;若采用 token 级存储,索引大小随历史 token 线性增长,GPU 驻留查询也会变慢。Mean-K 的代价是丢失块内变化,论文给出的缓解方式是使用足够细的块,默认 32-token block。块越小,单个均值覆盖的语义跨度越短,异质性越低,但索引和块管理开销更高;论文未提供块大小的完整敏感性消融。
在检索时,KVMEM 用当前 query 的位置无关向量对候选块打分:
其中 是第 层、第 个 query token、第 个 query head 的位置无关查询向量, 是 grouped-query attention 下对应的 KV head, 是 head dimension, 是候选历史块集合。这个式子定义了块级相关性:对固定层头查询 token,候选块之间先做 softmax 归一化,再对所有查询 token 求和、对所有参与打分层头平均。相比外部文本相似度,它的优势是模型原生;相比逐 token 注意力评分,它的优势是索引紧凑。边界也很明确:sink 和 recent blocks 总是保留,剩余预算才由最大 的块填充;如果关键证据分散在多个低权重块或块内均值无法表示其相关性,仍可能漏选。
工程实现与代价:分层搬运、页表别名与位置一致重建
第三个问题是“如何恢复”。选中的历史块可能不在 GPU,且不能简单复制进 dense KV cache。KVMEM 分离 repository view 和 execution view:前者记录每个块的物理位置,后者只在 GPU 中容纳当前步选中的块,并通过页表映射非连续物理页到紧凑逻辑顺序。Page-table aliasing 只解决位置重排,不解决 K 的位置编码有效性。因此系统保留一份位置无关 raw K 作为重建权威,在需要时按新的紧凑位置重新应用 RoPE;V 位置无关,可直接复制。
连续步骤之间通常有重叠工作集。KVMEM 用差分更新决定必须加载哪些块:
其中 是当前步选择的历史块集合, 是上一步后仍驻留在 GPU page pool 中的所有历史块。这个式子说明“逻辑上需要”与“物理上需要搬运”并不相同:只要块还在 GPU 池中,就避免 host 或 NVMe 的 H2D 传输;只有逻辑选择但物理缺失的块才进入重物质化路径。论文还定义 retained、incoming、outgoing 三类块差,但公式未在此处展开;其含义与上式一致。
恢复路径还包含三项关键优化。proactive stage-out 在 chunked prefill 期间异步创建 host copy,使下一步工作集切换时能立即回收 GPU page,而不用等待写回;host-memory admission 同时考虑近期检索和累计频率,优先保留反复访问块,避免纯 LRU 将高频块误驱逐到 NVMe;packed and pipelined rematerialization 将散落的块聚合成连续 host buffer,批量 H2D 传输,并在 GPU 上 scatter 和 re-RoPE。
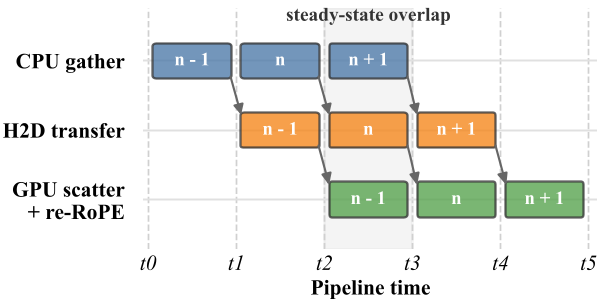
Figure 3 展示了为什么碎片化历史 KV 会让朴素 stage-in 变成大量小传输:每次只搬几个页会浪费 PCIe 带宽并放大 launch 和同步开销。打包把碎片变成批量,流水则把 CPU gather、H2D copy 和 GPU scatter/re-RoPE 重叠在相邻 batch 上。代价是系统必须维护 raw K、位置帧、host pinned buffer、GPU staging buffer 和 CUDA event 同步,工程复杂度明显高于单纯文本 retrieval。论文未公开给出完整开源实现细节,因此难以独立验证不同块大小、重建周期和索引 tile 大小之间的精确性能边界。
实验与证据
论文主实验分为三类:受控长历史效用、恢复效率、以及真实长程软件工程轨迹。控制实验使用 Qwen3.6-27B,在服务器平台上运行 Q8 权重和 FP8 KV cache;DeepSWE 实验使用 Qwen3.8-27B。Table 1 显示了三类基准上的效用结果:
| 设置 | Full Context | Sliding Window | Compact-only | Compact+RAG | KVMEM |
|---|---|---|---|---|---|
| LongMemEval-S 答案准确率 | 86.60 | 26.80 | 45.60 | 86.20 | 85.60 |
| MemoryAgentBench 超过 256K 总分 | 未提供 | 17.95 | 27.54 | 34.80 | 40.99 |
| AgentLongBench 256K 以内任务成功率 | 59.54 | 25.36 | 15.84 | 47.49 | 60.87 |
| AgentLongBench 512K 任务成功率 | 未提供 | 25.00 | 22.50 | 54.00 | 53.00 |
| AgentLongBench 1M 任务成功率 | 未提供 | 20.00 | 32.00 | 42.00 | 50.00 |
这些数字说明 KVMEM 的主要优势不是“在所有设置上全面超越所有基线”,而是同时保持较高保真度和极低恢复开销。LongMemEval-S 上,KVMEM 85.60% 与 Full Context 86.60% 仅差 1.0 个百分点,也接近 Compact+RAG 的 86.20%;但 Sliding Window 和 Compact-only 分别只有 26.80% 和 45.60%。在超过模型窗口的 MemoryAgentBench 上,KVMEM 40.99% 高于 Compact+RAG 34.80%。在 AgentLongBench 1M 上,KVMEM 50.00% 高于 Compact+RAG 42.00% 和 Compact-only 32.00%;但 512K 时 Compact+RAG 54.00% 略高于 KVMEM 53.00%,这表明检索选择并非总优于带文本重 prefill 的 RAG 路径,尤其当检索遗漏关键块时,文本重算仍可能补回部分效果。
效率证据更强。Table 1 还报告恢复延迟:KVMEM 的 pre-answer latency 在 0.48 秒、1.81 秒、0.38 秒、0.62 秒和 0.73 秒之间;Compact+RAG 在计入摘要生成时为 26.63 秒、106.02 秒、111.39 秒、263.70 秒和 416.38 秒;即使排除摘要生成,其 post-compaction recovery latency 仍为 10.63 秒、20.72 秒、14.80 秒、23.58 秒和 39.24 秒。论文据此给出 11.4 倍到 53.8 倍的恢复延迟降低。Table 2 对 LongMemEval-S 进一步拆解:Full Context 和 KVMEM 都处理 109.74K 总历史输入,但 KVMEM 只有 0.08K token 需要 fresh prefill,而 Compact+RAG 需要 31.00K token fresh prefill,因为检索文本必须重新进入 prompt 并再次计算 KV。这说明 KVMEM 的效率收益并非来自更少历史数据,而来自避免对历史重复做模型前向。
消费级部署方面,论文在 24GB RTX 5090 Laptop GPU、32GB 主机内存和 1TB NVMe 的笔记本上测试 Qwen3.6/3.8-27B NVFP4-MTP。Table 3 显示 vLLM 约支持 10K context token,llama.cpp 约支持 80K,而 KVMEM 使用 80K 执行视图但支持 1M 虚拟工作区;Section 6.4 报告单会话仍维持约 50 tokens/s。这个结果的判断需要谨慎:它并非说明 GPU 能同时注意 1M token,而是说明每个步物化约 80K 的受限视图,其余历史由分页 KV 工作区提供。服务器上的扩展性实验进一步支持这一点。Table 4 显示,当工作区从 256K 扩展到 10M,执行视图固定为 64K,GPU memory 保持在约 33.9 GiB 到 34.9 GiB,NVMe storage 从 8.5 GiB 增到 324.2 GiB,检索中位延迟从 0.174 秒增到 1.311 秒,TTFT 从 0.427 秒增到 1.601 秒,decode 速度大致在 75 tokens/s 到 86 tokens/s 之间。也就是说,工作区增长主要由 host/NVMe 和索引吸收,而不是线性压垮 GPU。
长程 agent 任务上,Table 5 和 Table 6 给出 DeepSWE v1.1 前 16 个任务、每个任务 4 次采样的配对实验:
| 配置 | Pass@1 | Pass@4 | 平均 prefill 时间 | 平均请求墙钟时间 | 平均智能体时间 | 平均解码输出 |
|---|---|---|---|---|---|---|
| Qwen3.8-27B plus KVMEM | 48.4% | 93.8% | 95.0 秒 | 40.7 分钟 | 45.8 分钟 | 125.6K tokens |
| Qwen3.8-27B plus Compaction-only | 43.8% | 81.3% | 211.5 秒 | 48.1 分钟 | 52.5 分钟 | 154.4K tokens |
KVMEM 的 Pass@1 提升 4.7 个百分点,Pass@4 提升 12.5 个百分点;它解决了 16 个任务中的 15 个,而 Compact-only 只解决 13 个。效率上,prefill 时间降低 55.1%,请求墙钟时间降低 15.4%,端到端 agent 时间降低 12.8%,解码 token 也减少 18.7%。这一点重要,因为它说明时间节省不是把计算压力转移到更长输出上;相反,KVMEM 同时减少输入处理和生成量。
证据质量方面,需要看到三类边界。第一,论文没有提供针对三大机制的逐项消融实验,例如只移除 Mean-K 改用外部 embedding、固定步级调度改为 token-level recall、或关闭 packed pipelined 后恢复延迟如何变化。因此我们能较强地判断系统组合有效,但不能精确拆解每一模块贡献。第二,DeepSWE 公共模型对比使用不同 harness,不能视为严格同条件模型排名;论文自己设置的 KVMEM 与 Compaction-only 对比才是配对控制。第三,受控基准中的工作区是可重放的,这有利于隔离 memory policy,但真实 agent 工作区可能有更复杂的动态工具调用、失败回滚和并发资源竞争,论文只评估单会话长任务。
深度洞察与总结
KVMEM 的核心贡献是把“被压出上下文的历史”重新定义为系统资源,而不是文本对象。相比 MemGPT 类外部文本记忆和 CacheBlend 类缓存融合,它的独特处在于同时要求三件事:模型原生相关性、跨层级物理驻留、以及非连续历史在新紧凑视图中的位置一致性。Mean-K 是其中最具解释力的设计:它用块级均值近似注意力相关性,把 token 级索引问题转化为 block 级选择问题,并把索引从 GPU 历史 KV 中剥离出来。只要块足够细,均值损失可以被接受;论文默认 32-token block,是在检索粒度、索引大小和管理开销之间的工程折中。
论文也诚实地指出三个不可回避的局限。第一,KV 复用不等价于重算文本:历史 KV 原本是在旧 causal context 下计算的,当前视图改变后仍有误差风险;系统用 re-prefill 当前 query、raw K 重建和周期 re-RoPE 来缓解,但没有提供数值误差的细粒度分析。第二,召回仍受检索质量限制:如果相关块没有被 Mean-K 排进 top budget,模型仍可能错过任务关键历史;扩大 active view 可降低这一风险,但会重新消耗窗口和 GPU 预算。第三,存储不是免费的:10M token 工作区带来约 324.2 GiB NVMe 和 9.5 GiB 索引,论文未说明这些数字随非 Qwen、非 RoPE、非单会话模型如何变化。
未来最有价值的方向不是继续简单扩大原生窗口,而是把 workspace virtualization 与更智能的块摘要、多向量索引和成本模型结合。例如,Mean-K 可以进一步与 learned block summaries 或 quantized attention profiles 组合,以减少块内异质性;32-token block 应通过自适应划分在长代码、短工具和稀疏日志中分别调整;packed transfer 的 tile 和 batch 大小也可能需要按 PCIe、NVMe 和模型层数共同优化。对云 API 而言,如果能将历史 KV 复用暴露给计费层,cached input 与 fresh prefill 的价差可能从根本上改变长程智能体的服务经济学。KVMEM 给出的现实启示是:长上下文智能体的下一步瓶颈正在从“模型能看多长”转向“系统能否把曾经算过的状态便宜、正确、安全地搬回来”。