
LaME:突破显式 CoT 瓶颈,在隐空间内为多模态检索注入“思考”
LaME: Learning to Think in Latent Space for Multimodal Embedding via Information Bottleneck
本文提出了 LaME,一种基于隐空间推理的多模态嵌入框架。该方法通过引入 K 个可学习的 Reason Tokens 作为信息瓶颈(Information Bottleneck),在单次前向传播中完成推理,实现了与显式 CoT 相当的性能,且推理速度提升了 60 倍。
TL;DR
在多模态检索领域,模型是否必须通过“说出”推理过程才能理解复杂查询?LaME(Latent Reasoning Multimodal Embedding)给出了否定答案。它摒弃了冗长的显式 CoT 文本生成,通过在 Transformers 输入端加入几个可学习的 Reason Tokens,并在信息瓶颈(Information Bottleneck)理论的指导下,实现了在单次前向(Single-pass)推理中完成深度思考。
背景定位
当前多模态嵌入(Multimodal Embedding)正从单纯的“对比对齐”(如 CLIP)转向“推理驱动”。然而,像 UME-R1 或 Think-Then-Embed 这种依赖自回归生成推理过程的方法,在面对数亿级的检索库时,速度慢到几乎不可商用。LaME 的出现,正是为了在推理能力与推理速度这对矛盾中找到最优解。
痛点深挖:显式 CoT 的“沉重枷锁”
- 推理延迟高:生成几十个单词的 CoT 意味着几十次自回归解码,对于检索任务来说是灾难性的。
- 标注依赖重:训练一个能生成好 CoT 的模型需要大量经过专家标注的冷启动数据。如果标注质量差,Embedding 的效果也会被“带偏”。
核心思路:让 Reason Tokens 成为信息瓶颈
作者认为,推理过程不需要通过文字展现,只需要在模型内部留出一块特定的“思维空间”。
1. 模型架构拆解
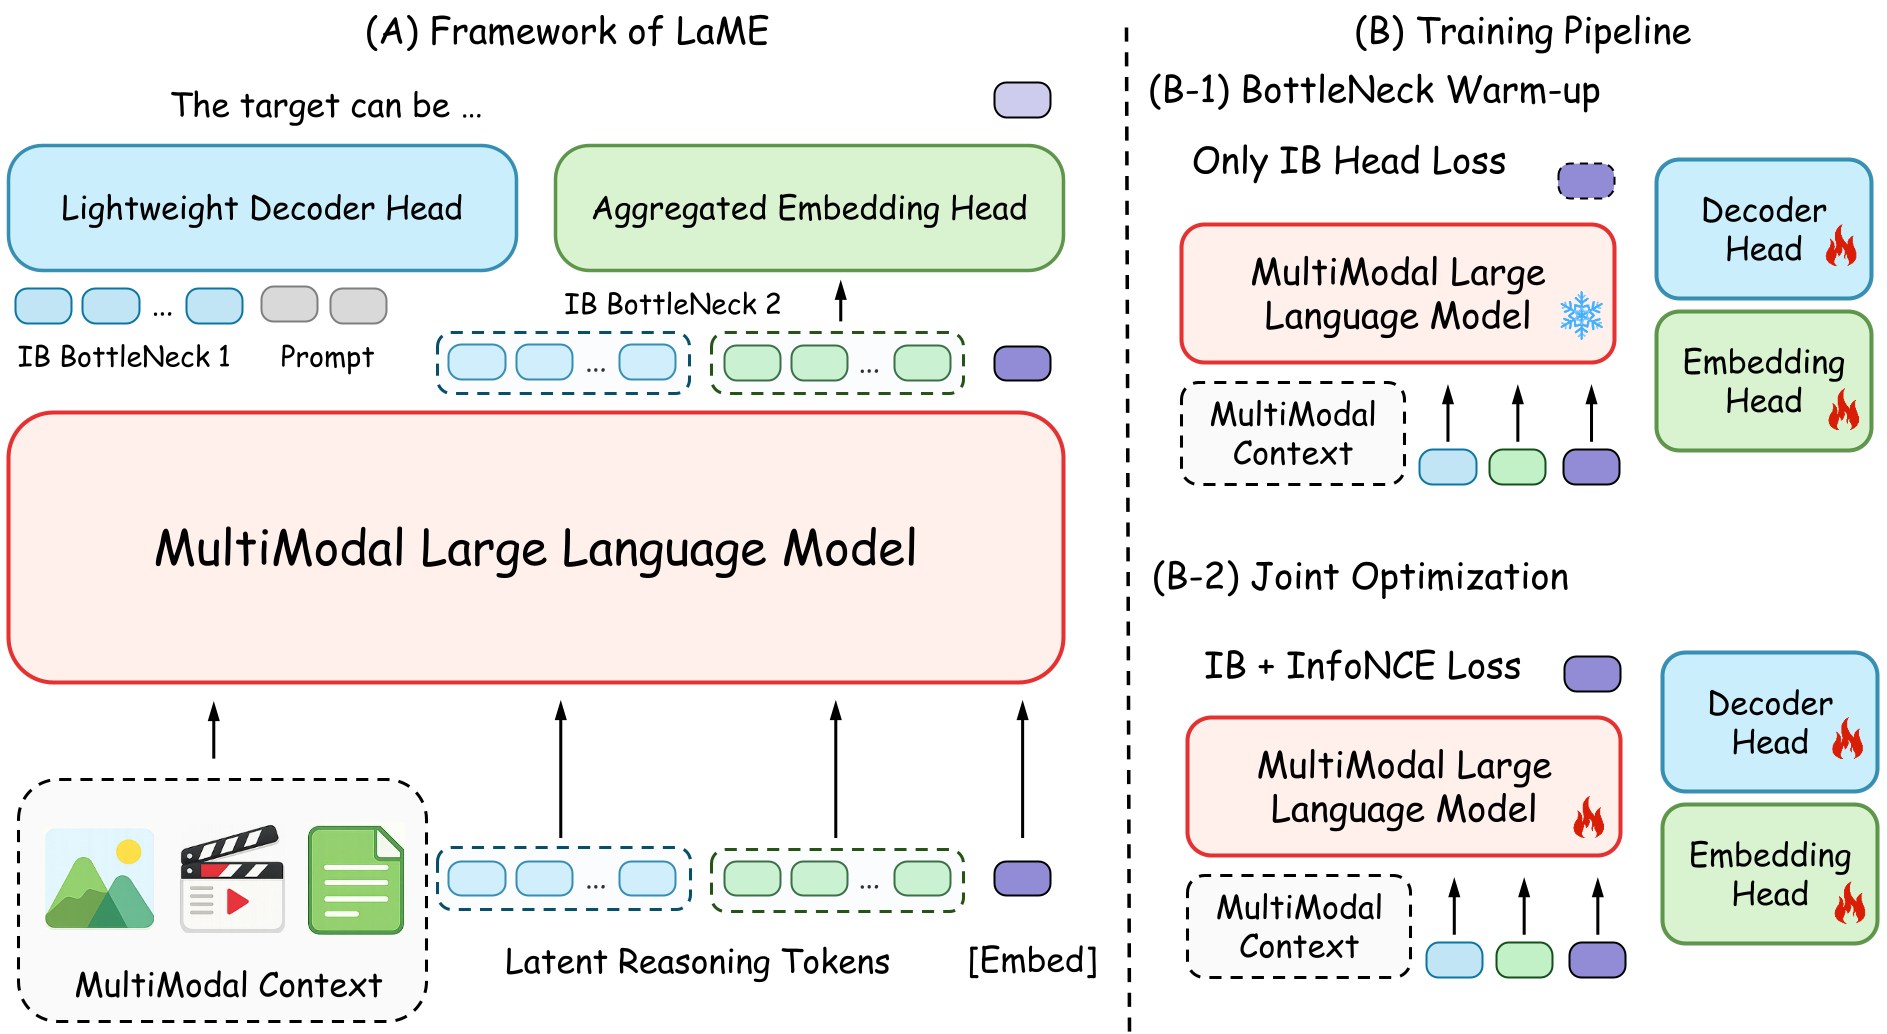
LaME 在输入序列中插入了 个专门的 Reason Tokens。这些 Token 会在注意力机制的作用下,像“海绵”一样吸取图像和文字中的关键特征,并进行内部整合。
2. 双头监督机制(Dual-Head Supervision)
为了让这 个 Reason Tokens 真正学会有价值的推理,LaME 引入了两个弱监督信号:
- 解码头 (Decoder Head):尝试从 Reason Tokens 的隐状态中还原答案关键词(如“pyramid”、“racing”),这强迫 Reason Tokens 必须包含解决问题所需的语义。
- 嵌入头 (Embedding Head):直接将 Reason Tokens 聚合为向量参与对比学习,确保推理过程始终面向检索目标。
实验与结果:鱼与熊掌兼得
LaME 在 MMEB-v2 基准上的表现令人惊艳。它不仅在 2B 和 7B 两个尺度上都达到了 SOTA 水平,更重要的是其吞吐量几乎与不带推理功能的纯检索模型持平。
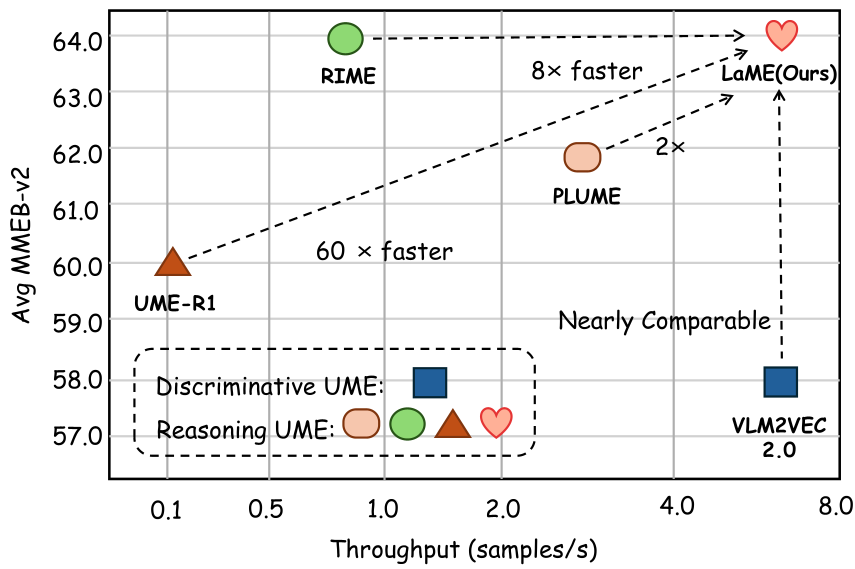
- 速度优势:比显式 CoT 方法快 60 倍,实现了单前向推理。
- 专家级任务:在 MRMR(推理密集型检索)测试中,LaME 在物理和数学子项上的表现证明了其隐空间推理能够处理极高复杂度的逻辑门槛。
深度洞察:为什么有效?
LaME 的成功在于它利用了信息瓶颈 (IB) 的硬约束。通过限制 Reason Tokens 的数量(实验证明 是甜点位),强制模型在有限的通道内压缩掉冗余的背景噪声,只保留对检索判断最关键的本质特征。这种“被迫的精简”反而催生了更具判别力的特征表示。
总结与未来展望
LaME 标志着多模态检索进入了“静默推理”时代。虽然它牺牲了一定的可解释性(我们无法直接读到它的思考轨迹),但它带来的效率提升是工业界梦寐以求的。
未来,该技术路线的一个重要方向是自适应瓶颈容量——对于简单查询,可能只需要 2 个 Reason Tokens;而对于复杂的科学文献检索,模型应当能动态申请更多的思维空间。