
通往 6G 的 AGI 之路:电信领域大语言模型深度全解析
Large Language Model (LLM) for Telecommunications: A Comprehensive Survey on Principles, Key Techniques, and Opportunities
本文是关于大语言模型(LLM)在电信领域应用的首份全面综述。文章系统化地梳理了 LLM 在生成、分类、优化和预测四大任务中的核心技术与电信应用场景,并探讨了如何通过预训练和微调(如 LoRA, LNT)将通用 LLM 转化为支撑 6G 时代通用人工智能(AGI)的行业大模型。
TL;DR
随着 5G 步入商用深水区及 6G 愿景的浮现,电信网络正面临前所未有的管理复杂度。这篇 arXiv 综述论文系统揭示了 LLM(大语言模型) 如何从单纯的“聊天机器人”蜕变为电信网络的“超级指挥官”,覆盖了从底层代码优化、协议自动解析到智能无线资源管理的各个维度。
1. 为什么电信领域需要大模型?(动机与痛点)
传统的电信网络管理依赖于专家的经验和特定的算法模型。然而,现代网络(尤其是未来的 6G)呈现出以下挑战:
- 知识鸿沟:3GPP 标准协议长达数万页,查阅与解析耗费巨大精力。
- 配置爆炸:手动配置数以千计的基站、网关、切片规则,极易出错。
- 决策黑盒:传统机器学习模型(如 RL)虽然效果好,但缺乏解释性且奖励函数设计异常困难。
作者指出,LLM 的 In-context Learning (ICL) 和 Reasoning (推理能力) 能够像人类专家一样理解电信逻辑,从而将电信运维从“人力密集型”转向“指令驱动型”。
2. 核心架构:电信大模型的“任督二脉”
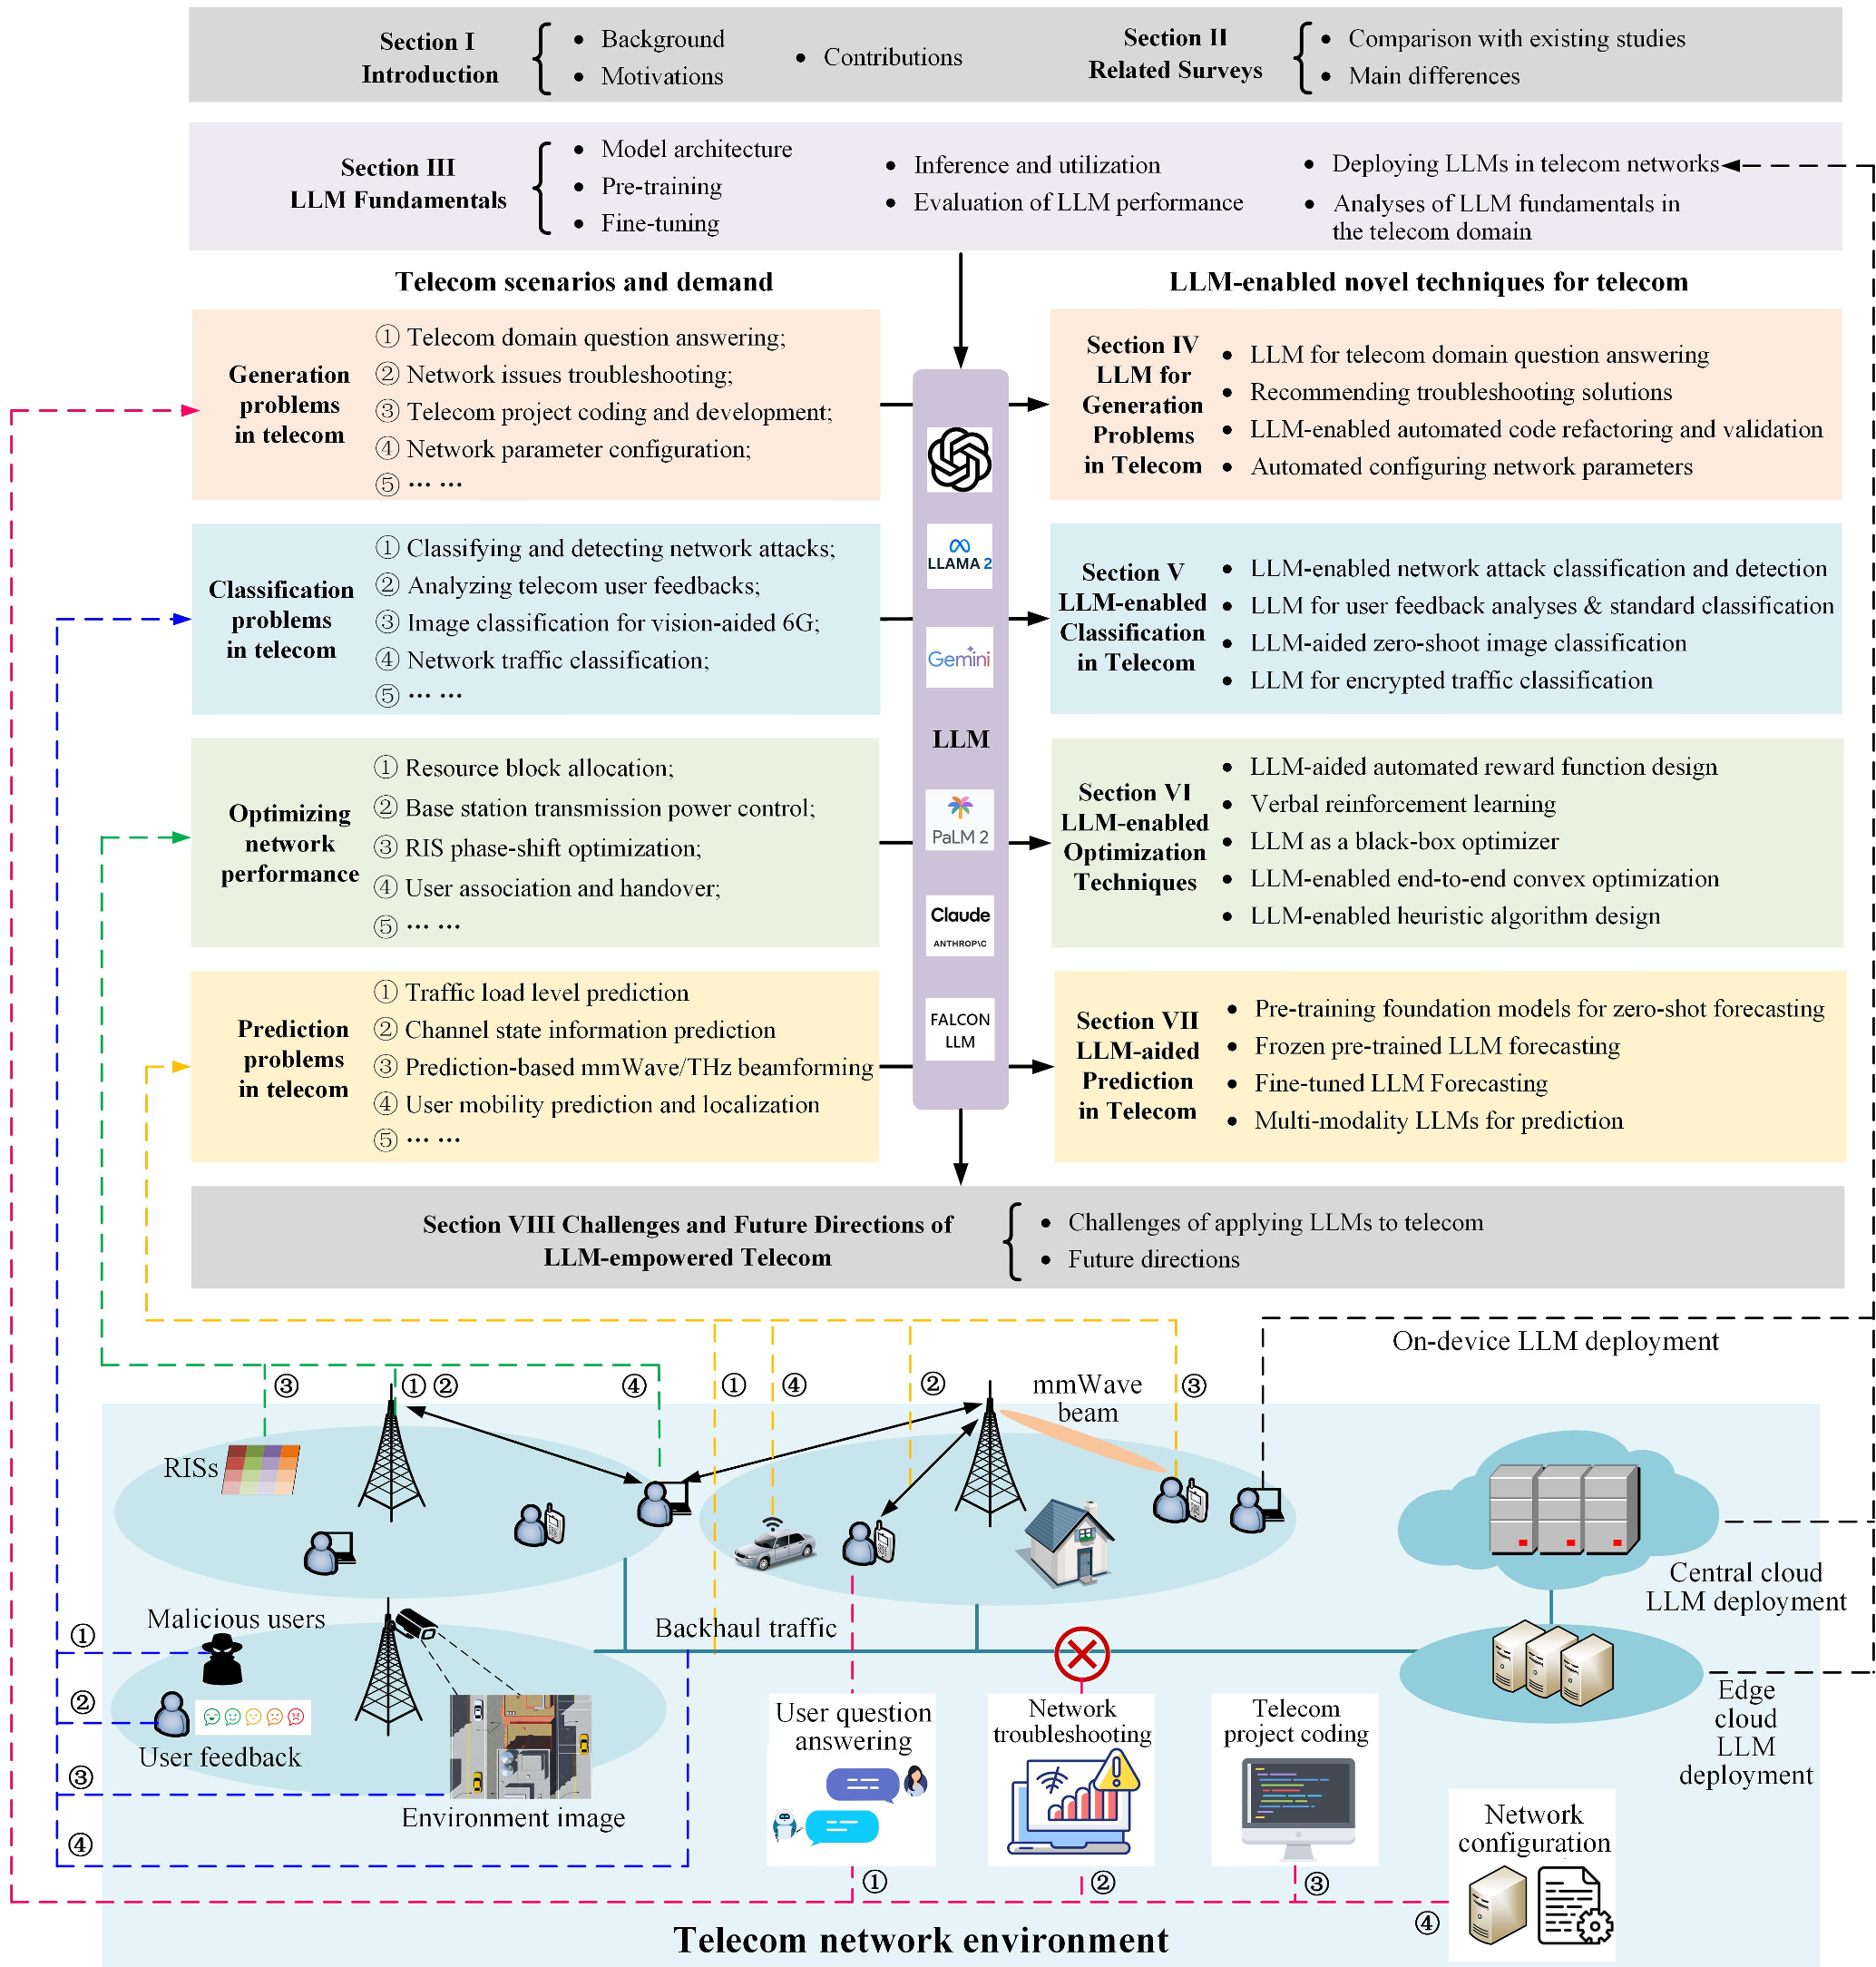
论文详述了电信大模型的三种主流部署与训练范式:
- 云端部署 (Cloud-based):利用超大规模模型(如 GPT-4)进行离线策略制定。
- 边缘部署 (Edge-based):通过量化和参数高效微调(LoRA),让 Llama-3 等模型在基站边缘运行。
- 端侧部署 (On-device):在移动端实现毫秒级响应的实时感知预测。
3. 四大核心应用场景详解
A. 生成任务:不仅是写文档,更是写硬件代码
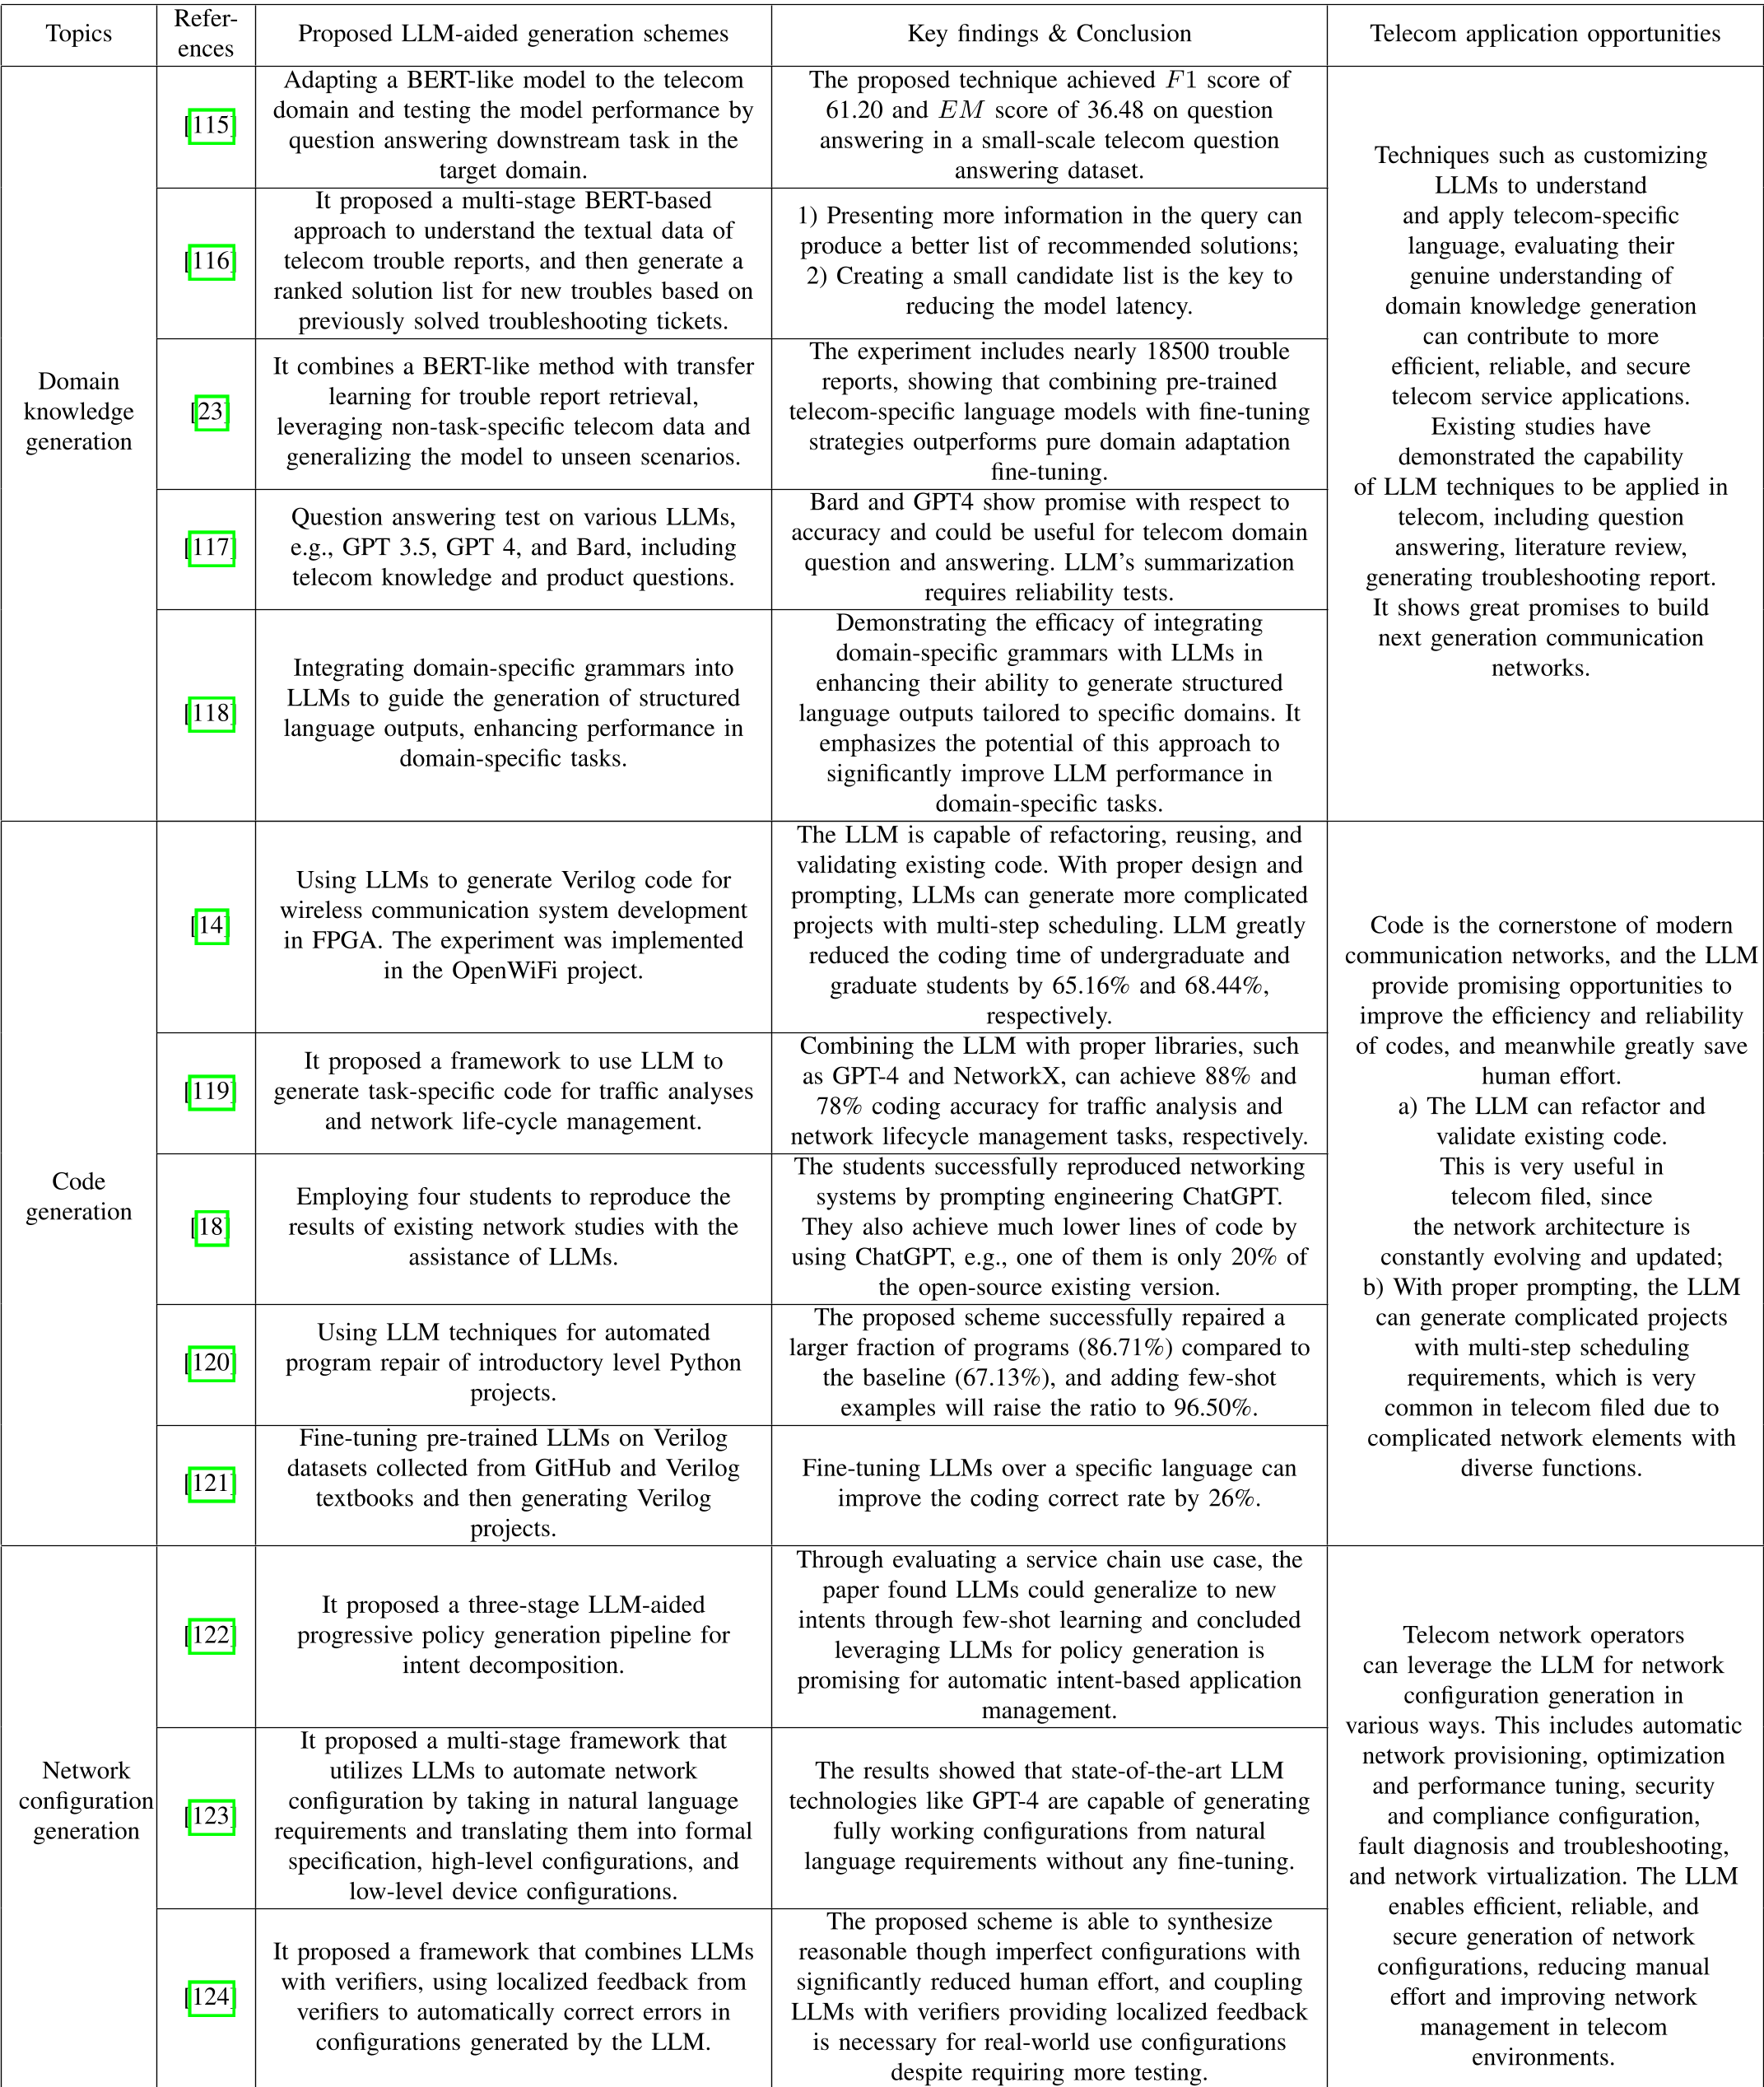
作者通过一个有趣的实验展示了 LLM 生成无线通信系统(FPGA)代码的能力。直接要求 LLM 生成 64 点 FFT 模块通常会失败,但通过 多步式思维链(Multi-step Prompting),先引导其生成 2 点 FFT,再逐步迭代至 16/32 点,最终高质量交付。
- 成果:在 OpenWiFi 开源项目中,LLM 帮助开发者减少了 60% 以上的编码工作。
B. 分类任务:电信安全的守门人
对于加密流量分析和 DDOS 攻击检测,传统的特征提取已捉襟见肘。
- SecureBERT:专门针对网络安全语料进行微调,能精准区分诸如“Reconnaissance(侦查)”和“DDoS”等细微语义差别。
- 视觉增强:通过基站摄像头拍摄的环境图像(Image-to-Text),模型能识别障碍物并预判信号遮挡(Blockage Prediction)。
C. 优化任务:告别痛苦的奖励函数设计
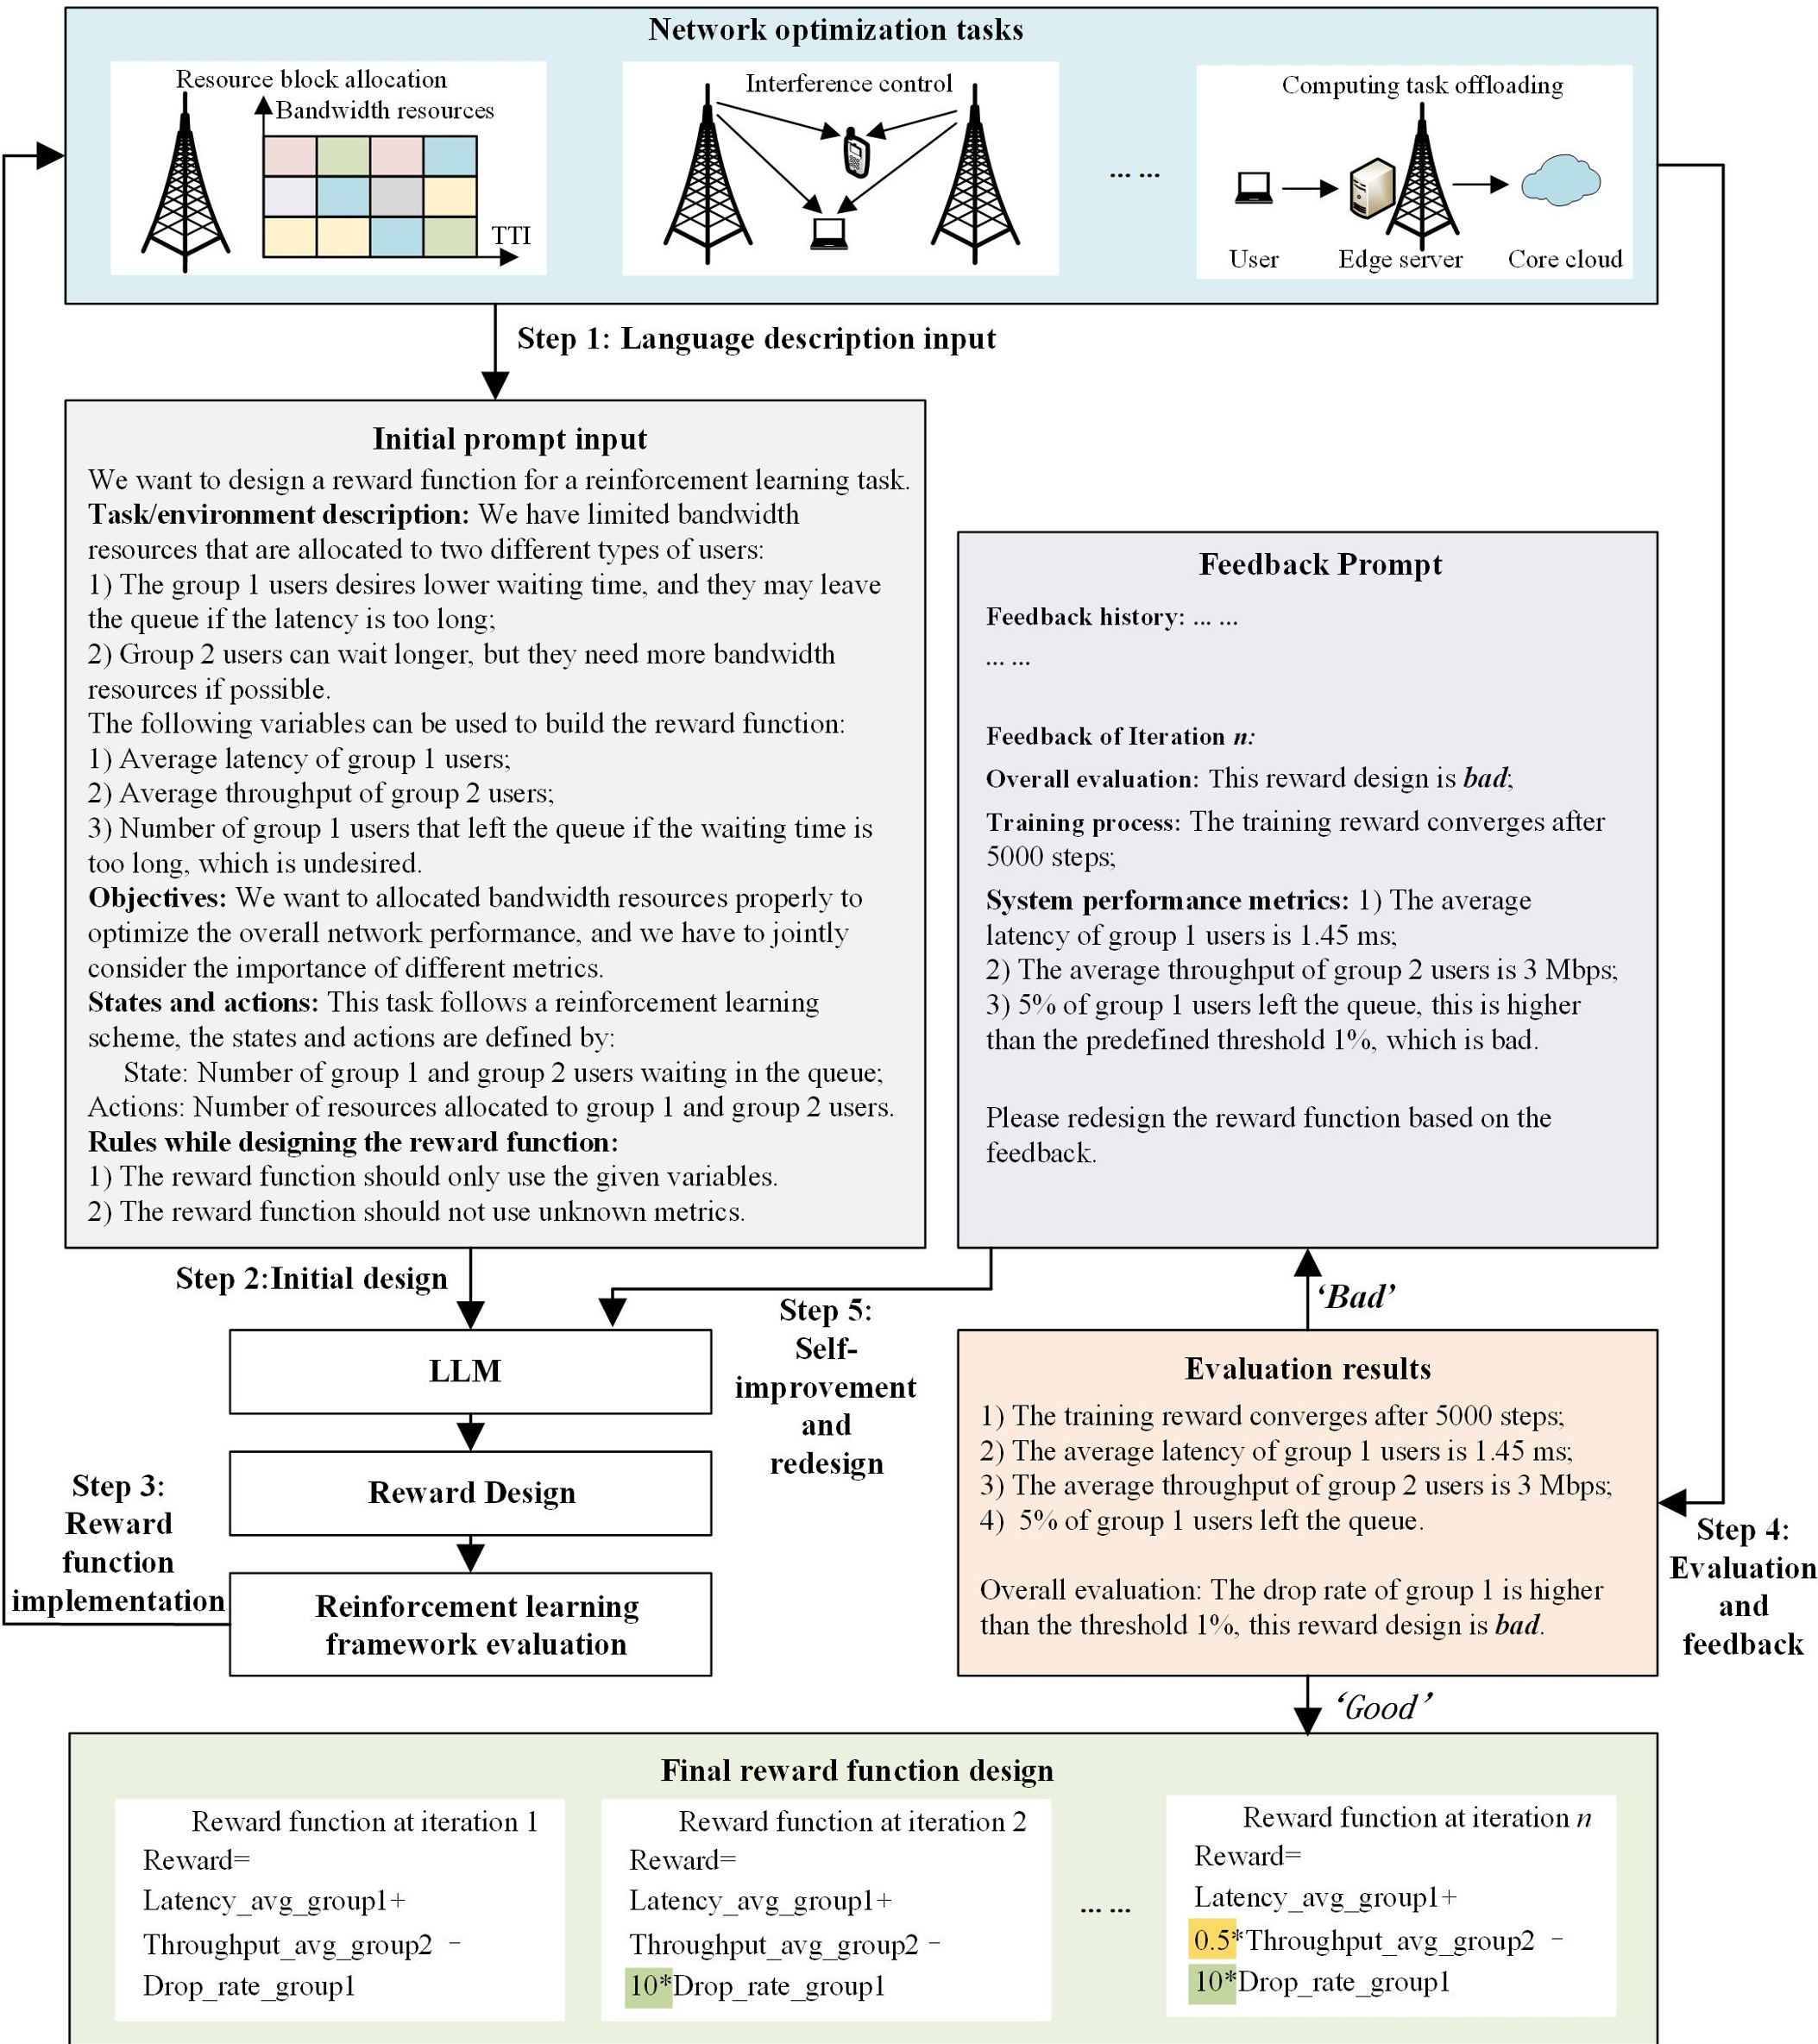
这是本文最具启发性的部分。在强化学习(RL)中,设计“奖励函数”往往需要数月尝试。作者提出了利用 LLM 自动编写奖励函数代码的框架。
- Eureka 模式:LLM 接收当前系统的性能反馈(如时延、丢包率),自动调整奖励权重,形成闭环进化。
D. 预测任务:时间序列的跨领域迁移
传统的流量预测模型需要为每个基站单独训练。论文介绍了 TIME-LLM 等前沿方法,将原本不可读的数值序列通过“线性拼凑(Patching)”重塑为 LLM 可理解的 Token 片段,从而实现了:
- Zero-shot 预测:模型在从未见过的数据集上也能精准预判后续流量峰值。
4. 实验战绩与 SOTA 对比
在各种 benchmark 测试中,电信专用模型表现远超通用基线:
- ET-BERT:在加密恶意软件分类中,准确率提升至 99% 以上。
- 解决复杂规划:通过分阶段 Prompt 设计,在 3GPP 协议分析任务中比普通 GPT-4 高出 20% 的准确度。
5. 挑战与思考:电信 LLM 不是万能药
尽管前景诱人,但作者也给出了清醒的警告:
- 幻觉问题:电信配置中一个参数错误就可能导致全网崩溃。如何引入外挂知识库(RAG)和自动化验证器(Verifier)是当务之急。
- 推理开销:LLM 的推理通常很慢,难以满足 0.1ms 的 6G 延迟要求,未来的突破口在于模型压缩和专用硬件加速。
- 数据荒:高质量、带标注的电信私域数据严重短缺。
总结
这篇综述不仅仅是一次文献整理,它为 6G 时代构建了一个“基于语言的控制平面”愿景。未来的电信工程师或许不再需要钻研复杂的数学优化公式,而是通过编写精准的 Prompt 来指挥千万级别的网络设备。
注:文中架构图及实验对比图取自原论文。