
映射科学巅峰:利用 LLM 与主题建模重塑文献综述新范式
Publication Trend Analysis and Synthesis via Large Language Model: A Case Study of Engineering in PNAS
本文提出了一种结合大型语言模型(LLM)与主题建模的混合框架,专门用于映射和解析复杂的科学文献结构。该方法通过两阶段流水线(摘要分类与全文细粒度分析),将 20 年间的 PNAS 工程类文章自动聚类为 16 个高可解释性的主题,在高维语义空间中揭示了学科间的交叉联系。
TL;DR
本文介绍了一种创新的 LLM 驱动的科学文献映射框架。通过将 OpenAI 的嵌入模型与 GPT-4o-mini 的语义推理能力相结合,研究者成功解析了 PNAS 20 年间的工程文献,不仅实现了自动化的主题发现,还通过全文二分图揭示了潜藏在文字背后的跨学科关联。
痛点深挖:为何传统方法在科学迷宫中迷路?
在知识爆炸的今天,科学文献不仅数量庞大,且充满专业黑话(Jargon)。传统的文献计量学工具(如 VOSViewer)或统计学模型(如 LDA)主要依赖关键词统计,这导致了三大致命局限:
- 语义缺失:无法理解同一个词在不同语境下的含义。
- 解释成本高:LDA 给出的“单词堆砌”主题往往需要领域专家进行二次解读。
- 学科壁垒:难以捕捉论文摘要之外、隐藏在全文细节中的交叉学科火花。
核心机制:两阶段迭代分类流水线
作者提出的框架并非盲目依赖 LLM,而是采取了“数据驱动聚类 + 高级语义重炼”的混合路线。
第一阶段:摘要主题提取 (Primary Classification)
- 高维聚类:利用
text-embedding-3-small模型将摘要转为向量,并初步进行 K-means 聚类。 - LLM 标注与精炼:GPT-4o-mini 为每个簇生成易于理解的标题(如“纳米颗粒技术”)和详细描述。
- 递归稳定性验证:这是本文的精髓。作者设定了“3-out-of-5”一致性原则,即 5 次运行中至少有 3 次分类一致才视为“稳定主题”。不稳定的文章会进入下一轮递归,直到被归入可靠的主题或“Other”类别。
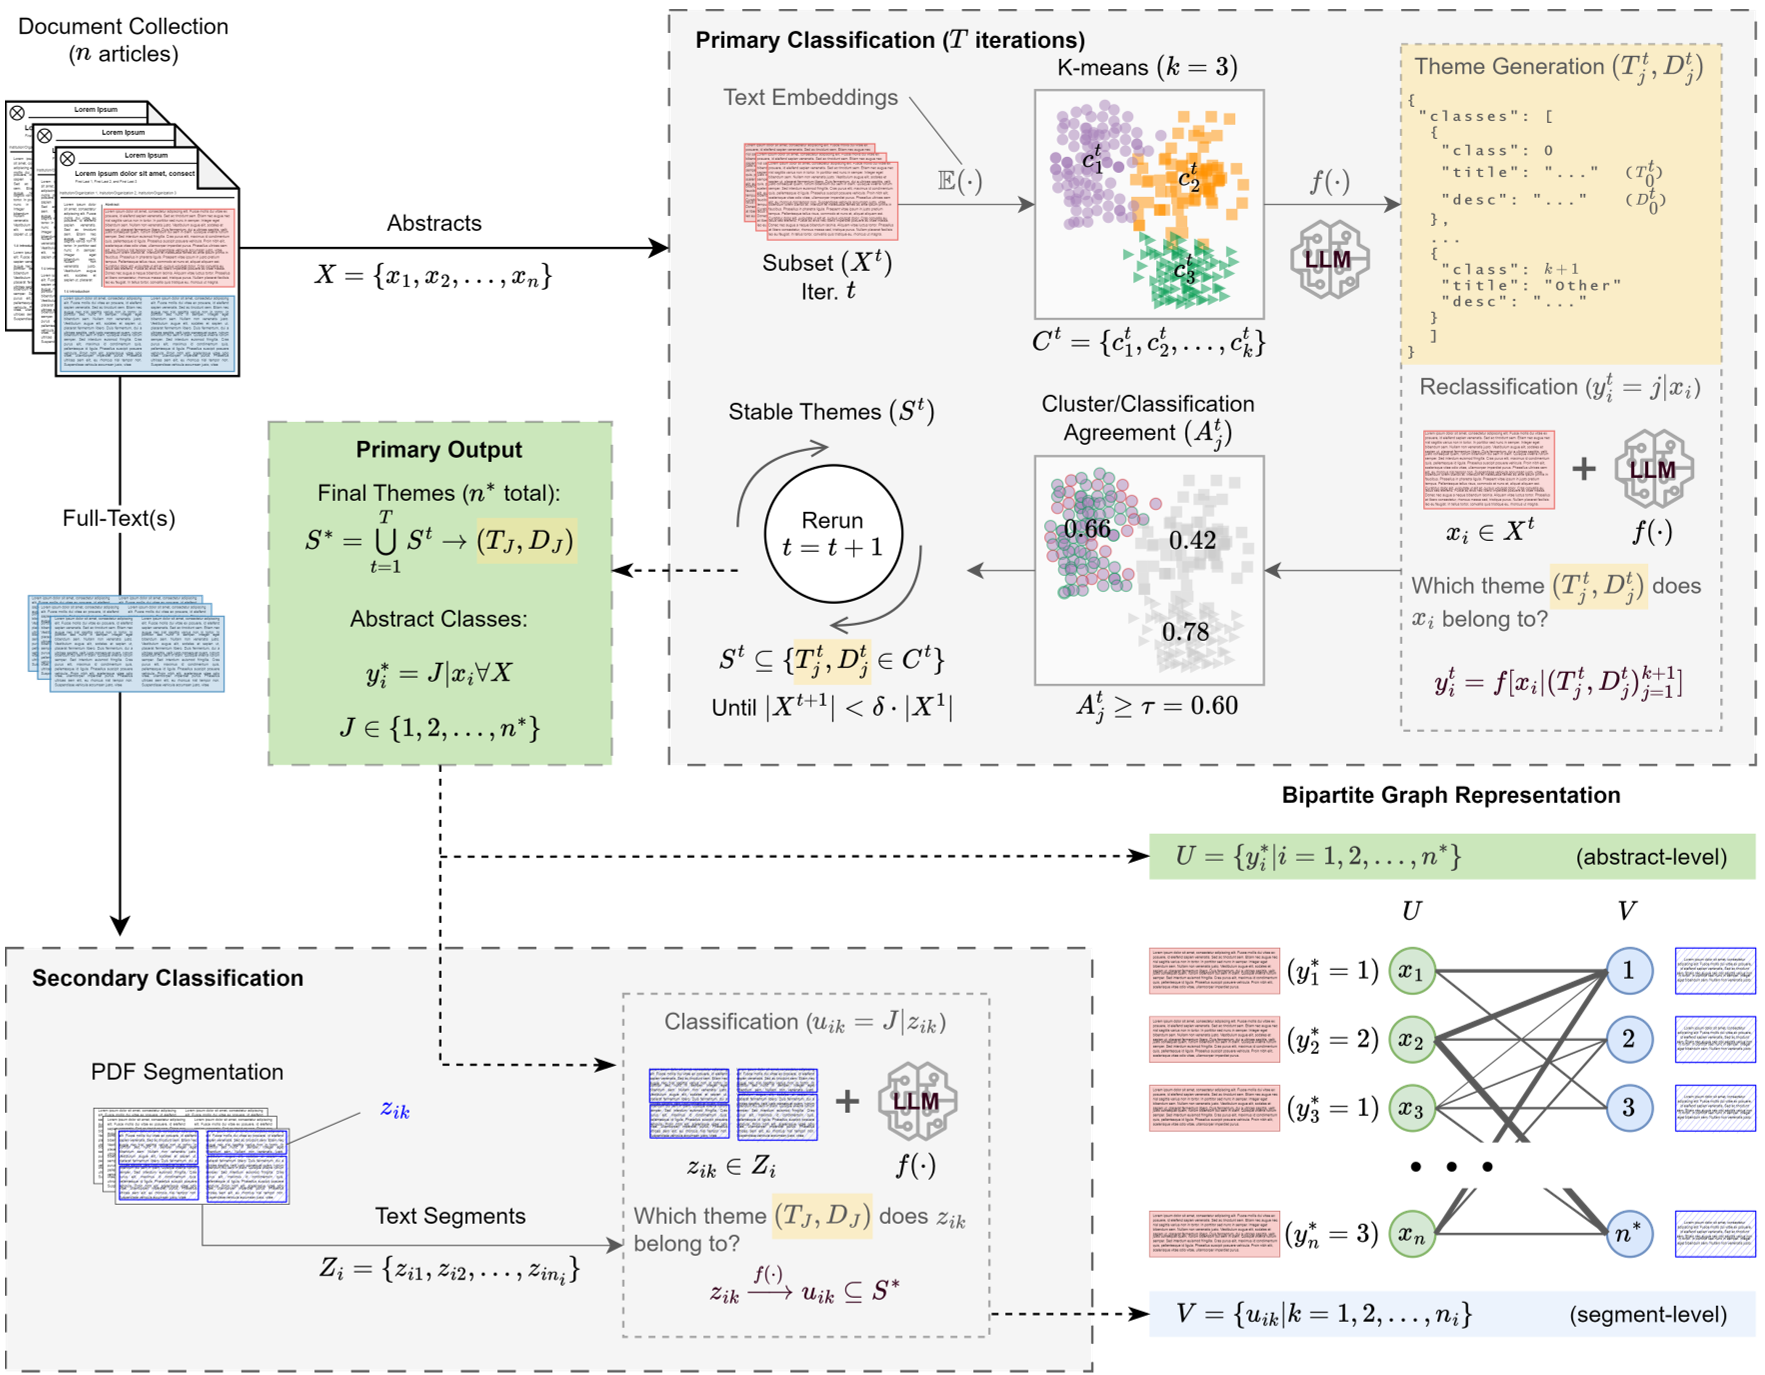
第二阶段:全文交叉映射 (Secondary Classification)
由于很多科研论文其实是“挂羊头卖狗肉”(摘要讲应用,全文讲技术),作者对 1.8 万个全文片段进行了多标签分类。通过构建一个二分图 (Bipartite Graph),模型精准捕捉到了知识如何从“材料科学”渗透进“组织工程”。
实验战果:超越统计模型的智能
在与 LDA、NMF 以及最新的 BERTopic 对比中,本文框架展现了统制级的表现:
- 主题多样性 (Topic Diversity):达到 0.909,显著高于传统模型。
- 解释性:告别了“单词云”,得到了人类可读的科研领域定义。
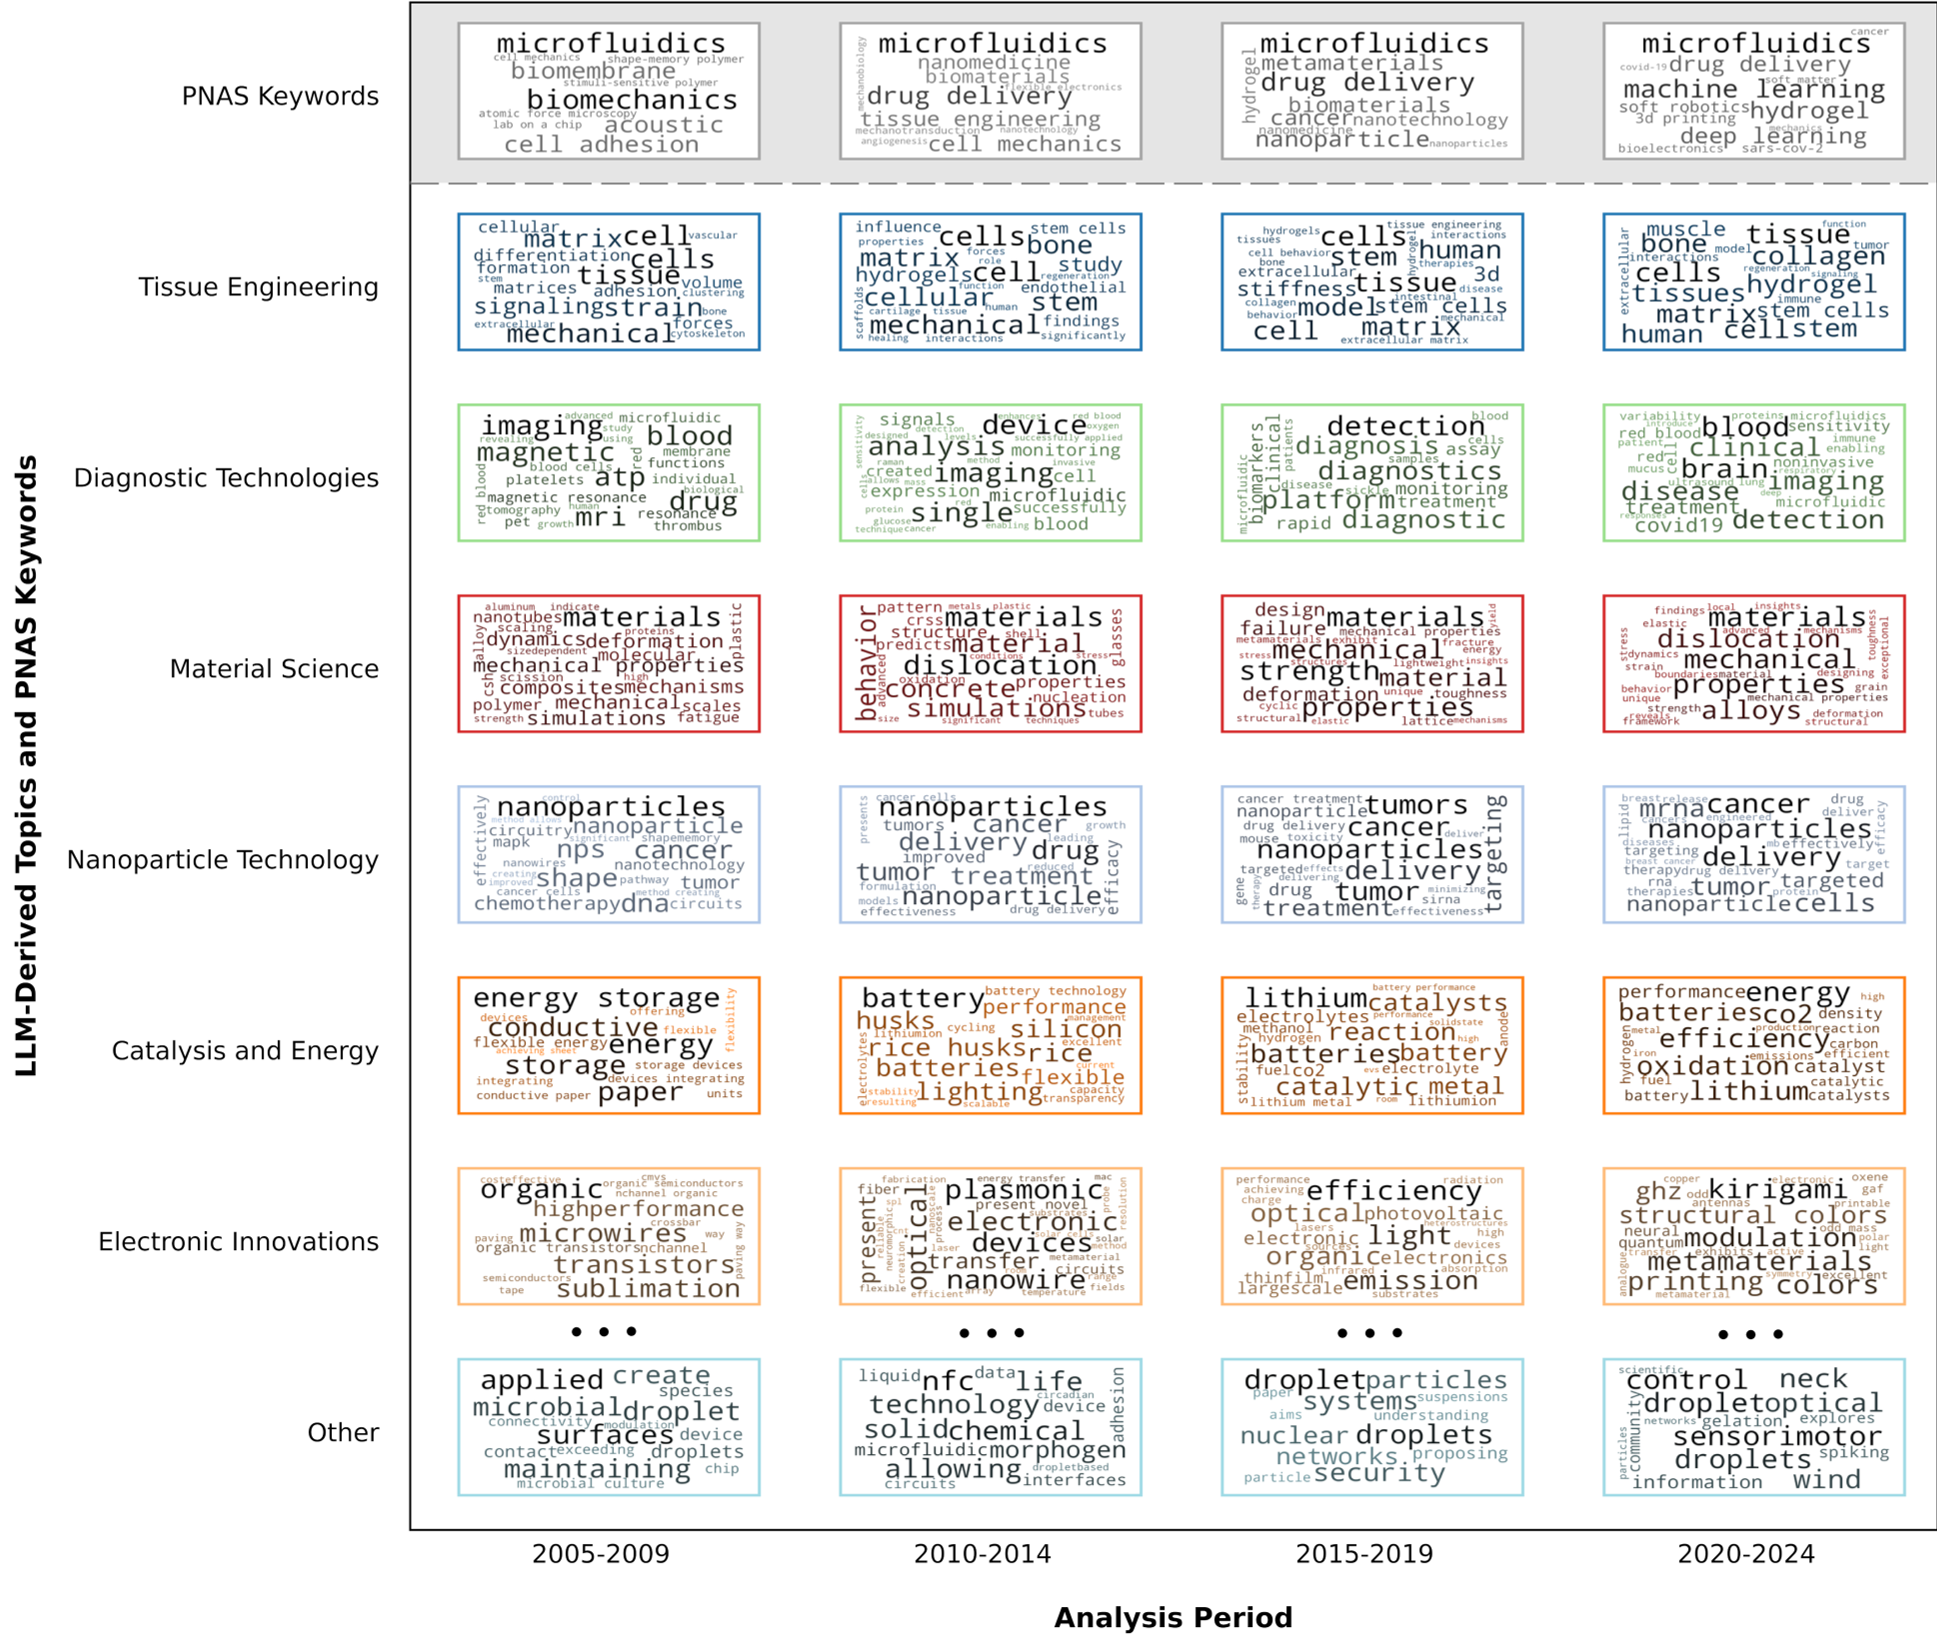
- 对齐真实世界:模型揭示的“高提升度(High Lift)”主题(如合成生物学)与 PNAS 官方的编辑分类高度吻合。
深度洞察:科学不仅仅是“词袋”
本研究最重要的发现之一是:工程学科在 PNAS 中并非边缘,而是作为底层支撑存在。例如,尽管很多论文被贴上“生物医学”的标签,但其全文分析显示,核心支撑技术往往来自“材料科学”或“流体力学”。这种“显性应用-隐性技术”的关联,只有通过本文这种全文级的语义分析才能被量化。
总结与局限
优势:该框架通过引入 τ (稳定性阈值) 和 δ (收敛阈值),解决了 LLM 带来的随机性和幻觉问题,为缺乏标注数据的科学领域提供了一种“自监督”的导航工具。
限制:尽管 GPT-4o-mini 的性能优秀,但对于更极端的长文本(Lost in the middle)以及极冷门的科技术语,仍需进一步优化解析能力。
未来,这种“AI 馆长”式的框架或许会成为每个研究者的标配,帮助我们从海量的论文海洋中,快速定位那条通往创新的细微路径。