
大模型真的知道自己在胡说吗?探秘幻觉背后的知识检索陷阱
Large Language Models Do NOT Really Know What They Don't Know
本文通过因果干预和机理分析研究发现,大语言模型(LLM)的内部状态主要反映的是“知识检索过程”而非内容的“真实性”。作者提出了一种新的幻觉分类法,将幻觉分为由错误关联驱动的“关联型幻觉 (AH)”和脱离输入的“非关联型幻觉 (UH)”,并证明现有探测方法在应对 AH 时几乎失效。
TL;DR
学术界一直有个美好的假设:大模型(LLM)的内部隐藏状态能告诉我们它是否在“撒谎”。然而,这篇论文打破了这一幻觉。研究表明,大模型的内部信号主要反映的是它是否正在努力回忆东西(Knowledge Recall),而不是它说的话是否正确(Truthfulness)。这意味着,当模型基于错误的“刻板印象”信誓旦旦地胡说八道时,它的内部状态看起来和说真话时完全一样。
背景:幻觉的“两种面孔”
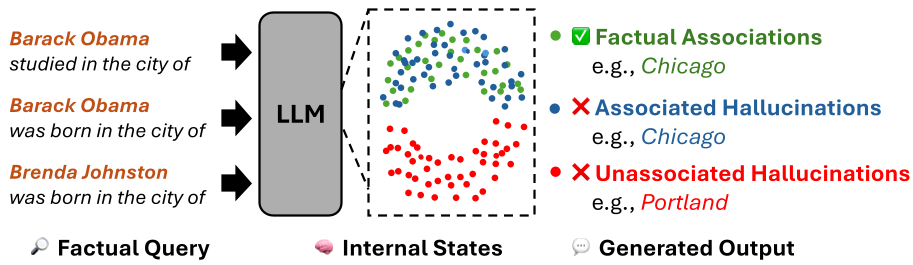
研究者发现,大模型的幻觉不能一概而论,他们将其划分为两类,这是理解本文的核心:
- 关联型幻觉 (Associated Hallucinations, AH):模型基于预训练中学到的强烈统计关联产生的错误。例如,因为奥巴马常与芝加哥关联,模型可能正确回答他曾在芝加哥求学,也可能错误(幻觉)回答他出生在芝加哥。
- 非关联型幻觉 (Unassociated Hallucinations, UH):模型在面对完全陌生的冷门实体时,随意生成的无根据内容。
技术深挖:为什么内部状态会失效?
根据经典的知识检索三阶段理论(Geva et al., 2023),模型生成事实需要经历:主体表征增强 -> 注意力流传递 -> 末尾解码。
作者通过因果干预发现了一个惊人的事实:AH 与事实关联(FA)在计算路径上几乎是镜像的。
1. 隐藏层几何结构的“视觉证据”
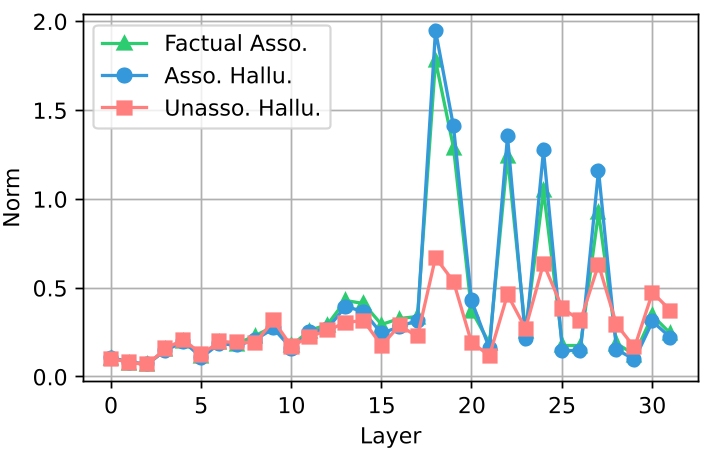
在早期的隐藏层中,AH 和正常事实的向量模长(Norm)几乎相同,意味着模型激活了同等强度的知识检索。而通过 t-SNE 可视化(如下图)可以发现,代表 UH 的蓝色点群形成了一个独立的簇,而代表 AH 的绿色点则像墨水一样完全消融在代表事实(FA)的红色点群中。
 上图清晰展示:AH(绿色)与 FA(红色)在表征空间中重叠严重,导致基于表征的探测器在分界面上迷失。
2. 注意力流的“执迷不悟”
作者计算了从主体(Subject)到最后一个 token 的注意力贡献。结果显示(图 5),生成 AH 时,模型内部的注意力流强度与生成事实时一样高。这说明模型在生成关联型幻觉时,是非常“认真”地从参数中提取那些错误的统计关联。
核心实验结果:探测器的全面溃败
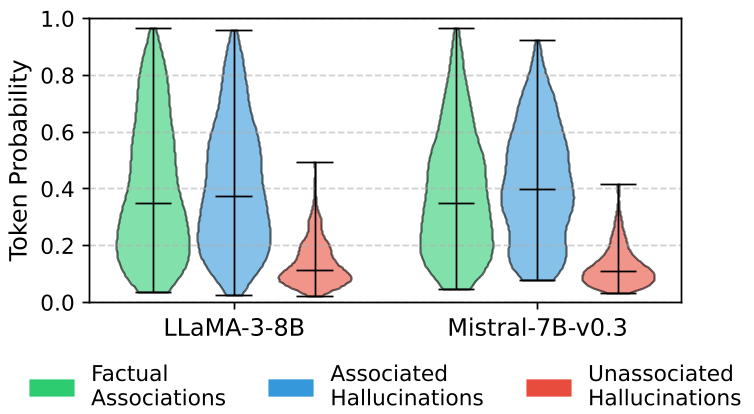
研究者测试了多种主流的幻觉探测方法,包括白盒的隐藏层探测(Linear Probing)和黑盒的置信度评估:
- 探测 UH:表现优异,AUROC 高达 0.93。
- 探测 AH:表现惨淡,AUROC 仅在 0.48-0.69 之间,接近随机猜测。
这解释了为什么很多所谓“能识别幻觉”的工具在现实场景(尤其是处理明星、地标等热门实体时)往往表现不佳。
拒绝微调的局限性
目前业界流行让模型学会在不确定时说“我不知道”(Refusal Tuning)。但论文指出,模型能学会拒绝 UH(因为它知道那是盲区),却很难学会拒绝 AH。由于 AH 的信号与事实信号太像,强行让模型拒绝 AH 往往会导致严重的“过度拒绝”,即模型连正确的事实也不敢回答了。
总结与启示
这篇论文向 LLM 自省能力的乐观派泼了一盆冷水:
- 流行度悖论:越是流行的主题,产生的 AH 越多,也越难被模型自身察觉。
- 告别单一指标:未来的研究不应再泛泛谈论“幻觉探测率”,而应区分 AH 和 UH 独立评估。
- 拥抱外部工具:既然内部状态无法自证清白,那么 RAG(检索增强生成)和外部事实核查(Truth Checkers)就不仅是插件,而是解决关联型幻觉的唯一救命稻草。
资深主编点评: 该研究通过精妙的因果干预设计,在“知识检索”和“真实性”之间划出了一道清晰的红线。它告诉我们,模型所谓的“自信”往往只是对统计关联的肌肉记忆,而非对真理的觉知。