
LLM 真的知道它在胡说吗?揭秘隐藏状态下的“虚假自信”
Large Language Models Do NOT Really Know What They Don't Know
本文通过对大语言模型(LLM)内部状态的机理分析,揭示了模型并不真正“知道自己不知道”。研究提出了一种新的幻觉分类法,并证明现有的幻觉检测方法主要识别的是“知识检索”过程而非“真实性”,在面对由虚假关联驱动的幻觉时基本失效。
TL;DR
长期以来,AI 社区一直抱有一个乐观的假设:LLM 如果不知道某个事实,它的内部状态会发出“警报”,我们可以通过提取这些信号来检测幻觉。然而,这篇由新加坡管理大学和阿里巴巴达摩院等机构发表的论文给这个假设泼了一盆冷水。研究发现:LLM 的内部状态主要反映的是“我是否正在回忆某个知识点”,而不是“我说的对不对”。
背景定位
本文是幻觉检测领域的一篇“清醒剂”。它挑战了诸如 Inference-time Intervention 等依赖内部表示(Internal Representation)进行真伪辨别的 SOTA 方法,从机理分析(Mechanistic Interpretability)的角度重新定义了幻觉的边界。
核心痛点:被忽视的“关联幻觉” (AHs)
作者指出,目前的幻觉检测方法之所以在榜单上表现亮眼,是因为测试集里充斥着大量的非关联幻觉 (UHs)。比如,当模型被问到一个冷门人物时,它可能完全没有相关存储,直接乱猜,这种“心虚”在隐藏层里非常明显。
但最危险的是关联幻觉 (AHs)——模型因为在训练集中见过大量“奥巴马”和“芝加哥”的共现,可能会顺口说出“奥巴马出生在芝加哥”。对于模型来说,这种“顺口而出”的过程与说出真话(事实关联 FAs)在计算流程上是完全等同的。
深度解析:知识检索的几何足迹
作者通过对比分析,揭示了三者在模型内部的“众生相”:
-
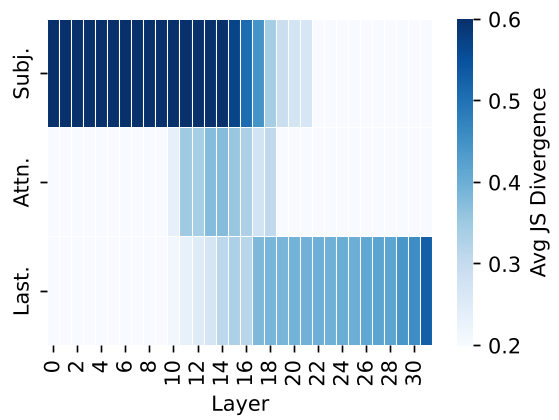
信息流 (Information Flow): AHs 与 FAs 的因果路径高度重合。不论是主体表征的强化,还是从主体到预测位置的 Attention 传播,两者在热力图上几乎不可区分。
-
表征几何 (Geometry): 在隐藏空间的 t-SNE 可视化中,UHs 往往缩在角落形成独立的簇,而 AHs 则像墨水一样完全溶解在 FAs 的分布中。这意味着,线性分类器(线性探针)根本无法在 AHs 和 FAs 之间划出那道识别真伪的红线。
实验战绩:检测方法的“大翻车”
实验数据直接揭示了这种危害:
- 白盒方法(如探测残差流):检测 UHs 几乎满分,但检测 AHs 的 AUROC 掉到了 0.58。
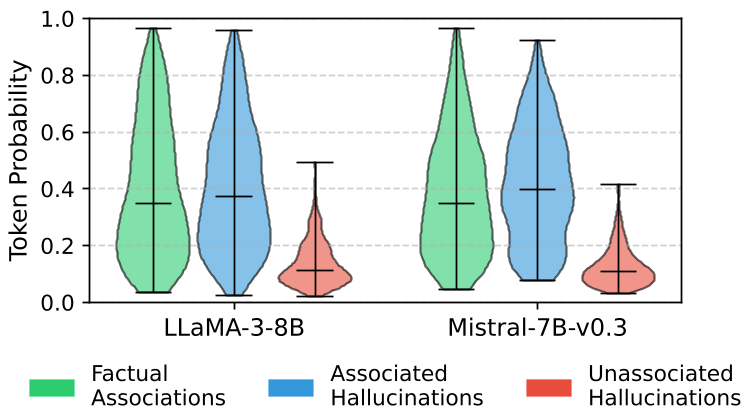
- 黑盒方法(如计算 Token 置信度):在遇到 AHs 时,由于模型对这些虚假关联极度自信,置信度指标彻底失效,表现接近随机分类。

洞察与启示:拒绝调优的局限
文章还测试了最近流行的 Refusal Tuning(教模型说“我不知道”)。结果令人沮丧:模型可以学会拒绝它从未见过的冷门实体(UHs),但对于 AHs,无论你怎么调优,它还是会自信满满地产生幻觉,因为它在表征层面上就没能把“错误的关联记忆”和“真实的事实记忆”区分开。
总结 (Takeaway)
这项工作实际上定义了 LLM 幻觉检测的“天花板”:只要模型是在“回忆”,它就分不清真假。
局限性与展望: 该研究目前集中在事实补全(Factual Completion)任务上,尚未扩展到长文本生成。但这已经为我们指明了方向:不要指望通过“模型自检”来解决所有幻觉问题,引入外部检索增强(RAG)和硬性的逻辑验证才是通往可靠 AI 的必经之路。