
大模型里的“六度分隔”:从隐状态流形拓扑相变到免训练 RAG 幻觉检测
Do Large Language Models Play Six Degrees of Separation? Measuring Topological Compression in Long-Context Manifolds
本文提出了一种绕过注意力权重缺陷、直接解析大语言模型(LLM)深层隐藏状态流形拓扑结构的分析框架。研究发现模型深层表征会自发经历拓扑相变并组织为“小世界网络”(Small-World Networks),严格遵循“六度分隔”定律(平均语义跳数 ≤ 5),并在 RAG 幻觉检测任务中取得 0.89 AUROC 的 SOTA 零样本判别表现。
1. 核心速览 (Executive Summary)
TL;DR:面对动辄数万甚至百万 Token 的长上下文,大语言模型(LLM)是如何跨越漫长的物理序列距离,在毫不相关的概念之间建立多跳逻辑跳跃的?来自 BRAC University 的研究者发表论文《Do Large Language Models Play Six Degrees of Separation? Measuring Topological Compression in Long-Context Manifolds》,绕过了存在严重伪影的 Attention 权重,直接对 Transformer 隐藏状态流形(Hidden State Manifold)进行拓扑图论建模。研究证实:LLM 深层表征空间会在特定余弦相似度阈值()下发生剧烈的拓扑相变(Topological Phase Transition),自发坍缩为高度可通达的小世界网络(Small-World Networks),将超长物理距离的概念跃迁严格压缩在 6 个语义跳数(Semantic Hops) 之内;而当模型发生事实性幻觉时,该拓扑结构会发生剧烈断裂。
学术定位:本工作跳出了传统基于 Attention Map 提取推理图谱的局限,从表征几何与复杂网络拓扑的全新视角,首次在数学上形式化了 Transformer 内部多跳抽象推理的“小世界”本质,并由此开辟了一种完全无需外部模型参与、零样本(Zero-shot)的几何级幻觉检测新范式。
2. 痛点与动机 (Problem & Motivation)
注意力谬误:被 Attention Sinks 掩盖的真实流形
在过去的机制可解释性(Mechanistic Interpretability)研究中,研究人员习惯于将 Attention 权重矩阵视为有向图来追踪信息流动。然而,近年来的多项研究指出了一个致命漏洞——注意力分配机制并不等于语义拓扑地图。
Transformer 深层推理头普遍存在“注意力坍缩”现象,即大量注意力权重被倾倒至 <bos>、标点符号或换行符等**注意力汇聚点(Attention Sinks)**上。这些标记具备极高的结构权重,却毫无语义价值。若直接基于注意力权重构建图结构,会导致语义路径被人为割裂,根本无法解释长程抽象推理的真实流动。
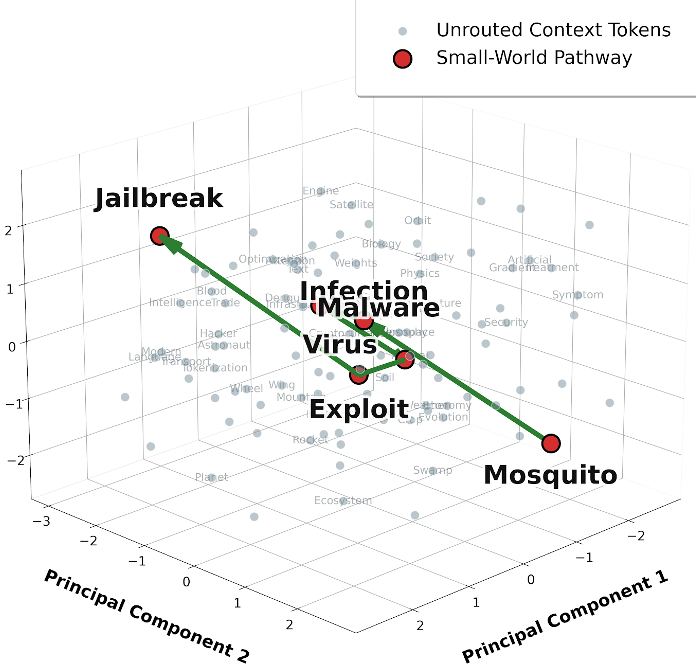 图 1:深层隐流形的 3D PCA 投影。高亮的小世界路径通过多义中间概念(如 "Virus"),仅用 5 个语义跳数便将生态学概念 "Mosquito" 与网络安全概念 "Jailbreak" 在密集的上下文 Token 云(灰色)中连通。
核心研究假设
作者提出假设:如果模型按线性链条处理上下文,跨越数千 Token 的推理将产生极其脆弱且冗长的计算路径;相反,Transformer 浅层负责局部语法解析,而深层推理层会主动将高维隐空间扭曲为具备高聚类系数、短特征路径长度的“小世界网络”。
3. 方法论详解 (Methodology - The Core)
为了严格剥离文本局部邻近性(Token Proximity)对语义连通的统计偏差,作者设计了严密的几何评估流水线。
输入长文本序列 S (150 ≤ N ≤ 300)
   │
   ├──▶ 外部 Embedding 裁判 (all-MiniLM-L6-v2) ──▶ 筛选极端语义锚点对 (vs, vt) [物理跨度 δ ≥ 20]
   │
   └──▶ 提取 Transformer 隐藏状态 H^(l) ∈ R^(N × d_model)
          │
          ├──▶ 计算成对余弦相似度矩阵 S_(i,j)
          │
          └──▶ 应用阈值 τ 离散稀疏化 ──▶ 隐状态近邻图 G^(l) = (V, E)
                 │
                 └──▶ 广度优先搜索 (BFS) ──▶ 测定最短语义跳数 L(vs, vt) 与连通率 C_rate
1. 语义锚点(Semantic Anchors)构建
对于长度为 的序列 ,引入独立的任务无关密集向量模型(all-MiniLM-L6-v2)将有效 Token 映射为 。在满足物理距离约束 (实验设定 ,平均跨度达 246 tokens)的前提下,寻找语义余弦相似度最小的词对:
这确保了图遍历任务必须跨越上下文中最极端的物理距离与语义鸿沟。
2. 隐状态近邻图构建与稀疏化
提取模型第 层的隐藏状态 。通过设定严格的截断阈值 ,将连续相似度空间离散稀疏化为无权无向图 ,其邻接矩阵定义为:
3. 拓扑相变扫描
利用广度优先搜索(BFS)计算锚点间最短测地线距离 。若图发生断裂无法连通,则记为 。定义连通率 为数据集内形成有效连通路径()的样本比例,并在区间 内以 步长进行扫描。
4. 实验与结果 (Experiments & Results)
实验选取了两种截然不同训练范式的模型:基于海量异构网页数据训练的 Qwen2.5-1.5B,以及高度依赖合成高质量教科书数据的 Phi-3-Mini-4k-Instruct。
1. 语法与语义的拓扑分水岭
实验呈现出极端的对立表征:在所有测试阈值下,浅层语法层(Layer 2)的连通率几乎恒为 。这确立了坚实的基准控制:局部的语法连贯性绝不自发具备小世界几何,长程拓扑压缩完全是深层抽象推理机制的专有产物。
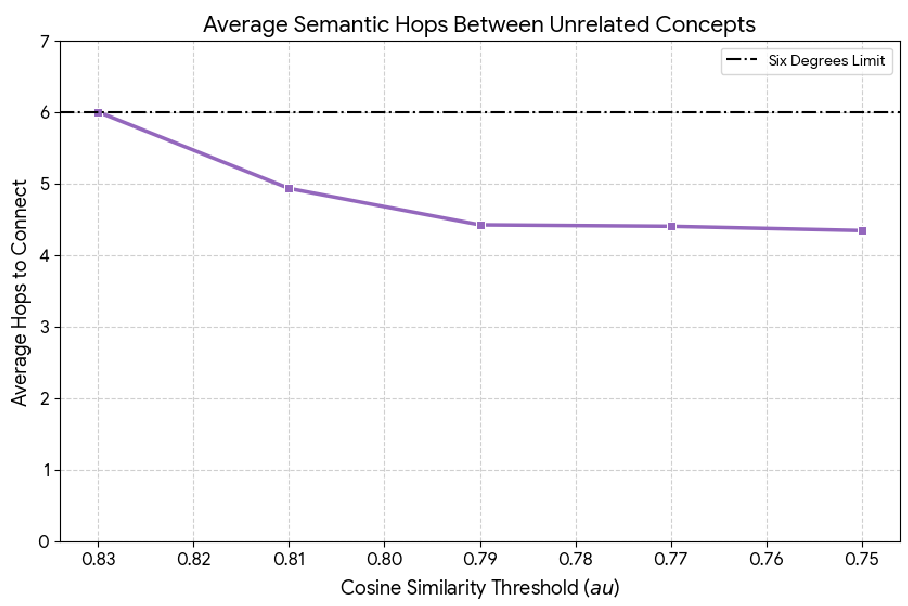 图 2:Qwen2.5-1.5B 拓扑相变边界。早期语法层完全无法连通语义锚点,而在 τ = 0.81 时深层推理层骤然涌现出小世界拓扑。
2. 剧烈的拓扑“硬相变”与六度分隔验证
如表 1 所示,当阈值下移穿过临界点 时,深层隐空间发生剧烈的拓扑相变:
- Qwen2.5-1.5B (Layer 24):在 时连通率为 ,至 突增至 ,平均跳数仅为 4.93;到 时,连通率达 ,平均跳数收敛至 4.34。
- Phi-3-Mini (Layer 30):相变更为敏锐,在 时已实现 的连通率,平均跳数仅为 3.60。
无论模型架构和数据源为何,一旦网络连通,平均路径长度始终严格收敛在 ,数学化地坐实了大模型隐空间内的“六度分隔”规律。
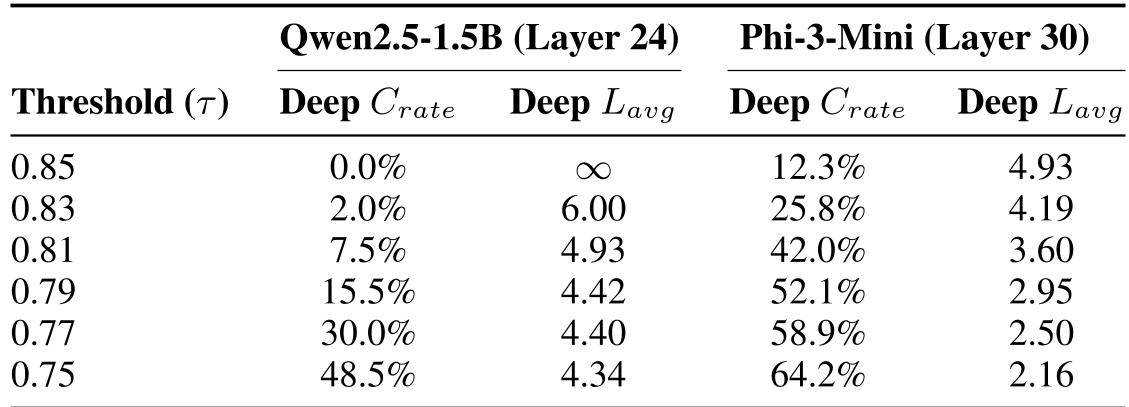 表 1:跨度 ≥ 200 Token 的语义锚点相变扫描。深层空间展现出惊人的路径压缩效率,而浅层完全断裂。
3. 层级演化与距离鲁棒性消融
- 层级非线性突变:在 Qwen 上追踪全部中间层()发现,Layer 1~12 连通率基本为 0;相变在 Layer 16 骤然发生(),并在 Layer 24 巩固至 (平均跳数 3.42)。
- 物理跨度无关性:将锚点物理间隔 从 10 逐步拉大到 250 Tokens,深层平均跳数稳定在 之间,证明模型并非依据 Token 局部距离做线性平滑,而是在高维流形上构建了跨越物理维度的“语义虫洞”。
5. 前沿落地:基于拓扑坍缩的 RAG 幻觉检测
为了检验这一拓扑框架的工程价值,作者将其应用于 RAG 场景的事实性幻觉检测,并在基准数据集 RAGognize 上展开测试。
机制设计
在检索生成的上下文-响应对中,将检索文档核心实体设为源节点集合 ,模型生成实体设为目标节点集合 。在 下构建隐图,提取连通率 与带惩罚项的平均路径长度 ,训练轻量级线性 SVM。
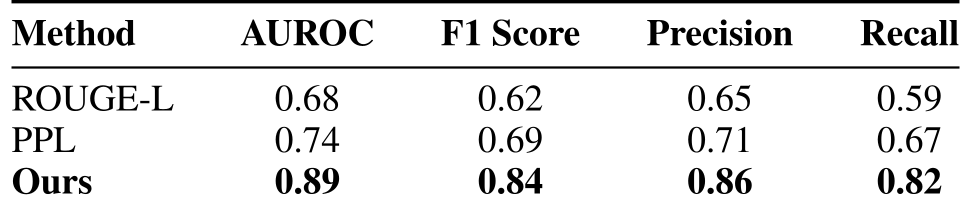 表 5:Qwen2.5-1.5B 在 RAGognize 上的幻觉检测指标。拓扑指标在 AUROC 上大幅领先传统基线。
实验结论剖析
- 真实生成(Factual):深层隐空间维持紧密连通,, 步。
- 幻觉生成(Hallucinated):发生严重的拓扑坍缩(Topological Collapse), 暴跌至 以下,即使连通其平均跳数也 。
- 检测效能:基于小世界拓扑特征的分类器取得 0.89 AUROC 和 0.84 F1-score。传统字符串匹配(ROUGE-L: 0.68)易被原文字面干扰欺骗,而 Token 困惑度(PPL: 0.74)因现代模型常常“极度自信地胡说八道”而失效。几何拓扑成为评估事实可靠性的本质内生签名。
6. 深度洞察与总结 (Critical Analysis & Conclusion)
总结 (Takeaways)
本文通过严格的几何图论手段,确立了以下关键认知:
- 推理的本质是拓扑压缩:Transformer 并非沿着 Token 序列进行线性逻辑接力,而是通过深层前馈与自注意力交互,将高维表征流形卷曲为高度可导航的小世界网络。
- 事实性的几何签名:生成的真实性在数学上等价于“生成表征能否与参考上下文在隐空间流形内建立 步的紧密测地线桥梁”。
局限性 (Limitations)
- 计算复杂度:精准构建 个 Token 的成对隐状态相似度图复杂度为 ,在处理数百万超长上下文或工业级吞吐时存在算力开销。
- 黑盒 API 不可用:方法高度依赖内部隐状态向量 的提取,无法直接应用于隐藏 Logits/Hidden States 的商业封闭模型(如 GPT-4o)。
- 相变阈值标定:临界阈值 具有经验性,在切换不同维度、不同归一化方式(如 LayerNorm vs. RMSNorm)的新架构时,需先进行轻量级的校准扫描。
未来展望 (Future Work)
拓扑视角为 AI 安全与可解释性提供了全新工具箱。未来,这一框架有望拓展至越狱攻击(Jailbreak)防御——攻击提示词往往通过在无害概念与恶意指令间强行构建异常的“语义虫洞”,可通过流形反常度实现毫秒级拦截;同时,它也为评估多模态大模型中跨模态对齐程度提供了免训练的几何度量基准。