
[Nature Communications] 宋慈(SongCi):首个致敬法医学鼻祖的大规模法医病理多模态诊断模型
Large-vocabulary forensic pathological analyses via prototypical cross-modal contrastive learning
本文推出了 SongCi,这是首个专为法医病理学设计的视觉-语言模型(VLM)。该模型基于超过 1600 万个高分辨率图像块和 2,228 对视觉-语言数据进行预训练,通过原型跨模态对比学习(Prototypical Cross-modal Contrastive Learning)实现了大词汇量的法医学自动化分析与诊断。
TL;DR
法医病理鉴定长期以来依赖专家的主观经验,且死后样本的复杂性让传统 AI 望而却步。西安交通大学等机构的研究团队推出了 SongCi,这是全球首个专注于法医病理的视觉-语言大模型(VLM)。它通过创新的原型对比学习技术,能够直接处理数十亿像素的 WSI 图片,并在诊断准确性上媲美执业 15 年以上的资深法医,同时将分析效率提升了近 20 倍。
背景:法医学的“大词汇量”挑战与宋慈的灵感
与癌症病理诊断不同,法医学面临的是“全器官、全病种、全死因”的极大不确定性。法医不仅要看肿瘤,还要辨别自溶(Autolysis)、创伤、炎症以及环境因素带来的细微改变。
该模型被命名为 SongCi(宋慈),以此致敬南宋著名法医学家、《洗冤集录》的作者。SongCi 模型旨在整合法医工作流程中的两大核心数据:大体解剖发现(Gross Key Findings)和显微镜检(WSIs)。
核心方法:微观与宏观的跨模态共鸣
1. 原型 WSI 编码器 (Prototypical WSI Encoder)
法医全幻灯片图像(WSI)通常包含数十亿像素。SongCi 并没有盲目处理每一个 Patch,而是通过自监督对比学习学习了一组**“原型(Prototypes)”**。
- 物理直觉:不同的器官(如心、肺、肝)在死后可能会表现出相似的病理改变(如出血、自溶)。模型学习到的 933 个原型可以自动聚类,识别出哪些是“组织特异性”特征,哪些是“跨组织通用”特征。
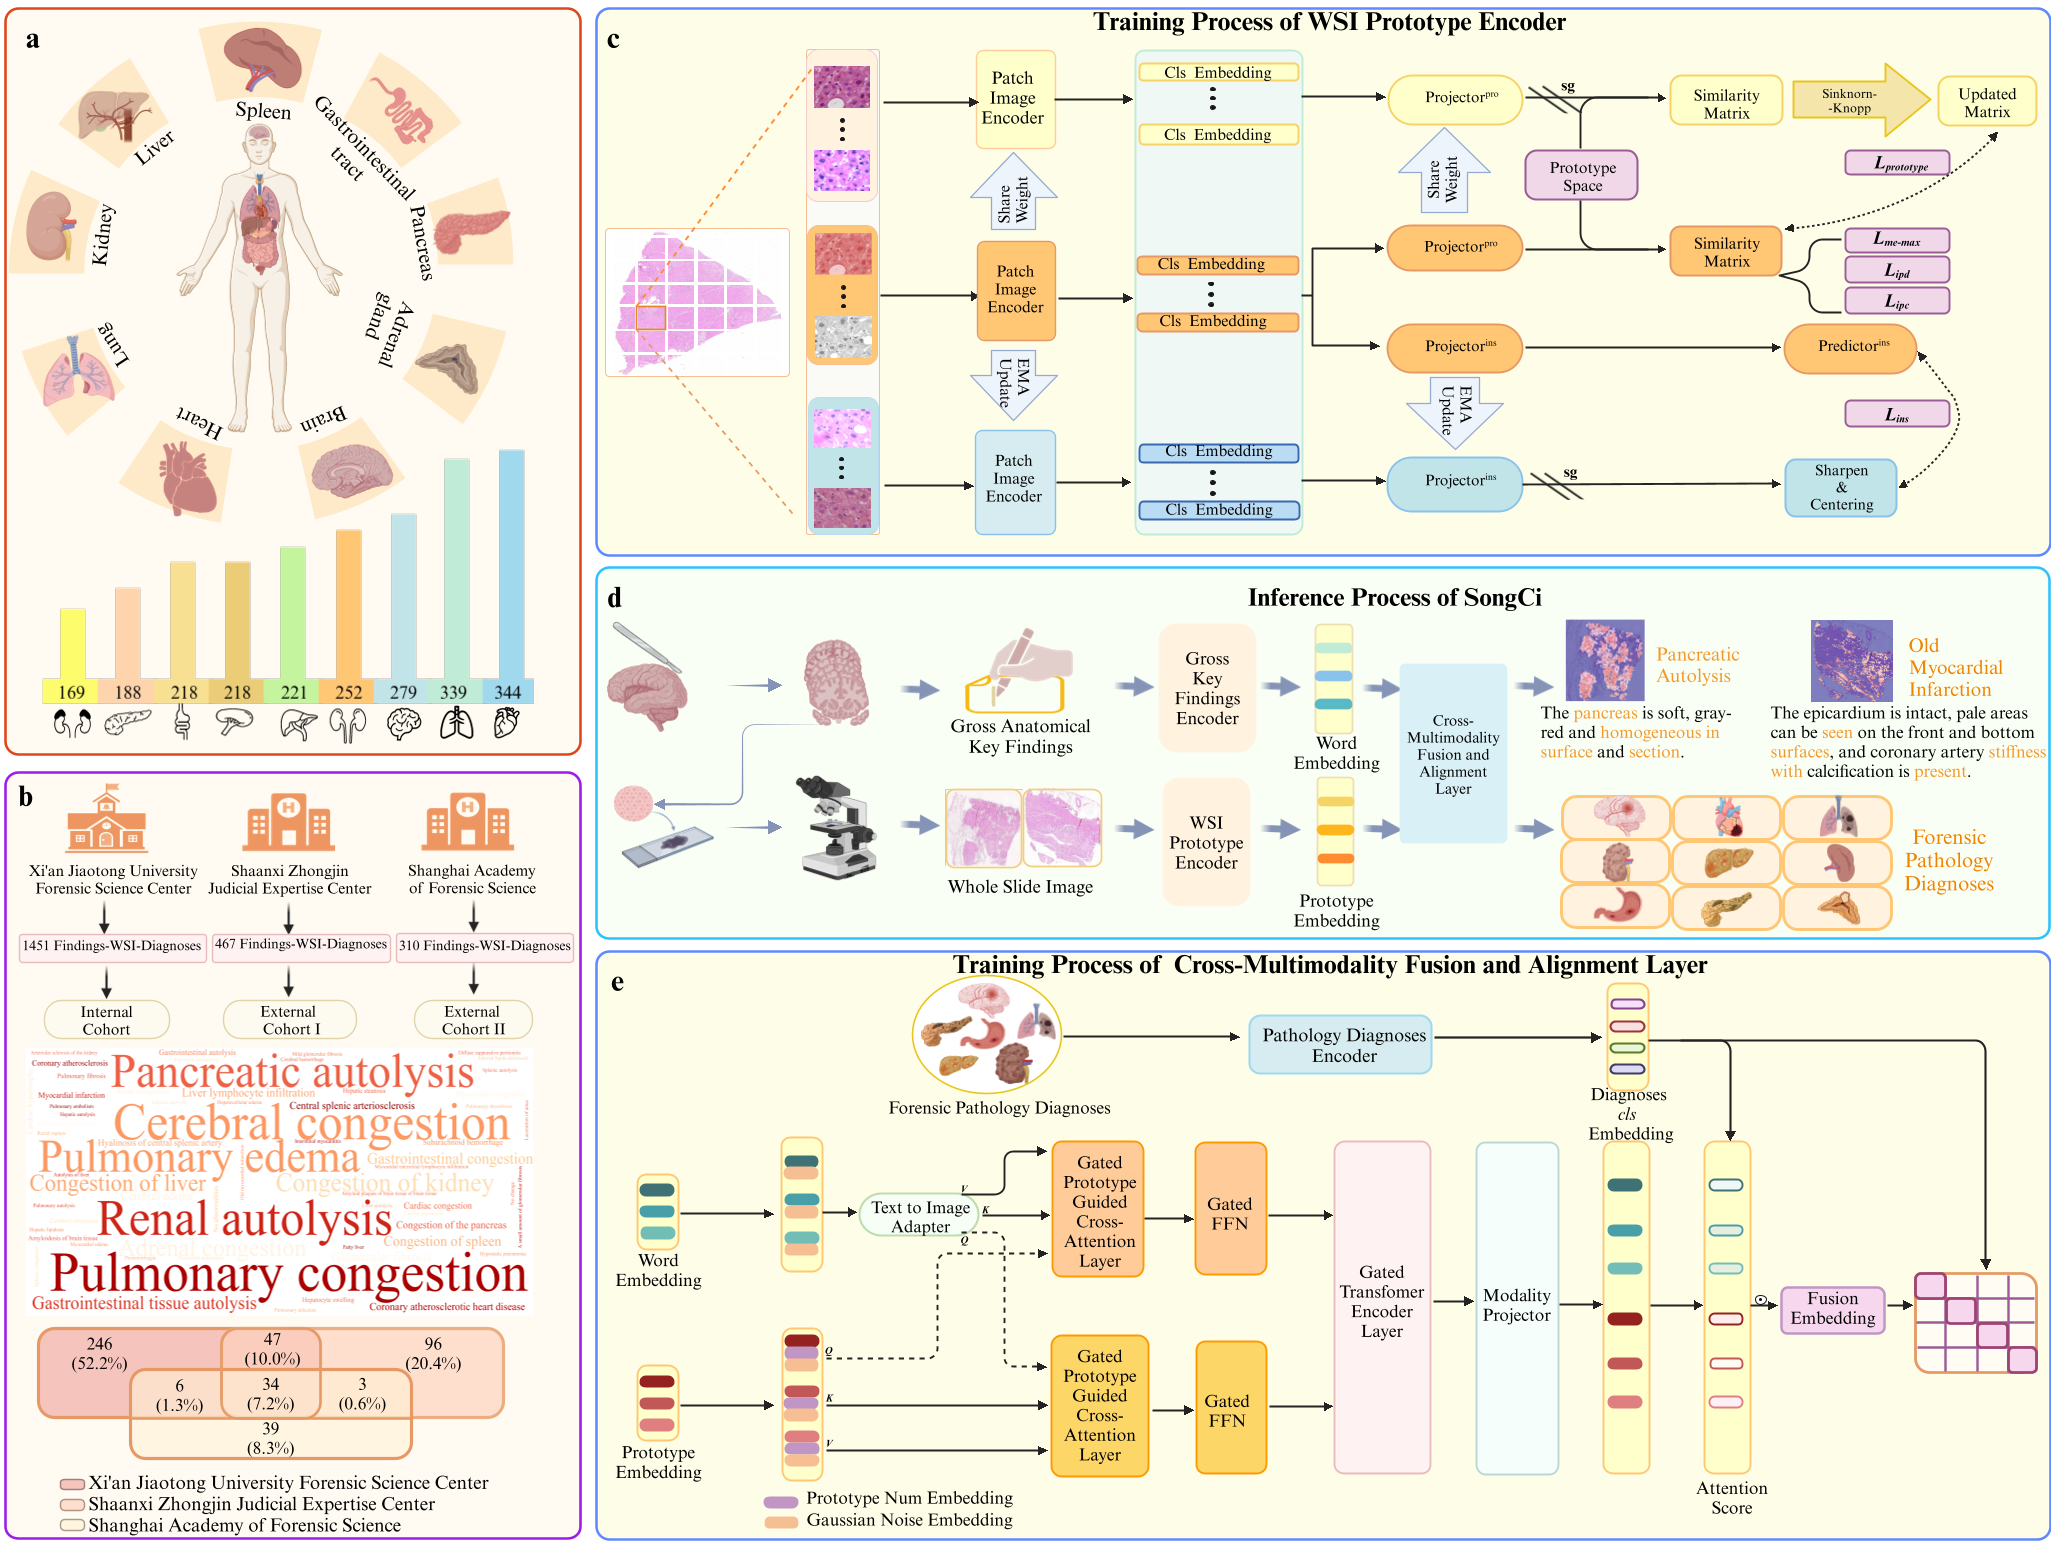 图 1:SongCi 的整体框架,包含 WSI 原型编码、多模态融合以及零样本诊断流程。
2. 门控注意力融合块 (Gated-Attention Fusion)
法医诊断不仅看图,还要看解剖记录。SongCi 引入了门控机制,动态地平衡图像和文本的贡献。这模拟了人类法医的思维:如果文本描述“由于腐败导致肝脏颜色改变”,模型会自动在图像中寻找自溶相关的原型特征进行验证。
实验战绩:超越 SOTA 与人机对抗
零样本诊断胜过资深法医
SongCi 在处理“从未见过”的诊断类别(Off-set Diagnoses)时表现出色。在与五位不同资历的法医对比中:
- 准确率:SongCi 显著优于助理法医和初级法医,与拥有 15 年经验的资深法医(Senior Pathologist)平起平坐。
- 效率:法医处理 100 张片子需要 5-15 小时,而 SongCi 仅需 22 分钟(0.37 小时)。
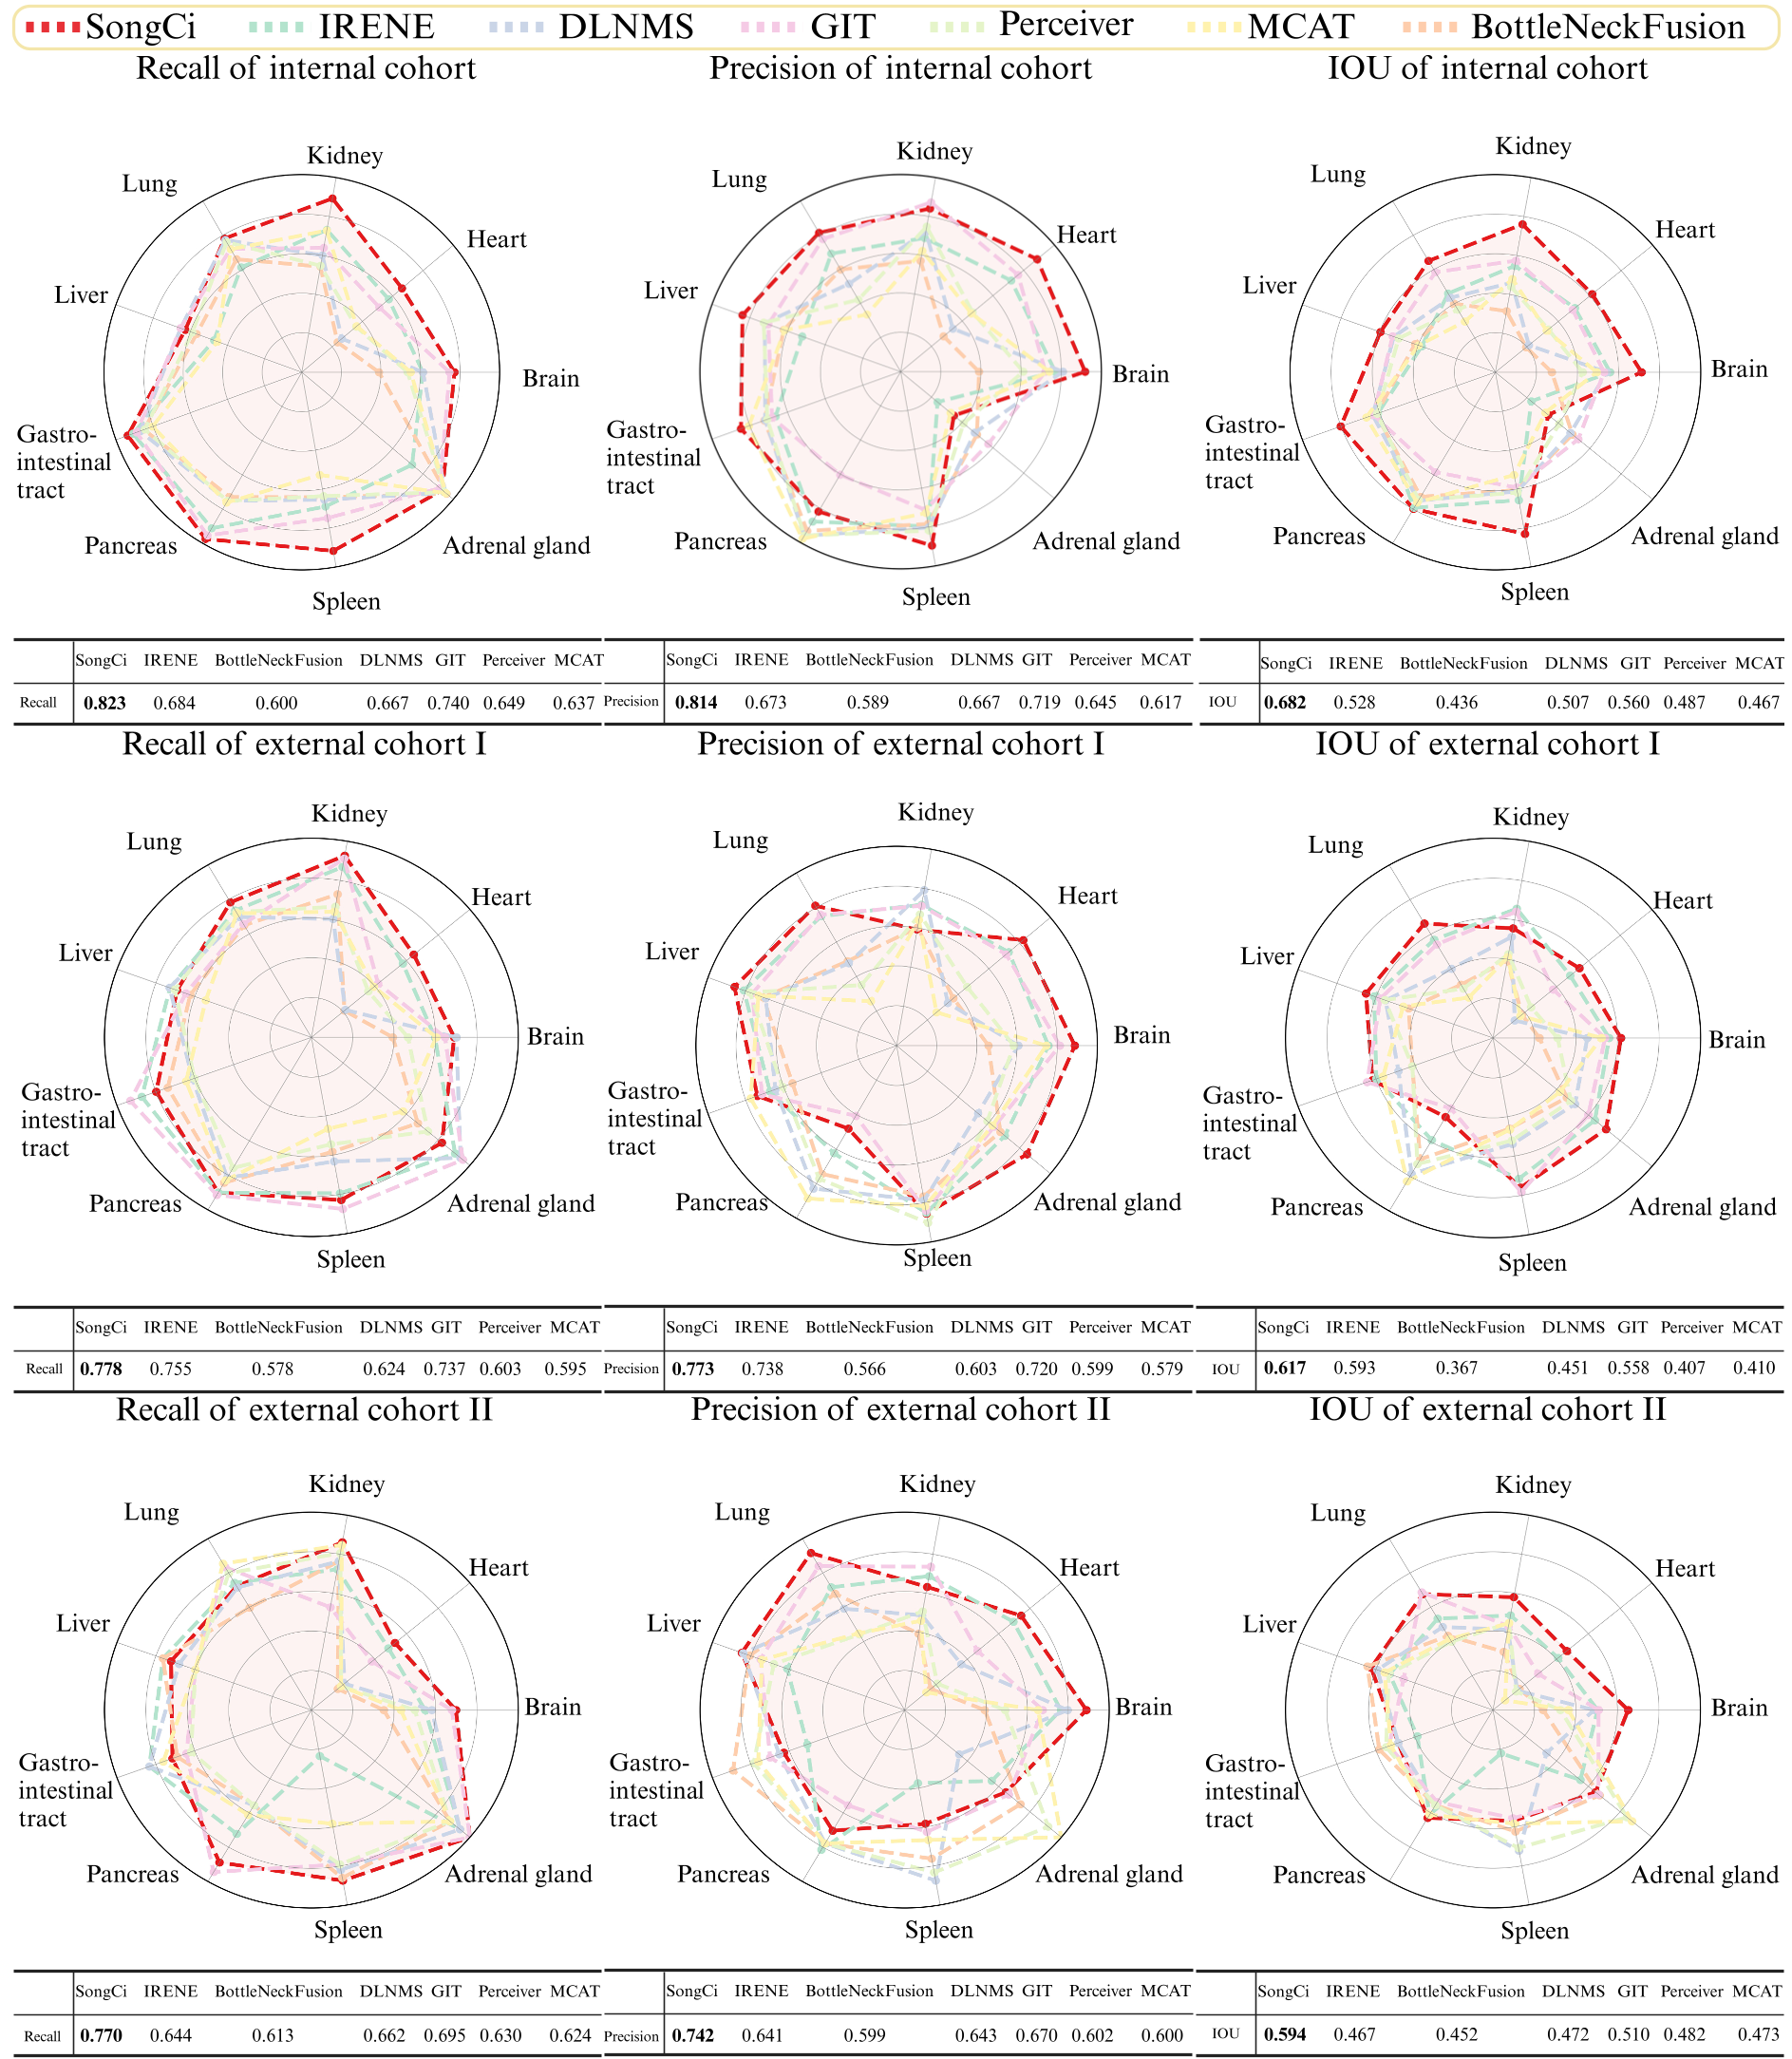 图 2:在 9 种器官的任务中,SongCi 在 Recall 和 IOU 指标上全面超越了现有主流多模态模型。
惊艳的可视化解释
SongCi 不仅给出诊断结论,还会通过注意力图(Attention Map)告诉用户:我为什么这么判。 例如,在诊断“肝硬化”时,模型能精准定位图像中的伪小叶(Pseudolobules)结构,并加粗文本中“粗糙(Coarse)”等关键词。
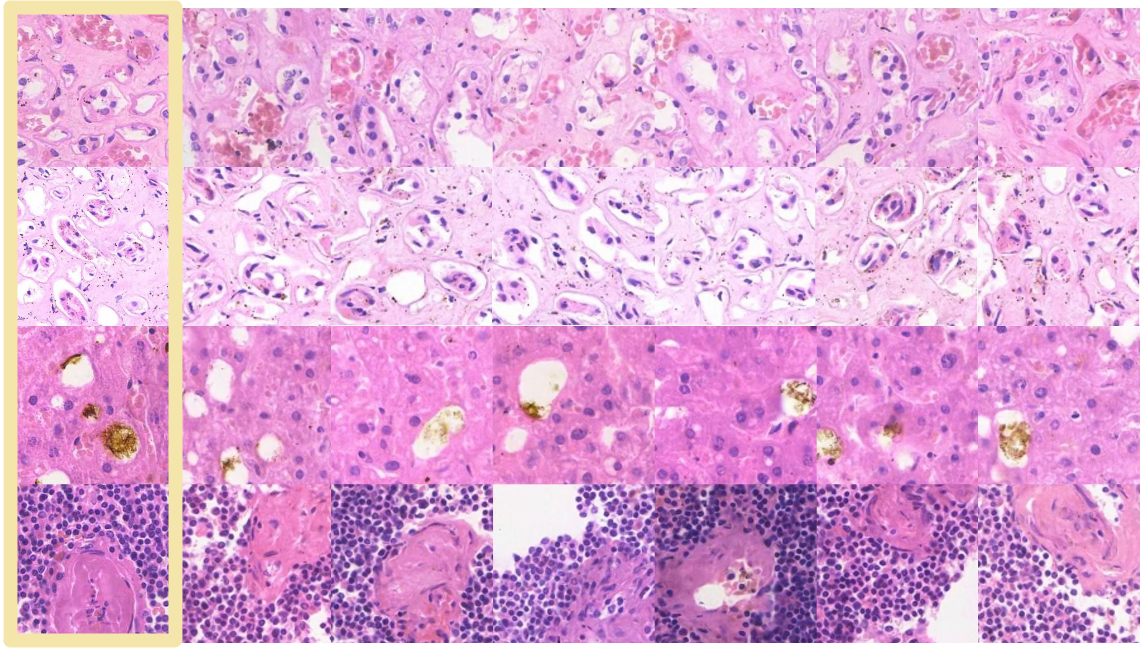 图 3:模型学习到的特征非常稳健,甚至可以驱动扩散模型生成具有极高真实度的自溶、出血等死后组织图片。
深度洞察
SongCi 的成功在于它没有试图去“强行识别”成千上万个标签,而是通过对比学习构建了一个灵活的语义空间。这种零样本推断能力(Zero-shot Learning)是解决法医学碎片化、多样化数据的关键。
虽然目前仍面临多语种支持和更多元数据(如毒理分析)融合的挑战,但 SongCi 的出现,标志着“智慧洗冤”时代的法医病理学正从主观经验主义迈向逻辑严密的 AI 数据驱动时代。
结论
SongCi 不仅是一个 SOTA 模型,它更为计算病理学提供了一个工业级范式:如何在极端复杂的样本背景下,通过原型学习提取通用的病理直觉。这对于未来的全数字化尸检(Digital Autopsy)具有重大的里程碑意义。