
隐式推理的底线:多少参数才够用?基于图搜索熵的新型缩放法则
Do Larger Language Models Generalize Better? A Scaling Law for Implicit Reasoning at Pretraining Time
本文确定了语言模型在预训练阶段实现“隐式推理”所需的最小参数预算,并提出了一种基于数据复杂度的缩放法则(Scaling Law)。研究表明,模型存在一个与图搜索熵(Graph Search Entropy)成线性正相关的最优规模,超过该规模的大模型虽能匹配性能,但并非必要且易过拟合。
TL;DR
在 AI 领域,“大”往往被视为“强”的代名词。然而,来自谷歌研究团队和 UCSB 等机构的最新论文《Finding the Minimal Parameter Budget for Implicit Reasoning》挑战了这一直觉。研究发现,语言模型进行隐式推理(即在不使用 Chain-of-Thought 的情况下推导新事实)并不是无止境的规模竞赛,而是存在一个由数据复杂度决定的最小参数预算。
核心洞察:
- 模型规模与推理表现之间存在 U 型曲线关系:过大或过小都不是最优。
- 提出了 图搜索熵 (Graph Search Entropy) 指标,精准预测所需的模型大小。
- 结论惊人:每参数仅能承载约 0.008 bit 的推理信息。
痛点深挖:推理能力是规模的“附庸”吗?
传统的 Scaling Laws(如 Kaplan 或 Chinchilla 法则)告诉我们,增加参数和数据量会单调地降低损失。但在处理复杂的逻辑推理时,这种观点显得力不从心。
作者指出,目前的预训练过程实际上包含两种行为:
- 知识记忆(Memorization):记住(A, 父亲, B)。
- 隐式推理(Implicit Reasoning):通过(A, 父亲, B)和(B, 父亲, C)推导出(A, 祖父, C)。
如果我们不知道支撑后者所需的“最小容量”,我们就会陷入要么模型太小无法推理,要么模型太大导致严重过拟合且浪费算力的困境。
方法论:用熵量化推理的“深度”
为了剥离自然语言的干扰,作者构建了一个类似现实知识图谱的合成环境,并引入了图搜索熵 。
核心逻辑
推理的本质是在知识图谱中沿着逻辑规则进行多跳搜索。作者将这一过程建模为一个基于最大熵随机游走(MERW)的概率过程。
- 实体熵(Entity Entropy):衡量在图中跳转时的分支复杂度。
- 关系熵(Relation Entropy):衡量在特定节点选择特定谓词的不确定性。
理论模型插图
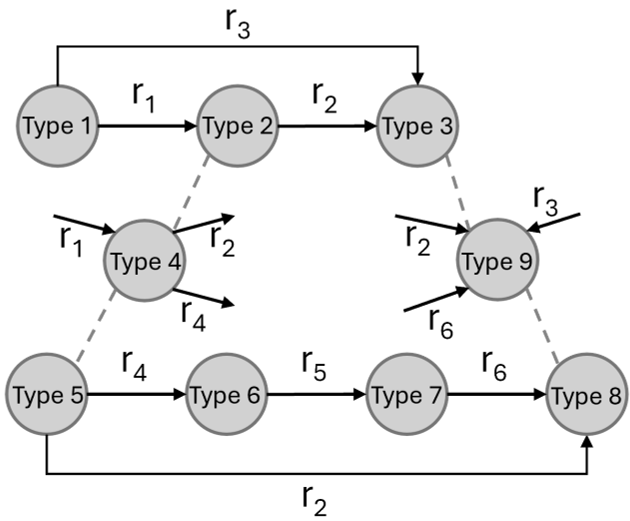 图 1:通过逻辑规则生成的节点类型。模型必须识别这些模式才能完成隐式推断。
实验与结果:U 型曲线的启示
研究人员通过消融实验,分别改变了三元组数量 、规则复杂数 、实体数 等变量。
关键发现 1:最优规模的稳定性
实验显示,随着训练步数的增加,最优模型规模(使测试损失达到最低的最小模型)会趋于稳定。这意味着:对于给定的数据集,存在一个“天生”的最优尺寸。
关键发现 2:线性缩放法则
这是文中最具震撼力的图表:最优模型规模与图搜索熵之间表现出极强的线性相关性()。
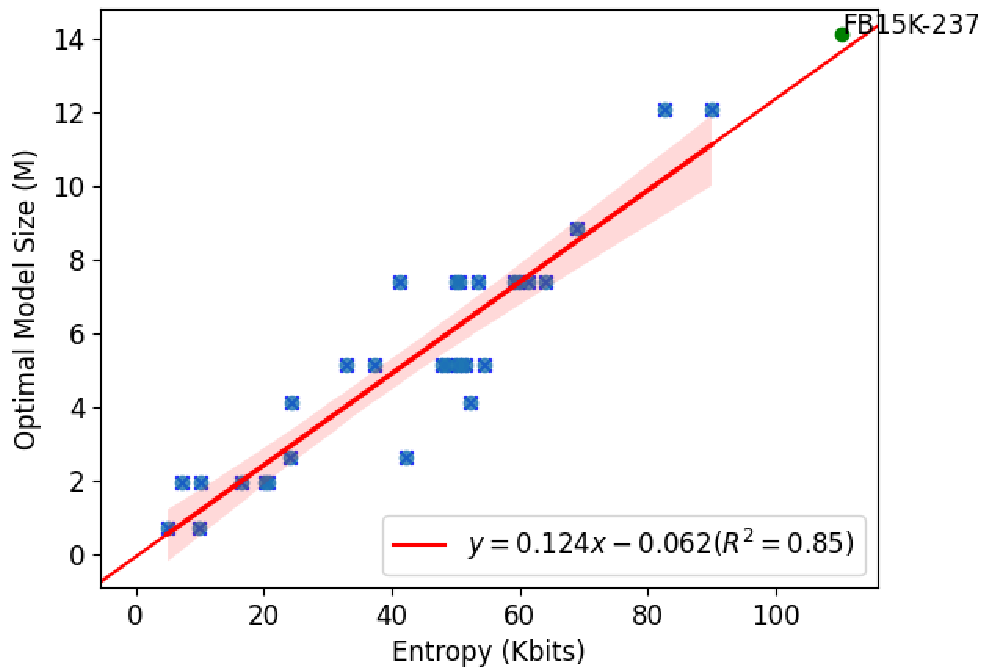 图 2:线性回归显示,每 1-bit 熵的增加需要约 124 个额外参数。
关键发现 3:极低的参数效率
前人研究认为模型每参数可存储 2 bits 知识,但本文揭示推理的代价要沉重得多:每个参数只能处理 0.008 bit 的推理信息。这解释了为什么“推理型”任务比“问答型”任务更消耗参数。
深度洞察:对未来的启示
- 告别盲目扩张:如果你的业务场景(如特定行业知识图谱)复杂度是可计算的,那么盲目上千亿参数的模型可能并不如一个精准设计的百亿模型高效。
- 区分记忆与推理:该法则提醒我们,模型规模的扩张应更多地服务于复杂关系的建模,而非简单的文本复读。
- 局限性:目前该研究在合成数据和 Random ID 上效果最佳。在充满语义重叠的自然语言语料中,由于存在“语义压缩”,实际所需的参数量可能会低于该理论上限。
结论
这项工作成功地将模糊的“推理能力”转化为可度量的“信息复杂度”,为我们理解大语言模型的容量边界提供了一把精确的标尺。在后大模型时代,按需缩放(Scale-on-Demand) 或将取代单调的规模扩张。