
为什么大模型学得更多:产能、干扰与稀缺任务保留的深度解析
Why Larger Models Learn More: Effects of Capacity, Interference, and Rare-Task Retention
本文探讨了为何大模型能学习小模型无法掌握的任务,提出了一个基于数据中心视角的研究框架。通过合成回归任务和 OLMo (4M-4B) 预训练实验,证明了大模型通过减少梯度干扰(Gradient Interference)和增强对稀缺任务的记忆保留(Retention)来突破学习瓶颈。
TL;DR
为什么规模更大的模型(Larger Models)能掌握小模型永远学不会的知识?斯坦福、MIT 与 Anthropic 的这项研究给出了一个“数据中心”视角的解释:这不仅仅是样本效率的问题,而是一场关于神经元资源的生存竞争。大模型通过其巨大的容量“喂饱”了常见任务,从而降低了梯度干扰,让稀缺任务的微弱信号得以在训练中生根发芽。
核心直觉:从“拟合能力”到“资源竞争”
学术界长期以来认为,小模型学不会某些任务是因为其“表达能力”不足。但本文作者通过数学推导(基于 Power-law Scaling)发现:即使给予无限的数据,小模型在某些任务上的损失函数依然会遇到瓶颈。
作者提出了一个关键洞察:任务之间存在梯度干扰 (Gradient Interference)。
- 小模型:有限的神经元被频繁出现、简单的任务霸占。每当稀缺任务(Rare Task)出现时,它产生的微弱梯度会被随后而来的海量高频任务梯度迅速抹除(Overwrite)。
- 大模型:随着宽度增加,高频任务在更大的子空间内得到解决。根据作者的定理 4,一旦高频任务被“学透”,它对剩余空间的梯度干扰就会变弱。这意味着稀缺任务终于有了喘息之机,可以通过多次观察通过“慢积累”建立特征。
理论验证:合成任务中的“阶梯现象”
作者首先在可控的线性回归混合任务中验证了这一逻辑。他们发现,任务特征是按照**效用(Utility = 频率 × 复杂度)**的顺序被学习的。
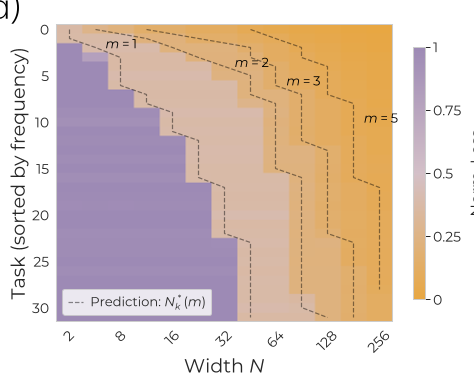 上图显示,只有当模型宽度跨越特定阈值时,低频率任务的损失才会显著下降。这印证了宽度是解锁长尾任务的关键。
真实世界实验:OLMo 预训练挑战
为了验证理论在真实大模型上的有效性,研究团队在 OLMo(4M 到 4B 参数)的预训练过程中人工注入了不同频率的“特殊任务”(如模加法 TADD 和数值比较 TCMP)。
1. 行为学证据
实验发现,频率越低的任务,越需要模型规模来“救场”。对于某些极其罕见的任务,小模型无论训练多久准确率都维持在随机水平,而 1B 以上的模型展现出了明显的“Grokking”(顿悟)现象。
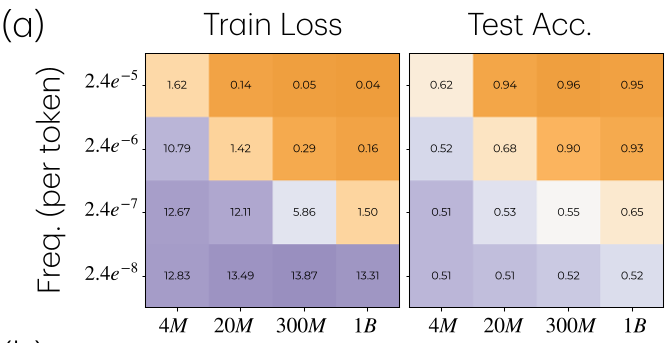 如图所示,橙色区域代表低损失。可以看到,模型越宽(纵轴),能覆盖的任务频率(横轴)就越低。
2. 梯度干涉分析
这是本文最精妙的部分。作者量化了任务梯度与常规语言模型梯度之间的对齐程度:
- 在 20M 的小模型中,由于资源极度紧缺,常规语言建模的梯度方向经常与特定任务方向相冲突(干扰大)。
- 在 1B 及以上的模型中,常规任务的梯度在特定神经元集合上几乎是正交的,干扰降至极低。
深度洞察:重新定义“记忆”与“泛化”
本文提出了一个颠覆性的视角:记忆(Memorization)可能是泛化的前提。 在处理罕见结构时,模型必须先通过强大的容量保留住这些零散样本的“记忆”。大模型优秀的记忆保留能力(Retention),使得它能跨越漫长的训练步数,将间隔出现的稀缺信号拼凑成抽象的结构化特征。
总结与启示
这项研究为我们工程实践提供了两条重要建议:
- Scale 不是万灵药,但能调和矛盾:如果你发现模型死活学不懂某些边缘用例,增加规模可以减少主流数据对边缘数据的“霸凌”。
- 数据混合比想象中重要:通过在训练后期调优数据配比(提高稀缺任务频率),可能比单纯把模型做大更经济。
局限性:虽然本文解释了宽度(Width)的作用,但对于深度(Depth)以及更复杂的注意力机制干扰,仍有待进一步探索。