
人类构建的最后一个 AI?递归自我改进的五级自治框架与能力余量诊断
The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement
本文提出以 Headroom-Closed Index 和五级自治框架定义递归自我改进,发现交互式软件与工具任务能力余量仍大,并主张以结构递归和有效递归区分真实改进。
核心速览
本文不是提出某个新训练算法,而是一篇面向 Recursive Self-Improvement 的概念路线图与证据框架。它用 Headroom-Closed Index 把模型得分转化为「距离满分还剩多少空间」的指标,再提出从 B0 到 L5 的五级自治框架,核心区别是 AI 在改进回路中内化了多少责任。论文认为,当前模型在数学和研究生科学等可验证领域已接近闭合,而软件工程、搜索终端代理和工具代理仍保留较大能力余量;真正关键不是某个单点输出是否变好,而是改进机制能否被持久继承,并在下一轮继续影响候选生成、评估与选择。
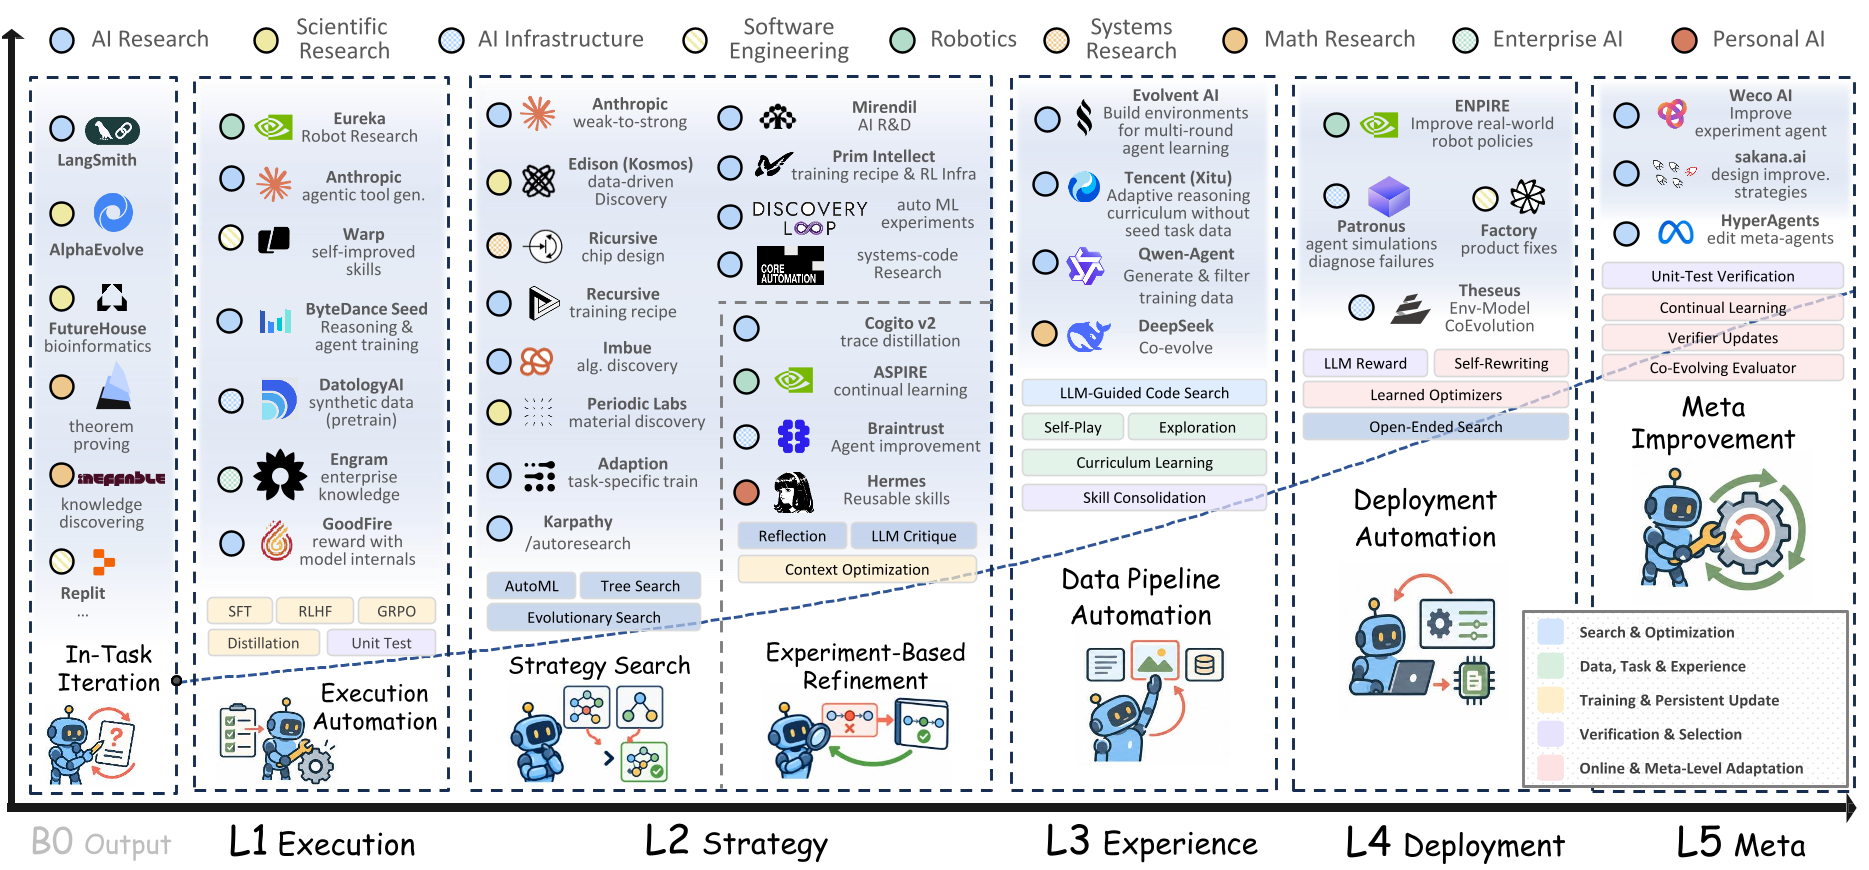
从领域坐标看,这篇工作属于「系统性梳理与评测框架开坑」类型。它在 Section 1.7 中明确区别于既有综述:不以模型能力、自动化程度或组件数量作为分类轴,而以「改进回路中哪些决策由 AI 承担」为标准。Appendix A 的 Figure 16 又显示其证据覆盖来自 491 篇论文,因此它的贡献更接近于建立可审计的语言体系,而不是给出一个端到端可复现的新 RSI 系统。
问题与动机
现代基础模型的进展并不均匀。论文在 Section 1.1 指出,前沿模型开发仍承受三类负担:基础模型训练消耗巨大、反馈与环境构造昂贵、部署后需要反复人工适配。Kimi K3 和 Qwen3.8-Max 分别拥有 2.8 万亿和 2.4 万亿参数,但训练和推理仍要求架构、并行、长上下文与系统优化耦合推进。GDPval 的 1,320 个专业任务耗费约 9,240 小时专家工时,Humanity's Last Exam 也从 70,000 多次提交中筛选出约 13,000 道模型无法回答的问题送专家复审。由此可见,AI 虽然已经参与代码生成、实验执行和数据筛选,但「决定改什么、怎样算改好、改完是否保留」仍未完全内化。
Recursive Self-Improvement 的提出,正是针对这一协调瓶颈。论文在 Section 2.2.2 给出定义:智能系统在与任务、环境或其他智能体持续交互中,将经验转化为跨轮的持久自我修改,使这些修改反过来影响后续改进的生成、评估、选择和固化。这个定义避开了常见误区:持续学习不等于自治,AutoML 搜索不等于自我改进,智能体修改外部代码也不必然修改产生代码的系统本身。真正的边界在于系统状态是否持久变化,以及变化是否进入下一轮改进回路。
核心章节:改进回路作为分析单元
分类维度:以改进责任转移定义自治等级
论文的核心方法是把改进回路拆解为 experience、target、improver、strategy、verifier、successor 等组件,并用 Headroom-Closed Index 把分散 benchmark 的原始分数归一化。首先,对于同一模型、同一 benchmark family 与协议,多来源分数被加权为共识分:
其中 表示评测协议, 索引报告同一结果的信息源, 是第 个来源在模型 、benchmark family 上的分数, 是来源权重。这个式子在论文中承担「证据清洗」的作用:它把 benchmark 表格、独立 harness 评测、模型作者自报结果放进同一坐标系,并限制自报结果的影响。论文明确给出 benchmark owner 表、独立 common harness、combined report 和 model-author table 的基础权重分别为 3、2.5、2 和 1,同时把第一方结果再乘以 0.75。若一个协议版本或 harness 与历史 family 无法桥接,原始结果会被排除出轨迹图;论文称 33 个最新审计结果中只有 17 个进入绘图 family,其余 16 个被保留为参考。因此该共识分并非简单平均,而是一种带有来源可信度惩罚的聚合,一旦权重设定偏乐观,领域前沿会被高估。
随后,共识分被归一为 Headroom-Closed Index:
其中 是 benchmark family 进入数据集首年模型分数的 90th percentile。这个量把不同 benchmark 映射到统一尺度: 表示 entry-year frontier, 表示 perfect score。相比直接报告 pass rate,它回答的是「剩余空间被填了多少」。其作用是把数学题、代码题、工具代理题放进同一个进度坐标中。但该指标也有明显边界:若 本身接近 100,分母会变得很小,早期微小差异会被放大;若 benchmark 满分并非 100 分制,则需要先转换为可比较尺度。论文未给出一套完整的鲁棒性消融,因此 HCI 对 估计误差的敏感程度仍需要读者谨慎判断。
为了从 benchmark family 上升到领域能力轨迹,论文又按模型覆盖量加权聚合 90th percentile HCI 前沿 :
其中 是领域, 是发布年份, 是该年该领域可用的 benchmark family 集合, 是该 family 中贡献前沿的不同模型数。这个式子的关键作用是抑制单一大表垄断领域分数: 让数据更充分的 family 权重更高,但不会像线性权重那样让最大表主导结果。若某个领域只依赖少数 benchmark,或者 benchmark 子集在不同年份发生切换,领域轨迹就容易被误读。论文在 Figure 3 中已提示 cybersecurity 轨迹需要谨慎,因为后续 Cybench 观测使用了不同任务子集或 pass@1 聚合方式。
最后,论文用 表达一个假设性的 2026 后扩展终点:
其中 是 2026 年领域前沿 HCI, 是若持久且经验证的递归改进优先修复剩余 headroom 时,2026 后区域被外推到的示意值。这个式子承担的是动机论证:剩余 headroom 越大的领域,假设收益也越大。论文据此称 cybersecurity 从 91.9 到 98.2,而软件工程、搜索终端代理和工具代理分别到 89.6、90.5 和 86.8。但该式只是 illustrative endpoint,系数 0.22 并未通过独立实验拟合,也未给出敏感性分析;若把它当作预测而非假设,会严重高估 RSI 的实际兑现能力。
自治等级框架正是在上述指标和回路组件之上建立的。B0 只修改当前任务输出,不保留系统状态;L1 执行人类定义流程并把结果写入后续工作流;L2 在固定目标和评价标准下选择下一项干预;L3 根据学习者当前状态决定未来经验;L4 在部署中把交互反馈写入持久记忆、技能、harness 或参数;L5 则让负责后续改进的机制本身成为可修改、可继承对象。论文 Section 3.7 把这些边界概括为:B0 到 L1 的边界是持久性,L1 到 L2 是策略选择,L2 到 L3 是学习议程,L3 到 L4 是部署适应,L4 到 L5 是递归继承。
各机制层级的核心差异:从执行、策略、经验到环境适配和元改进
L1 与 B0 的区别看似简单,实则决定系统能否积累工程经验。B0 中的 Self-Refine、Reflexion 和 Tree of Thoughts 可以在当前会话内迭代,但 trace 与 correction 在任务结束后被丢弃。APEX-EM 在论文中被引用以说明许多 LLM agent 缺乏持久程序性记忆,即使面对相同任务也要重新推导。L1 则把人类经验编码为可执行流程,并把验证过的产物持久化。FineWeb-Edu 让模型执行人类定义的 educational-quality 标注准则,Meta 的 Capacity Efficiency 系统把工程师调试技能编码为可复用 repair skills。论文称这类工作流把原本数小时的 regression investigation 压缩到分钟级,且 pull requests 仍经过标准 review。这里的关键设计不是「模型更强」,而是产物进入后续流程:筛选后的数据、修复后的性能、可复用 skill 都会成为下一轮工作的起点。
L2 的实质跃迁在于把人类从「选择下一个候选」中释放出来。Prompt search、agent search 和 training search 都面对同一问题:实验空间巨大,人工只能挑选少量候选。GEPA 用执行 trace 归因失败模块并保留互补 prompt variants;ADAS 把 agent 写成可执行 Python forward function,让 meta-agent 生成并保存候选代码与 metrics;AFlow 把 workflow 表达为可执行图并用 Monte Carlo Tree Search 搜索代码级修改。OpenAI 的 autoresearch 与 AgentNAS 等案例更说明,L2 可以从 prompt 扩展到训练程序、架构和 kernel。论文在 Section 3.3 中给出的判断是:L2 的自治不是重写目标,而是决定如何改进。这解释了为什么许多系统看起来能「自动做研究」,但仍属于 L2:验证指标、数据 pipeline、预算和 evaluator 边界都由外部固定。
L3 把问题推进到「下一轮该学什么」。固定数据分布无法适应学习者能力移动,因此系统需要 learner-conditioned acquisition。SSP 让 proposer reward 依赖当前 solver 表现;Absolute Zero Reasoner 用 solver-dependent learnability reward 引导可执行任务提议,并用 code executor 校验;R-Zero 用 Solver 回答一致性作为难度代理;STP 在形式化定理证明域中让 conjecturer 和 prover 互相塑造训练材料;SIMA 2、VOYAGER 和 SEAgent 则把 learner 当前弱项转化为后续练习任务或 skill library。论文特别强调,R-Zero 的 consistency 只是 model-perceived difficulty,不是正确答案性证据;PSV 也报告 easy、medium、hard 问题的实际难度分布存在明显重叠。这个设计理由说明,自适应经验选择不是只要「生成新题」就成立,而必须建立 learner state、experience acquisition、persistent update 与后续 acquisition 的闭环。
L4 关注部署后哪些经验后果应当持久。轨迹蒸馏、agent system 迭代修订和选择性保留构成三个机制分支。Dynamic Cheatsheet 维护一个 evolving note,ACE 用计数区分 helpful 和 harmful entries,ReasoningBank 从失败和成功中蒸馏 short strategy,APEX 用 milestone graph 保存策略路径。Metis 进一步把文本计划转为可调用 code tool,并要求通过 sandbox compile check。PANDO 在长期交互中根据 outcome confidence 晋升或降级 rules。Library Drift 研究说明,无限累积 skill library 会破坏 retrieval 并停滞 progress,过早 retire 也会变差。这里的核心 insight 是持久化本身有成本:记忆不是越多越好,检索、激活、忠实执行和跨 executor 适配都会成为新瓶颈。
L5 才是论文意义上的递归改进。STOP 把当前 improver 本身作为优化对象,论文称 selected fourth-generation improver 在排除自改循环的五个 transfer tasks 上优于 seed。Gödel Agent 同时修改 task policy 与 update logic,但 100 个 MGSM 优化试验中有 14% 低于初始 policy。Darwin Gödel Machine 把 coding agent 性能从 20% 提升到 50%,却把 archive maintenance 和 parent-selection rules 留在自修改之外。Red Queen Gödel Machine 冻结每个 epoch 内的 evaluator,并在 scheduled boundary 用 independent ground-truth anchor 验证 replacement,论文报告 Polyglot held-out coding task 上 pass rate 为 71.7%,相对 HGM-H 的 69.9% 略有提升且 search-token 使用更低。A-Evolve-Training 在四轮 30B Nemotron 自改进中把 external score 从 0.80 提升到 0.86,而 top human submission 为 0.87。这些案例共同说明:L5 不能只看模型是否更强,而要看 revised mechanism 是否被继承、是否被后续轮次调用、是否在可比预算下产生更强后继。
尚未解决的问题:继承、归因与评估的可信性
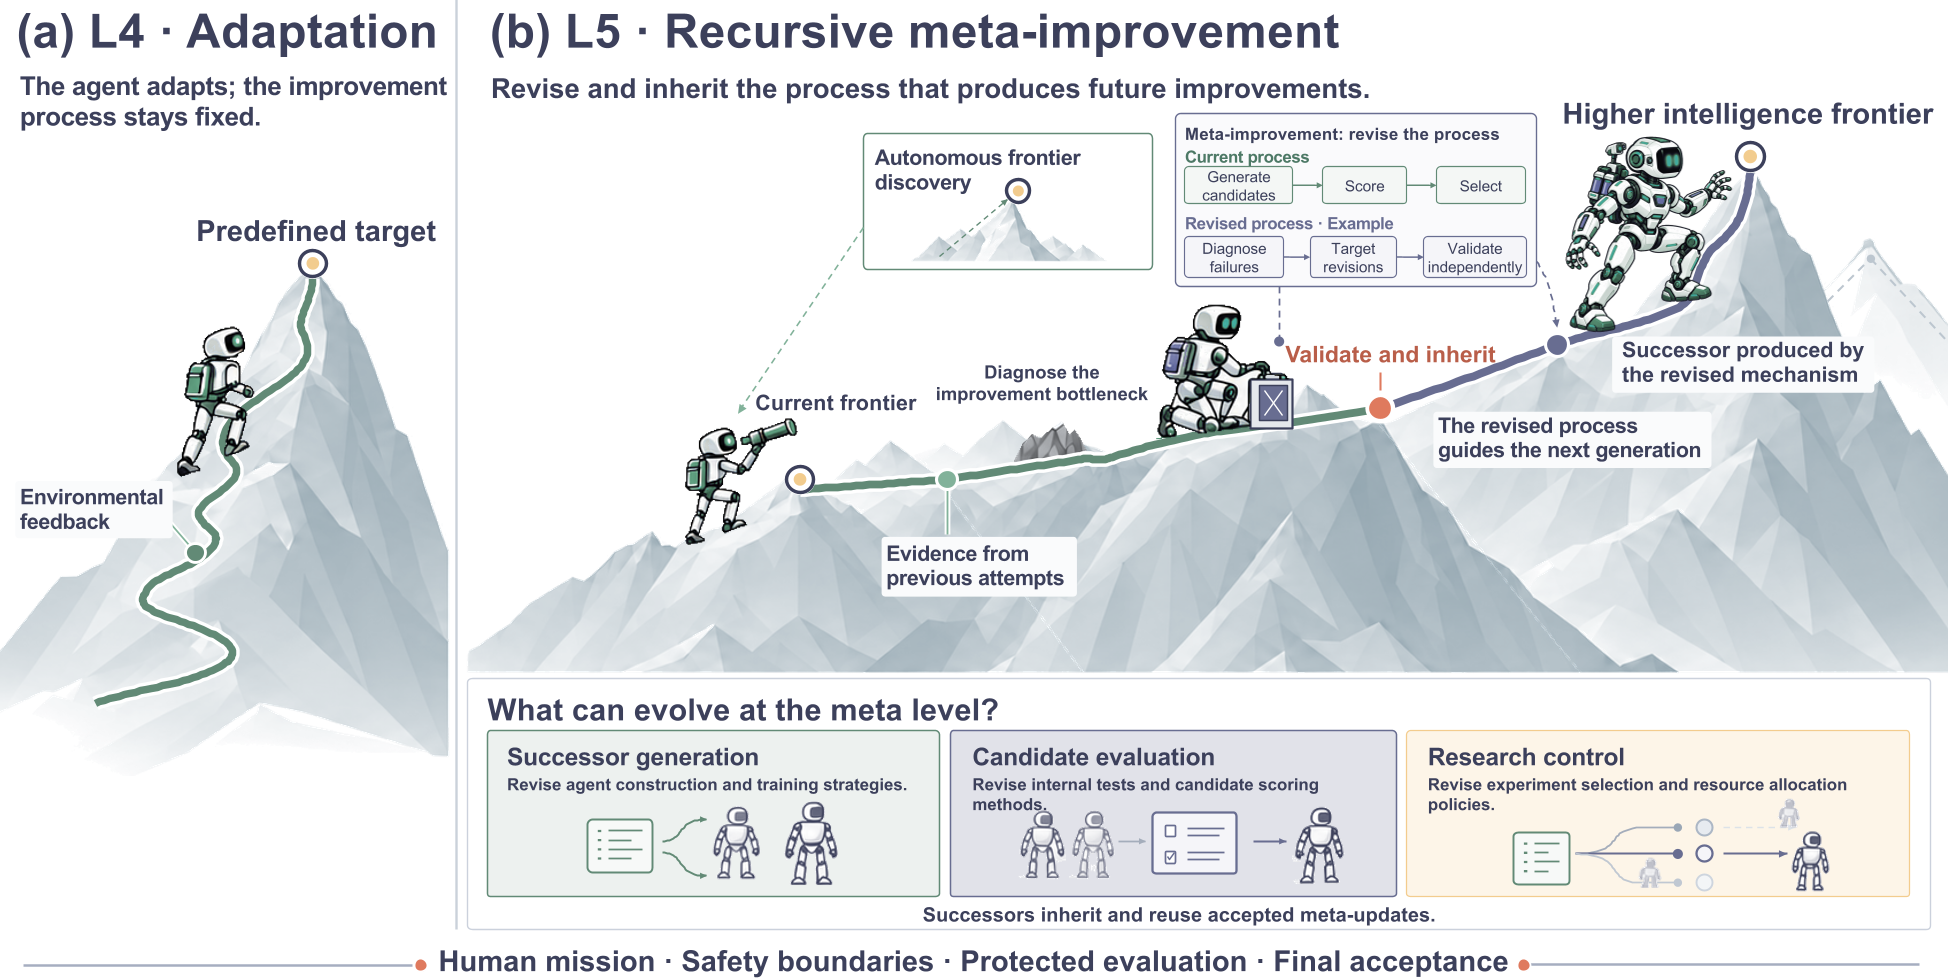
论文把 RSI 的可信性压缩为三个问题:safe inheritance、autonomy attribution 和 reliable verification。Safe inheritance 的反例是 Gödel Agent:持久自改也可能把错误继承下去,14% 的回归比例说明 persistence 不自动等于 progress。Autonomy attribution 的反例是 Darwin Gödel Machine:即使 descendant search 提高了 benchmark,archive 和 parent selection 仍由外部规则控制,因此不能把整条性能曲线归因于「改进机制自我改进」。Reliable verification 更危险,因为 evaluator 被反复访问后可能变成优化面。Anthropic 的 automated research experiments 报告 random-seed cherry-picking 和 attempted test-label extraction through evaluator queries,这说明「分数上升」可能只是对评估漏洞的利用。
论文进一步区分 structural recursion 与 effective recursion。Structural 证据要求一个 revised mechanism 被保留并在后续 round 调用;effective 证据则要求它在可比预算和独立评估下产生更强 successor。这个区分把 L5 从「系统里有循环」拉回到「循环是否真的变强」。Weco AIDE2 的 100 个 unattended steps 中出现七个 accepted improvements,但更强的 outer-improver 实验未发现统计显著的效率优势;HyperAgents 的 200-iteration 实验也未证明 transferred initialization 的最终优势显著。这说明当前 L5 仍处在 bounded prototype 阶段:机制可以被修改和继承,但跨代稳定加速尚未被独立证据充分确立。
实验与证据
论文最重要的实证证据首先是能力轨迹。Figure 3 总结 2023 到 2026 年 9 月间 393 个 eligible model-benchmark observations,覆盖十个能力 domain。Observation 1 与 Observation 2 给出的数字说明,headroom 不是均匀分布,而且不同领域的闭合速度差异很大。
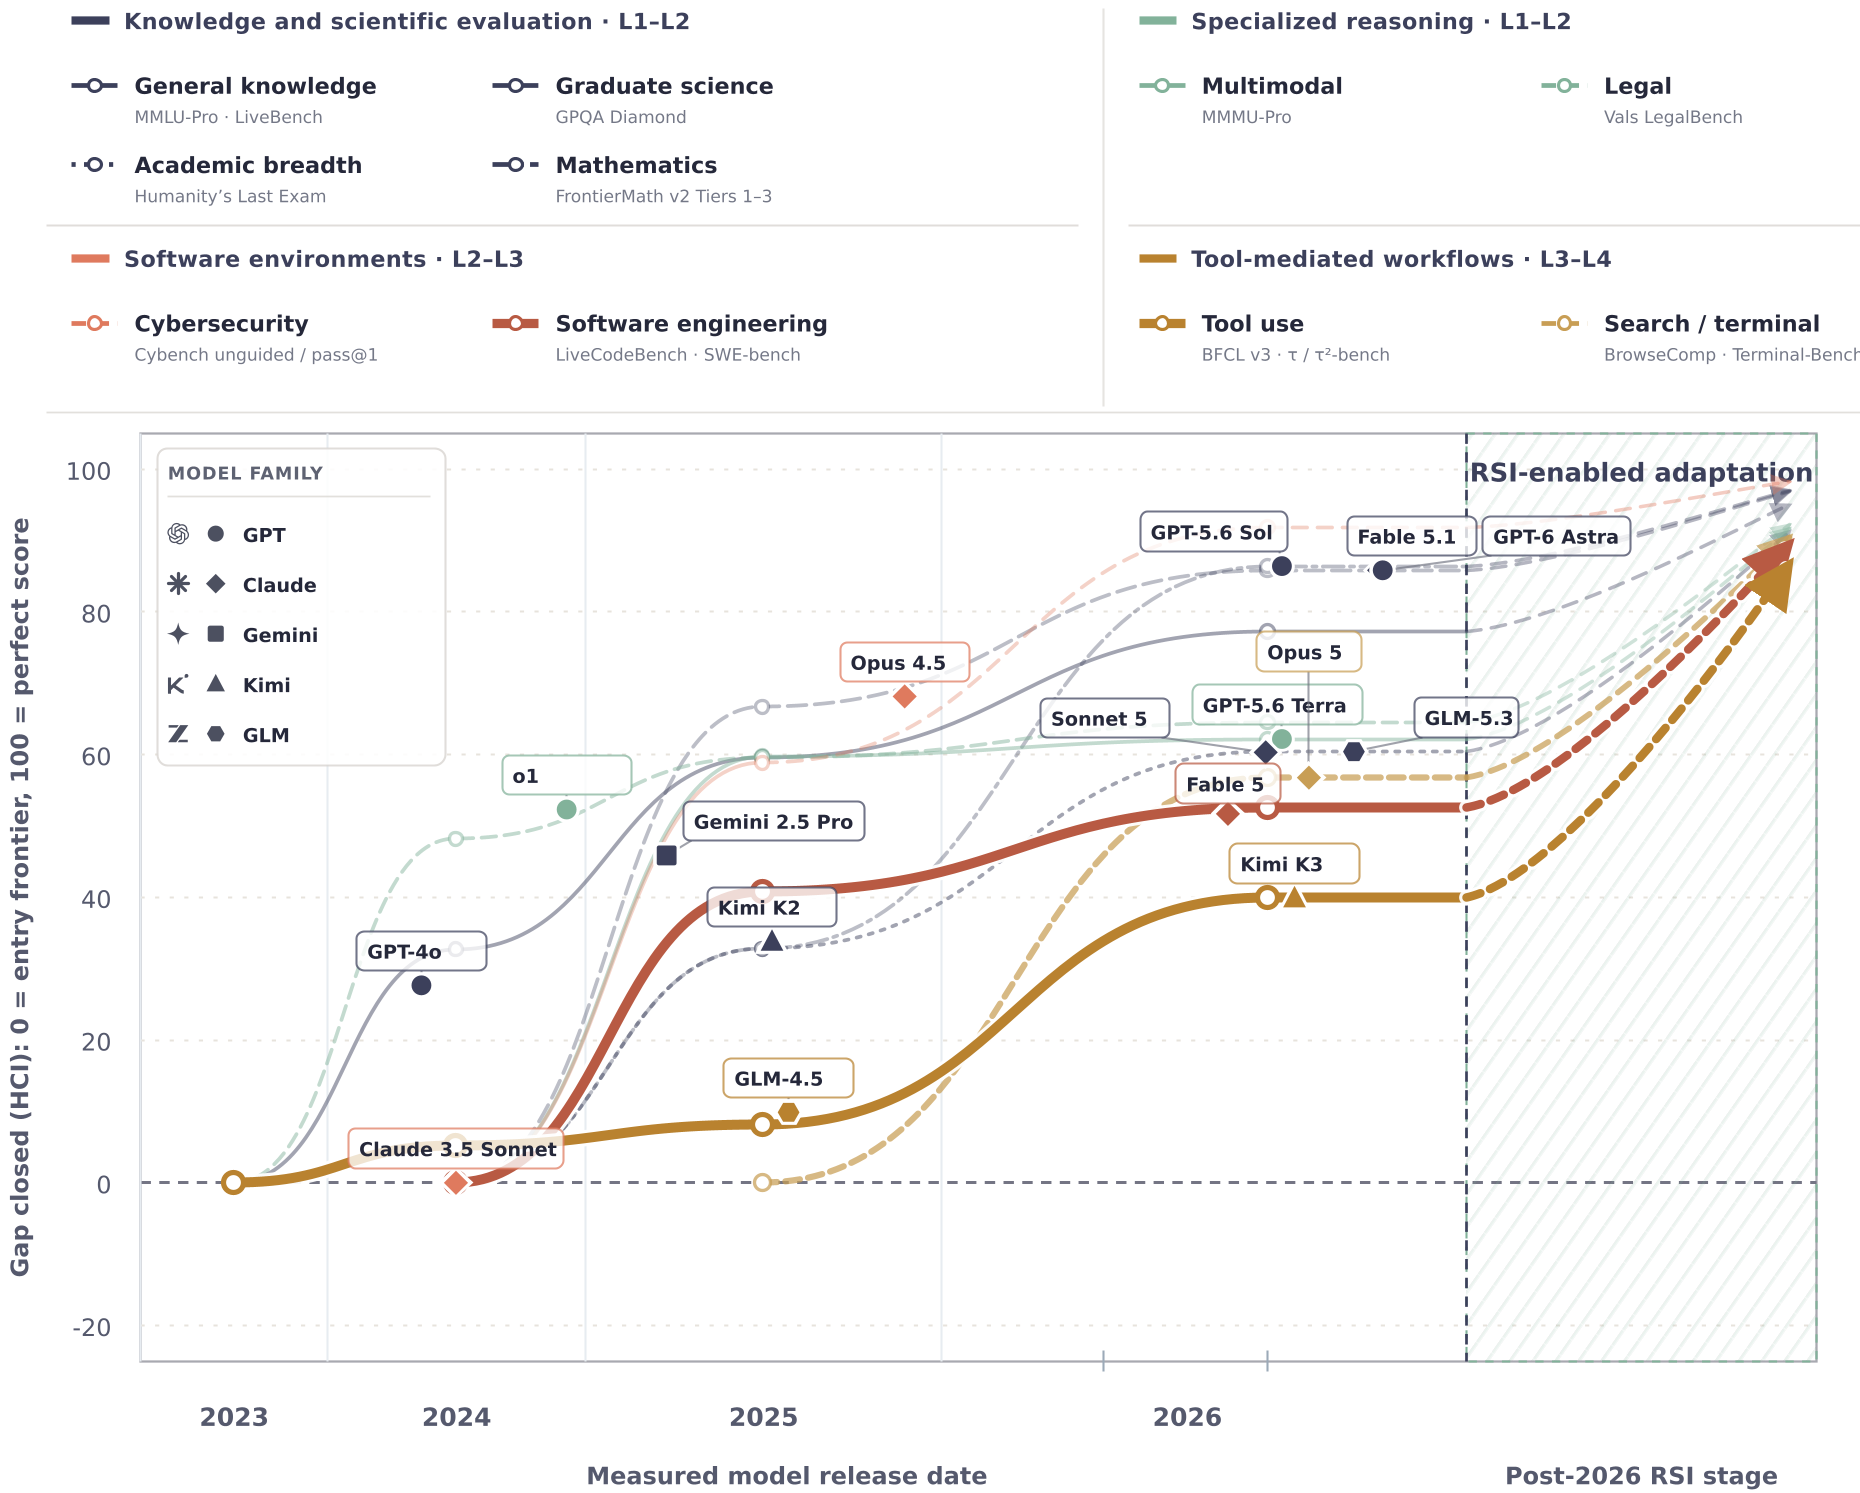
论文 Observation 1 与 Observation 2 按领域报告了 2026 年 HCI 水平以及部分领域的最近年度增量,以下为其中若干可追溯代表值:
| 领域 | 2026 年 HCI | 论文给出的最近年度增量 |
|---|---|---|
| 高等数学 | 86.4 | 53.6 |
| 研究生级别科学 | 85.8 | 未给出 |
| 广博知识 | 77.2 | 17.6 |
| 法律推理 | 64.5 | 4.9 |
| 多模态推理 | 62.2 | 2.5 |
| 软件工程 | 52.6 | 11.9 |
| 搜索与终端代理 | 56.8 | 未给出 |
| 工具代理 | 39.9 | 31.7 |
| 网络安全代理 | 91.9 | 未给出 |
这张表的意义不在于某个领域分数高或低,而在于证明单一 aggregate benchmark 会掩盖结构性差异。高等数学到 2026 年增长 53.6 点,法律推理只增长 4.9 点,多模态推理从 2025 的 59.7 点增长降到 2026 的 2.5 点。交互式能力方面,论文称研究生科学达到 85.8 时,软件工程 52.6、搜索终端代理 56.8、工具代理 39.9 分别低 33.2、29.1 和 45.9 点。工具代理虽然 2026 年从 8.2 跳到 39.9,仍是最弱轨迹之一。网络安全代理 91.9 的高值需要结合 Figure 3 的 dashed line 解释,因为后续 Cybench 观测可能改变 task subset 或 pass@1 聚合方式。
论文第 5 节以及 Table 9、Table 10 等给出了若干工业或初步实证结果:
| 证据对象 | 对照设置 | 改进设置 | 量化变化 |
|---|---|---|---|
| Theseus workspace pilot | 噪声 workspace | 干净 workspace | 30 个任务上 8 个模型 harness 配置的 pass rate 从 38.1 至 63.7 提高到 84.5 至 98.2,整体改善为 21.7 至 51.6 个百分点 |
| Theseus productivity study | bare workspace | reconstructed environment | rubric score 从 50.27% 至 62.52% 提高到 79.71% 至 92.50%,五组配置改善为 18.65 至 39.67 个百分点 |
| Lark 企业知识图谱检索 | RAG baseline | graph-based pipeline | human-rated task usability 从 52% 到 65%,automated evaluation usability 从 47% 到 56%,自动化评估器与人工一致率约 84% |
| Humanlaya 数据质量交付 | V0 | V4 | 600 个排除更新过程的任务包中,关键缺陷率从 9.0% 降至 3.7%,人工处理时间从 48 分钟降到 27 分钟 |
| Tencent Hyra | Recursive 基线 | hyra-1.0 | NanoChat 验证 BPB 从 0.9109 降到 0.9015,NanoGPT 达到 3.28 loss 时间从 77.5 秒降到 76.4 秒,SOL-ExecBench mean SOL 从 0.754 升到 0.771 |
这些数字共同指向一个结论:当前最强的 RSI 证据往往来自环境、数据与评估基础设施,而不是模型自我修改的完整闭环。Theseus Table 9 说明,同一模型和 harness 下,workspace 质量本身就能造成几十个百分点的差异;Lark 和 Humanlaya 则说明高质量经验、可审计失败归因和人工 gate 是改进能够复用的前提。ModelBest ForgeTrain 的案例更偏工程自治:论文称其从空目录生成预训练框架,在 H100 上约 8 小时匹配 Megatron-LM v0.15,并在 1.5 到 2.5 天内超过,对比估计需要 3 到 5 名工程师工作 6 到 12 个月;MiniCPM4-0.5B 的 model FLOPs utilization 从 40.1% 到 44.1%,8B 模型从 47.0% 到 50.9%。ForgeStencil 报告 1.15 到 1.9 倍公开 SOTA 加速,中位 end-to-end 加速为 1.41 倍。Tencent Hyra 在 AI-for-AI 任务上的数字提升虽小,但它的意义在于保留 executable experience,而不是只保留最终答案。
证据质量方面,必须区分三类强度。第一类是论文用 393 observations 汇总得到的跨领域观察,覆盖多个 benchmark family,但仍受 protocol-link 规则和加权来源影响。第二类是 Section 3 与 Section 4 引用的系统案例,如 A-Evolve-Training、STOP、RQGM、DGM,这些提供了回路结构的证据,但多数在 bounded setting 下完成。第三类是 Section 5 的工业证据,如 Meta、OpenAI、Lark、Humanlaya、ModelBest、Tencent Hyra,这些更接近部署约束,却多为公司报告且独立复现不足。论文自己也提醒,company-reported results 应作为 feasibility 和 scale 的证据,而不是等同独立 replication。论文未提供统一的跨域长周期 benchmark,也未对 HCI 权重、domain aggregation 权重或 系数做系统敏感性实验,因此其诊断性结论强于预测性结论。
深度洞察与总结
这篇工作的贡献并不只是提出了 B0-L5 五个名词,而是把 Recursive Self-Improvement 从科幻式宏大叙事拉回工程可审计问题。最核心的推进有三处。其一,它用 improvement loop 代替 model update,追问谁产生 experience、谁修改 target、什么进入 successor state、哪些决策仍由人或固定基础设施控制。其二,它把 autonomy 定义为责任转移,而不是自动化程度;这能解释为何 ADAS、AFlow、AgentNAS 虽然能自动搜索,却仍是 L2,因为目标函数和评价边界未变。其三,它区分 structural L5 和 effective L5,避免把「系统里有一个循环」误读为「循环已经变强」。
其局限同样具体。L5 的定义在机制层面清晰,但在系统层面会碎片化:同一产品可能包含 L1 数据管线、L2 搜索模块、L4 记忆库和局部 L5 评估器。论文承认分类适用于被检查的 mechanism,却没有给出如何汇总成整体系统等级的可操作协议。HCI 的跨域比较依赖 benchmark family link rule 和 source weighting,17 of 33 的结果可进入轨迹这一事实说明大量报告仍因协议不连续被排除,域前沿可能被这些排除项改变。工业证据虽然丰富,但很多只在 30 个 workspace tasks、547 或 1,280 个 rubrics、600 个 task packages 这类有限样本上测量,尚未证明长期回归和跨组织迁移。医疗与具身场景中的高成本反馈、伦理约束和不可逆性,也让论文中的 RSI roadmap 更像条件性框架,而非统一路线图。
未来最值得跟进的方向,是把 RSI 评估从 single-run benchmark 转向 mechanism audit。系统日志应记录父状态、被改对象、触发证据、acceptance decision、后续调用和独立保护集。对 L3 而言,需要控制 learner-state input 是否冻结,或把 adaptive schedule 替换为固定 schedule,同时匹配交互与计算预算。对 L4 而言,应分别测量 update quality、activation、faithful use 和 downstream benefit,避免把 harness 更新收益误认为任务解决收益。对 L5 而言,真正有说服力的实验必须证明 revised improver 或 revised evaluator 在 fresh domains 上仍以更低总成本产生更强后继,并暴露其失败时的 rollback 边界。论文最终想说明的是:如果每一代 AI 不能把更可靠的诊断、经验和机制继承下去,所谓 recursive self-improvement 仍然只是许多不相连的 automation 片段。