
告别 PDF 时代:ARA 协议将科研成果重构为 AI Agent 的“可执行代码包”
The Last Human-Written Paper: Agent-Native Research Artifacts
本文提出了 Agent-Native Research Artifact (ARA) 协议,这是一种旨在替代传统 PDF 论文的、专为 AI Agent 设计的结构化科研存档格式。该方案通过四个核心层(逻辑、代码、探索轨迹、证据)重构论文,在 PaperBench 和 RE-Bench 测试中分别实现了 93.7% 的问答准确率和 64.4% 的复现成功率。
TL;DR
在 AI 逐渐接管科研流程的今天,传统的 PDF 论文正成为科研积累的瓶颈。这篇由斯坦福、密歇根大学等数十家机构联合发表的重磅论文宣告了“人类手写论文”的时代可能终结。他们提出了 Agent-Native Research Artifact (ARA) 协议,将论文从“一段叙事文本”重构为“一个结构化的 Agent 任务包”,让 AI 对科研成果的理解准确率飙升至 93.7%。
痛点深挖:科研中的“叙事税”与“工程税”
科学论文本质上是对分支、迭代的科研过程进行的有损压缩。
- 叙事税 (Storytelling Tax):为了向人类读者讲好一个故事,研究者被迫删除所有失败的实验、错误的假设和走过的弯路。然而,当 AI Agent 接手后续研究时,这些“负面知识”至关重要——由于缺乏关于失败的记录, Agent 会花费 90% 的算力去重复前人已经踩过的坑。
- 工程税 (Engineering Tax):论文中“足以说服审稿人”的描述与“足以让 Agent 执行”的规范之间存在巨大鸿沟。数据模型显示,仅有 45.4% 的科研复现需求在 PDF 中得到了完全覆盖。
ARA 协议:专为 Agent 打造的“四层架构”
作者认为,科研产出的核心应该是“知识”而非“叙事”。ARA 协议将科研产物拆解为四个相互关联的层(如下图所示):
- 逻辑层 (/logic):定义问题、核心洞见及伪代码,将文学性的描述转化为 Agent 可直接解析的断言。
- 物理层 (/src):不仅包含代码,还通过 Kernel 模式剔除冗余,保留最纯粹的算法内核,让 AI 能够针对不同环境自动生成脚手架。
- 轨迹层 (/trace):这是 ARA 的精髓,它保存了科研过程中的探索有向无环图 (DAG),详细记录了每一个
dead_end(死胡同),帮助后来的 Agent 避坑。 - 证据层 (/evidence):直接绑定原始实验日志和数据,任何 Claim(主张)都有据可查。
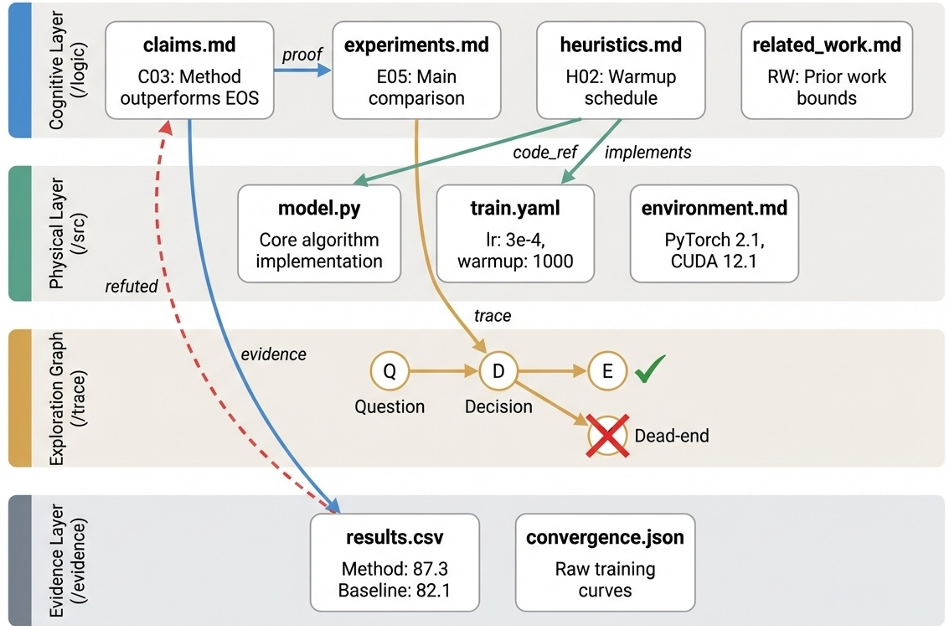 图 1:ARA 真实的跨层结构,显示了从逻辑主张到代码实现及原始证据的取证绑定 (Forensic Bindings)。
为何 ARA 能够落地?
过去类似的“结构化科研”尝试(如 Nanopublications)都宣告失败,原因在于给研究者增加了繁重的额外文档负担。
ARA 的突破点在于 Live Research Manager。在当前的 AI 原生科研模式下,研究员本就在与 Agent(如 Claude, Copilot)对话协作。Manager 作为一个背景技能,会自动从这些对话流中捕获决策过程,将零散的灵感和失败记录“结晶化”为 ARA 格式。文档变成了科研的副产品,而非负担。
实验战绩:全方位碾压传统模式
在面对 PaperBench 的复现挑战时,ARA 表现出了显著的韧性(如下图):
- 知识提取准确率:从 72.4% 提升至 93.7%。
- 科研复现能力:成功率从 57.4% 提升至 64.4%。
- 复杂任务加成:子任务越难,ARA 的优势越高。在涉及多步训练和复杂超参交互的部分,ARA 的结构化优势几乎翻倍。
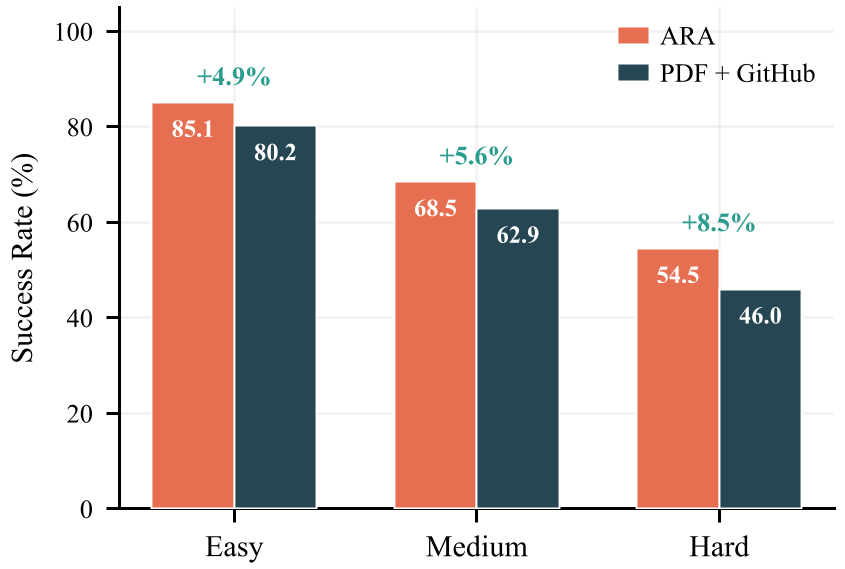 图 2:ARA 相比 PDF 基础线在不同难度任务下的复现成功率对比,可见其在 Hard 难度下提升显著。
深度洞察:科研的 CI/CD 时代已来
本论文最令人振奋的预见是 ARA 原生审稿系统。如果论文是结构化的,那么“代码能否运行”、“结论是否与图表矛盾”等机械性核查完全可以自动化,就像代码的 CI/CD。
人类专家的精力将被解放出来,去关注最需要人类直觉(Taste)的地方:这项工作的科学价值是什么?它是否新颖?它是否有意义?
总结与局限
ARA 协议目前更多聚焦于机器学习领域,对于那些涉及现实世界干预(如湿实验室生物实验)的学科,如何数字化捕获其物理执行层仍是挑战。
然而,这篇文章指明了一个不可逆的方向:在 (Human+AI)² 的科研网络中,科研贡献将以 “可执行的 Diff” 进行沉淀。如果你是一个研究者,现在就开始考虑如何记录你的 dead_ends,因为那是你留给未来 AI 助手最珍贵的财富。