
《LatentAudit:把 RAG 可信性检测从黑盒 Judge 变成白盒几何审计,还顺手接上了零知识验证》
LatentAudit: Real-Time White-Box Faithfulness Monitoring for Retrieval-Augmented Generation with Verifiable Deployment
本文研究的是 RAG 场景下的实时 faithfulness 监控问题,提出了一个白盒监控器 LatentAudit:直接读取开放权重 LLM 的中后层 residual stream 激活,并用 Mahalanobis distance 衡量答案潜表示与检索证据表示的偏离程度。该方法不依赖 auxiliary judge model,在 PubMedQA 上配合 Llama-3-8B 达到 0.942 AUROC、仅 0.77 ms 额外开销,并进一步支持可验证部署。
核心速览
TL;DR
RAG 确实能降低 hallucination,但它从来不保证“生成答案一定被检索证据支持”。这篇论文提出 LatentAudit:不再调用外部 judge model,也不做多次采样,而是直接读取开放权重 LLM 中后层 residual stream 的激活,把“答案潜表示”和“证据潜表示”之间的偏离程度用 Mahalanobis distance 度量出来。
这件事的关键不在于又造了一个 detector,而在于作者证明:faithfulness 其实是可以从模型内部几何结构中在线读出来的。在 Llama-3-8B / PubMedQA 上,它达到 0.942 AUROC,额外开销仅 0.77 ms;如果需要公开可验证部署,同一条二次型判别规则还能被编译进 Groth16 电路,在 16-bit fixed-point 下保留 99.8% 的 FP16 AUROC。
背景定位
这篇工作不是纯刷榜,也不是纯理论论文。它更像是一个很典型的“机制解释 → 系统原语”转化案例:
- 在 mechanistic interpretability 领域,大家早就怀疑 residual stream 里藏着 factuality / truthfulness 信号;
- 但此前这些发现大多停留在解释、编辑或 probe 层面;
- LatentAudit 的贡献,是把这个信号变成一个可实时运行、可跨模型泛化、还可做 zk 验证的部署级组件。
如果说 GPT-4o Judge 代表的是“把验证外包给更强模型”,那么 LatentAudit 代表的是另一条路线:让生成模型对自己的内部状态负责。
痛点与动机
现有方案为什么不理想?
RAG 部署中的真正难题,不是“如何检索”,而是“检索回来以后,模型到底有没有老老实实依据这些证据说话”。
主流方案大致分成三类:
- LLM-as-a-Judge:把问题、证据和答案再喂给一个更强的模型,让它判断是否 supported。
- Self-consistency / SelfCheckGPT:多次采样,看答案是否自洽。
- 外部分类器 / NLI detector:对答案和证据做文本级 entailment 判断。
这些方案有三个共同短板:
- 慢:要多一次甚至多次 forward pass。
- 贵:尤其调用外部 API 时,每 query 成本不可忽略。
- 不私密:如果上下文是医疗、法律、金融数据,发给外部 judge 本身就是风险。
更关键的是,它们都把生成器当作黑盒。可问题恰恰在于:RAG faithfulness 是一个“生成过程内部是否仍受证据约束”的问题。你只在输出文本上做事后验尸,往往已经太晚了。
为什么作者认为内部状态会有信号?
论文的核心直觉来自已有 mechanistic interpretability 工作:
- factual knowledge 往往在 transformer 的中后层 MLP / residual updates 里被编码;
- 即便最终输出 token 错了,内部状态中仍然可能保留 truthfulness 线索。
作者进一步把这个观察推进了一步:
如果答案真的是被检索证据支撑的,那么答案 token 在生成时所走过的 residual trajectory,应该和证据诱导出的表示几何结构保持一致;反之,如果模型开始“自由发挥”,它的答案状态就会从这个局部 manifold 上漂出去。
这就是 LatentAudit 的建模原点:faithfulness 不是纯文本现象,而是 latent geometry 现象。
方法论详解
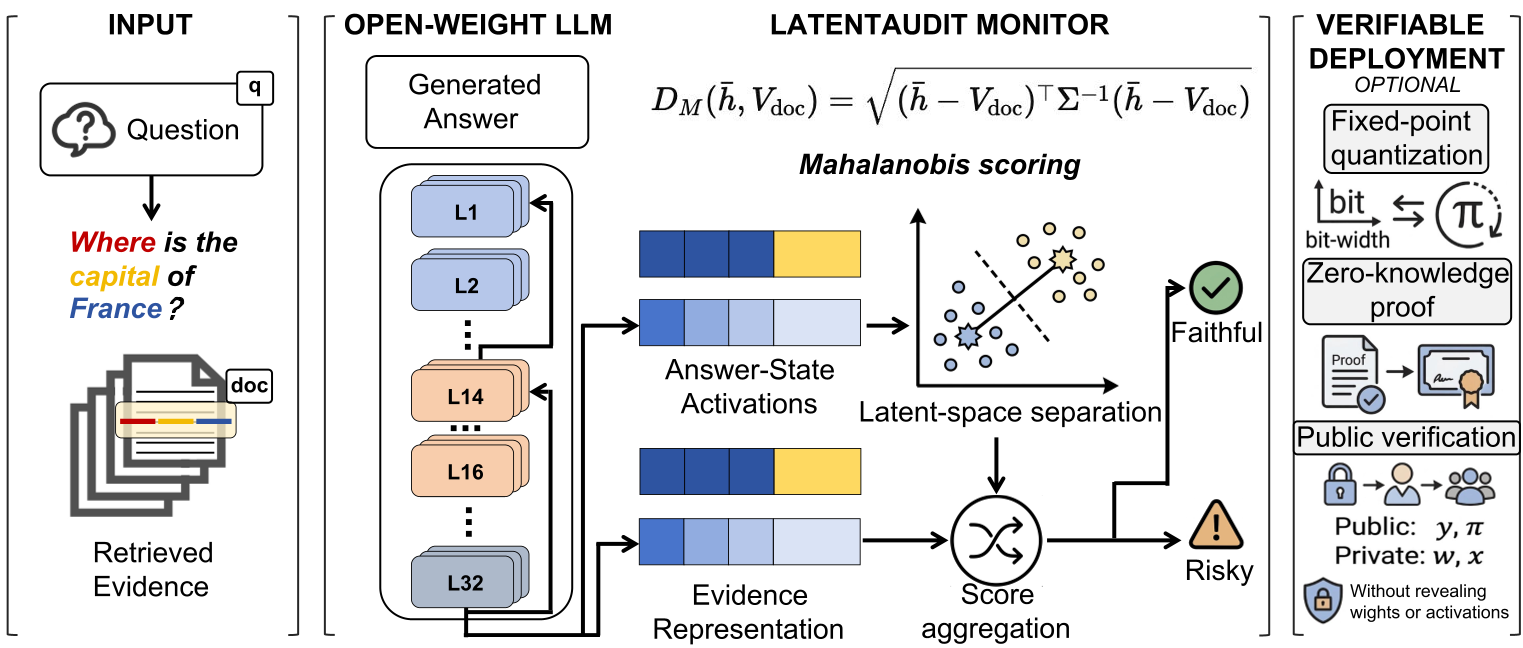
一、整体框架:答案状态 vs 证据状态
LatentAudit 包含两层:
- 运行时监控层:从生成器中抽取答案状态,和证据表示比对,实时输出 faithful / risky。
- 可验证部署层:把这个判别规则量化后放进 zk 电路,允许第三方验证“这个审计结果确实按规则算出来了”。
最重要的是第一层,整个规则非常简单:
-
从 LLM 中后层抽取答案 span 的 hidden states;
-
将若干 salient answer tokens 做 mean-pooling,得到一个固定维度的答案向量
Vact; -
用 frozen dense retriever 得到证据 embedding,再通过一个轻量 affine projector
Wproj对齐到 residual stream 维度,得到Vdoc; -
计算二者的 Mahalanobis distance:
DM(Vact, Vdoc) = sqrt((Vact - Vdoc)^T Σ^-1 (Vact - Vdoc)) -
如果
DM > τ*,判为 potentially unfaithful。
为什么是中后层 residual stream?
这不是随意拍脑袋选层。
作者引用的直觉是:
- 早层更偏词法和句法加工;
- 中层到中后层开始整合语义和证据;
- 最后输出前,表示会朝 vocabulary projection 方向“塌缩”,有用几何结构反而可能被压扁。
因此,最适合读 faithfulness 信号的,不是最后一个 logits,而是接近输出头、但尚未完全 collapse 的中后层残差表示。
论文的 layer sweep 结果也支持这一点:对 Llama-3-8B 来说,最佳区间集中在 layers 14–16。
为什么要对答案 token 做 pooling?
如果直接拿最后一个 token 的 hidden state,会非常不稳定。原因很简单:
- 最后 token 受局部句法与 EOS 行为影响很大;
- 单 token 表示方差高,不足以代表整段答案;
- hallucination 往往不是一个词崩掉,而是整个答案 span 与证据逐渐失配。
所以作者选择:
- 先用 TF-IDF 从答案中挑出 top-k salient tokens;
- 再对这些 token 的激活做 mean-pooling。
这个设计背后的直觉是:用一个“答案语义质心”替代局部 token 噪声。
论文消融也很清楚:
- last-token:0.884 AUROC
- max-pooling:0.912 AUROC
- top-8 mean-pooling:0.942 AUROC
这说明“答案质心”确实比“答案某一点”更稳。
为什么是 Mahalanobis distance,而不是 cosine / Euclidean?
这是全文最有技术含量的地方。
作者认为高维 LLM 表示空间是明显 anisotropic 的:
- 某些方向方差极大,天然会有较大波动;
- 某些方向方差很小,一旦偏离往往更有语义意义。
如果用 Euclidean distance,所有方向一视同仁,就会把“本来很正常的大方差摆动”和“异常的小方差偏移”混在一起。
Mahalanobis distance 本质上是在做:
- 沿高方差方向,少惩罚;
- 沿低方差方向,多惩罚。
而作者的建模假设正是:
unsupported generation 往往不是简单地在语义上“离题万里”,它可能仍与证据 topic 相近,但会沿着那些 grounded completion 很少走的低方差方向漂移。
这也是为什么论文特别强调:有些错误答案在 raw cosine space 里看起来仍然很近,但在 Mahalanobis 度量下会被拉开。
证据表示如何对齐到 residual space?
这里有一个容易被忽视但很关键的工程点。
证据表示 Vdoc 来自外部 retriever(all-MiniLM-L6-v2),而答案状态 Vact 在 LLM residual stream 中。这两个空间天然不一致,必须对齐。
作者没有训练一个复杂神经网络去做 alignment,而是只在 10% calibration split 上拟合一个非常轻量的 ridge regression affine projector。
这一步看似朴素,实则非常重要:
- 如果 projector 太强,比如 2-layer MLP,就可能偷偷学成一个小 judge model;
- 那就违背了论文“零训练、可解释、可验证”的初衷。
论文附录中的对比很说明问题:
- No projection:0.648 Eval AUROC
- PCA:0.778
- CCA:0.885
- Ridge Regression:0.942
- 2-layer MLP:Train 0.991 / Eval 0.945
MLP 虽然 eval 略高,但明显存在过拟合风险;Ridge 在小样本下更稳,更符合“几何对齐”而非“判别器学习”的定位。
为什么这套规则适合做 zk 验证?
因为最终决策就是一个二次型不等式:
- 先算
X = Vact - Vdoc - 再检查
X Σ^-1 X^T ≤ τ*²
这是一个非常规整的代数约束,可以量化到有限域里,编译到 Groth16 / EZKL 电路中。和“把整个 Transformer 推理过程都做成 zkML”相比,这个成本低太多了。
作者的策略非常现实:
- 不去证明 LLM 本身推理正确;
- 只证明“审计分数是按公开规则正确计算的”。
这是一种非常系统工程导向的 trade-off:证明小规则,而不是证明大模型。
实验与结果
一、主结果:接近 GPT-4o Judge,但开销低三个数量级
先看最核心的表格。
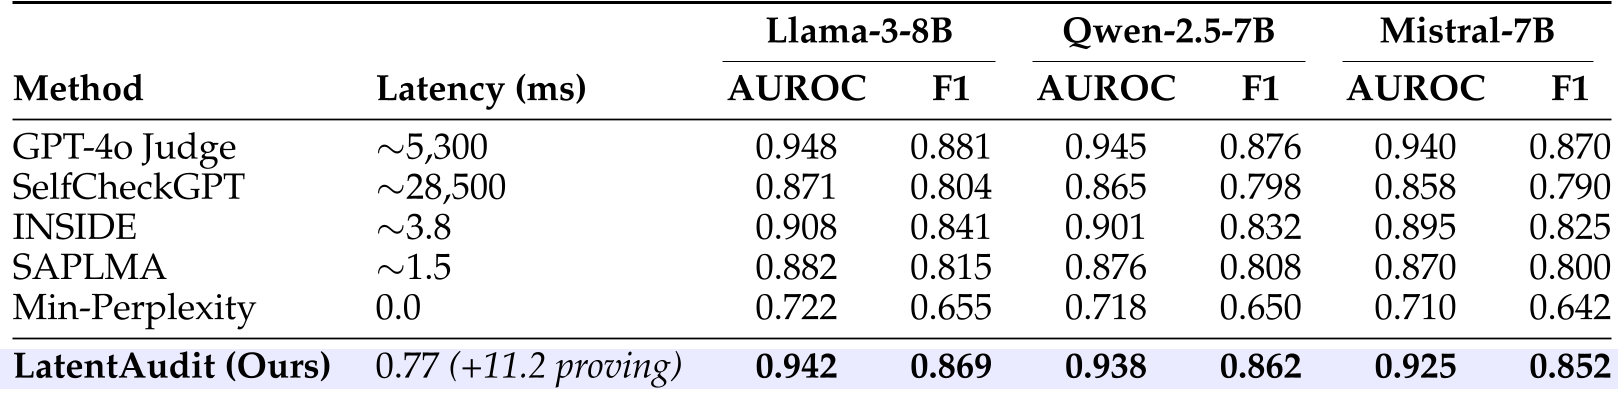
在 PubMedQA / Llama-3-8B 上:
- GPT-4o Judge:AUROC 0.948,F1 0.881,延迟约 5300 ms
- SelfCheckGPT:AUROC 0.871,延迟约 28500 ms
- INSIDE:AUROC 0.908,延迟约 3.8 ms
- SAPLMA:AUROC 0.882,延迟约 1.5 ms
- LatentAudit:AUROC 0.942,F1 0.869,延迟 0.77 ms
这里最值得注意的不是“比 GPT-4o 差一点点”,而是:
- 与 GPT-4o Judge 的 AUROC 差距仅 0.006
- 延迟却从秒级降到 亚毫秒级
- 相对 INSIDE 提升 3.4 个 AUROC 点
- 相对 SAPLMA 提升 6.0 个 AUROC 点
这说明 LatentAudit 不是“便宜但一般”,而是非常接近高质量黑盒 judge 的效果。
为什么 LatentAudit 比其他 hidden-state 方法更强?
INSIDE 和 SAPLMA 其实也读 hidden states,但它们的问题分别是:
- INSIDE:更依赖 hidden-state 的谱统计特征,没有显式把“答案”和“证据”做配对比较。
- SAPLMA:本质是线性 probe,遇到 anisotropic 表示空间时表达能力不足。
LatentAudit 的本质改进在于两点:
- 它不是只看“答案状态像不像 hallucination”,而是直接问“答案状态和证据状态对不对齐”;
- 它用 Mahalanobis metric 把 covariance structure 纳入了距离定义。
前者让检测更 evidence-sensitive,后者让检测更适应高维各向异性表示。
二、信号出现在哪里:中后层确实最可分
论文的 Figure 2 直接展示了 layer sweep 和可视化分布。
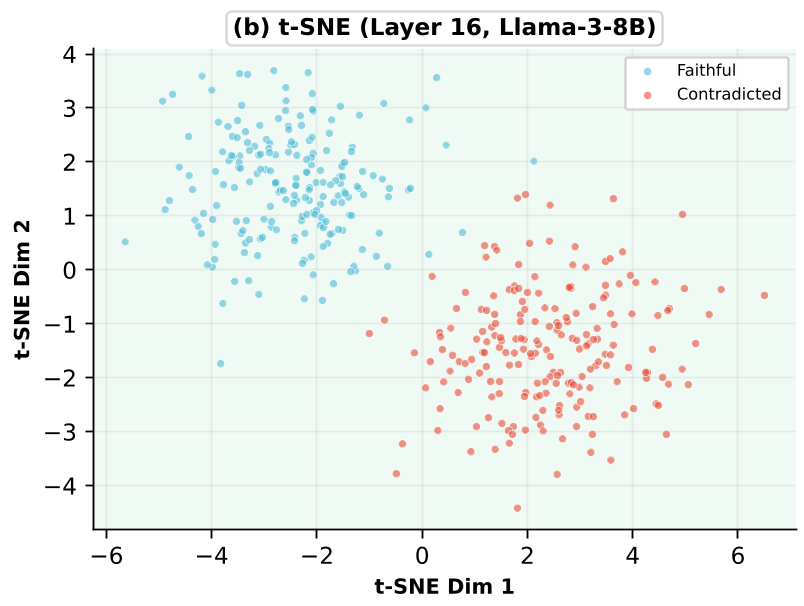
从图中可以看到:
- 区分 faithful / contradicted 的能力在中后层明显跃升;
- 到选定层附近,t-SNE 投影已经能把两类样本较清晰地分开。
这很重要,因为它把方法从“经验技巧”推向了“机制一致”:
- 不是任何层都能用;
- 最优层位置与 factual recall 文献的结论一致;
- faithfulness 信号并不是输出层临时现编出来的,而是 residual stream 中已经形成的结构。
三、跨模型、跨数据集稳定性
论文在五个模型家族、三个 QA benchmark 上做了评测。
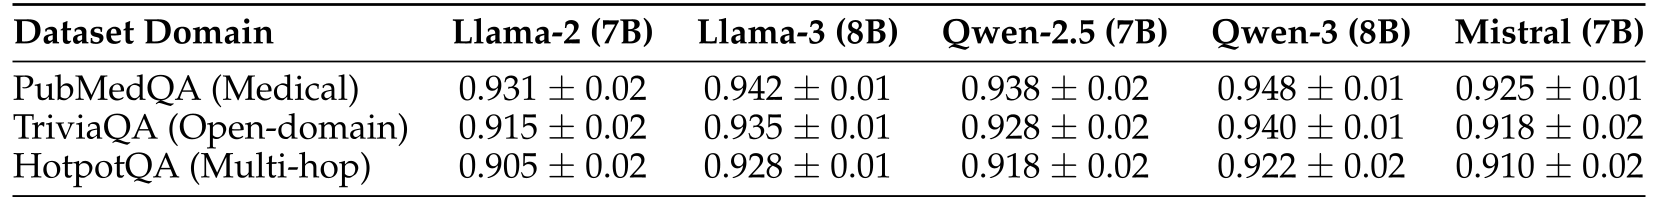
主要结果:
- PubMedQA:0.925–0.948
- TriviaQA:0.915–0.940
- HotpotQA:0.905–0.928
两个结论很清楚:
- 这个几何信号不是某个 backbone 的特例,Llama-2/3、Qwen-2.5/3、Mistral 都能工作。
- HotpotQA 明显更难,说明多跳推理下 faithfulness 监测仍有挑战。
这也提示我们:LatentAudit 更擅长“证据支持关系相对直接”的任务,在 multi-hop、短答案、稀疏 supporting spans 场景中信号会变弱。
四、真正有价值的实验:四类 retrieval stress test
我认为全文最有说服力的实验不是主表,而是 stress test。
现实中的 RAG 错误不是只有 contradiction。作者构建了四类样本:
- faithful
- contradicted
- retrieval miss
- unsupported partial
其中最难的是 partial support:上下文和答案 topic 很接近,但证据其实不够完整,文本层面非常容易误判。
结果如下:
- PubMedQA:AUROC 0.9566–0.9815
- HotpotQA:AUROC 0.9142–0.9315
更细粒度地看 pairwise 区分:
- faithful vs contradiction:几乎接近满分
- faithful vs retrieval miss:也很强
- faithful vs partial support:最难,但仍有可用区分力
这说明 LatentAudit 检测到的不是简单的 contradiction 模式,而是真正某种“证据耦合程度”。
错误模式是什么?
论文错误分析给出的模式非常合理:
- False Positive 常出现在 partial support:上下文词面上高度重合,但缺少关键证据细节。
- False Negative 常出现在 retrieval margin 很薄的 faithful 样本,或 HotpotQA 的单 token 短答案。
这说明方法失败的主因不是“看不懂矛盾”,而是“支持证据太薄弱,答案状态质心不稳定”。这是很有价值的诊断,因为它指向了未来改进方向:不是再换更强 classifier,而是要更好地建模 supporting span 粒度与短答案表征。
五、校准样本需求不高,且有一定 OOD 迁移
作者只用 10% calibration split(200 个样本)来估计协方差和阈值,已经能达到主结果。附录还表明:
- 50 个样本:Eval AUROC 0.912
- 100 个样本:0.931
- 200 个样本:0.942
- 500 个样本:0.943
这表明方法对校准数据非常 sample-efficient。
此外,做 cross-domain threshold reuse 时:
- PubMedQA → HotpotQA:0.942 降到 0.916
- HotpotQA → PubMedQA:0.928 降到 0.902
掉点 2–3 个 AUROC 左右,不算小,但对很多实际部署已经是可接受的。这意味着 latent faithfulness signal 有一定 domain transfer,但还不是彻底 domain-invariant。
六、验证层代价:16-bit 是最优折中
论文在 zk 层的一个核心问题是量化误差。
表 5 的结论非常直接:
- 8-bit:AUROC 匹配 82.4%,损失太大
- 16-bit:保留 99.8% FP16 AUROC,ZK 时间 11.9 ms,Gas 580K
- 32-bit:几乎无损,但 proving/gas 成本过高
这说明 16-bit fixed-point 是一个非常工程合理的 sweet spot。
更值得称道的是,作者没有把 zk 写成“万能银弹”,而是明确说:
- zk 只证明审计规则算得对;
- 不证明 latent signal 本身一定科学;
- 也不证明检索证据是真的。
这个边界意识很重要。
深度洞察与总结
一、这篇论文真正做对了什么?
我认为 LatentAudit 的核心贡献有三层。
1. 把“truthfulness signal 在 residual stream 里”变成了一个可运行的系统命题
很多 mechanistic interpretability 工作告诉你“模型内部有某种可解释结构”,但离部署还很远。LatentAudit 的厉害之处,是把这个观察压缩成了一个部署规则:
- 一个 pooled latent vector
- 一个 affine alignment
- 一个 Mahalanobis quadratic form
- 一个校准阈值
这种极简性,是它能实时运行、能跨模型、还能进 zk 的根本原因。
2. 它抓住的是“证据耦合几何”,而不是泛化的“像不像幻觉”
很多 hallucination detector 最终学到的只是某些风格信号:
- 语气太肯定
- 词分布异常
- 置信度不稳定
这些信号在 retrieval miss / partial support 下往往失效。LatentAudit 不同,它直接对比答案状态与证据状态是否共处于同一局部几何结构中,因此更贴近 faithfulness 的定义本身。
3. 它选了一个足够小、足够干净的数学对象
如果作者选择训练一个复杂 MLP detector,AUROC 可能也不差,但就失去三样关键属性:
- 可解释性
- 小样本校准性
- 可验证性
Mahalanobis rule 的优点不是“最深”,而是“刚刚好”。这点在学术上经常被低估,但在系统落地里极其重要。
二、局限性在哪里?
这篇论文也有几个非常明确的限制。
1. 必须是 open-weight / white-box 模型
LatentAudit 需要读 hidden states,所以不能直接审计 GPT-4 这类纯黑盒 API。作者提到可以用 surrogate open-weight model 审计黑盒输出,但那已经不是同一个问题了,信号是否保持仍需验证。
2. 它审计的是“是否忠于检索证据”,不是“证据本身是否为真”
这是 RAG faithfulness 和 factual correctness 的经典区别。
如果检索库被污染、文档本身就是错的,那么 LatentAudit 仍然可能给出“faithful”结论。也就是说,它只能保证“模型没胡编”,不能保证“知识库没撒谎”。
3. 对 partial support 和短答案仍然脆弱
这其实是最实在的限制。单 token 或超短答案的 pooled state 先天信息不足;partial support 又是最接近真实生产噪声的场景。因此,如果系统经常生成极短回答或面对证据稀疏任务,LatentAudit 的效果可能不如主表那么亮眼。
4. 规模外推还未验证到 frontier models
目前主要实验在 7B/8B 家族。70B+ 模型是否会让 evidence-conditioned manifold 更清晰,还是因表示分工更分散而需要新的 pooling 策略,论文还没有回答。
三、未来值得沿着哪些方向继续做?
我认为至少有四条很自然的延展路线。
-
更细粒度的 latent feature 设计
比如不只读 residual stream,还读特定 attention heads、cross-token interaction、support span 对应子空间。 -
从监控走向干预
如果某一步发现DM超阈值,能否在 decoding 时触发 retrieval refresh、答案重写、或 latent intervention? -
扩展到多模态 RAG
文中已经提到可考虑池化 visual encoder 的 cross-attention states。这条线对医疗影像、文档问答、视频问答都很有意义。 -
更轻的 proof architecture
现在证明的是 Mahalanobis 二次型,已经比全模型 zkML 轻很多;未来若要面向超高吞吐 serving,还需要继续压缩 proving 成本。
总结
LatentAudit 最值得记住的一句话是:
RAG faithfulness 可以不靠外部 judge,而靠模型内部 residual geometry 自我审计。
它的重要性不只在于 0.942 AUROC 或 0.77 ms,而在于提出了一种新范式:
- 从 black-box behavioral checking
- 转向 white-box mechanistic auditing
这条路线的含义非常深远。它意味着未来可信 LLM 系统的监控层,也许不是另一个更大的模型,而是一个小而硬的几何规则;不是更昂贵的“评审员”,而是生成器自身 latent state 的结构一致性检查。
如果你关心高风险 RAG 部署,这篇论文值得重点关注。它没有试图解决所有 hallucination 问题,但它非常精准地解决了一个最关键、最真实、也最难工业化的问题:如何在生成时、低延迟地、可验证地知道这句话到底有没有证据支撑。