潜空间:AI 从“模仿人类说话”到“深思熟虑”的范式飞跃
The Latent Space: Foundation, Evolution, Mechanism, Ability, and Outlook
本文是一篇关于语言模型中潜空间(Latent Space)的综述,系统探讨了潜空间作为继显式 Token 生成之后的“机器原生计算底座”。该研究由新加坡国立大学、复旦、清华等顶尖高校联合发表,提出了统一的“机理-能力”双维分类框架。
TL;DR
如果把 LLM 的显式输出(Token-level Generation)比作人类的“语言表达”,那么**潜空间(Latent Space)**就是 AI 的“大脑内语(Inner Speech)”。这篇来自新加坡国立大学等顶尖机构的万字综述宣告:AI 正在摆脱人类语言逻辑的束缚,转向一种机器原生、连续且高效的潜空间计算范式。
核心速览
本文不仅是第一篇系统性审视大语言模型中潜空间的综述,更是在定义一种新的系统 paradigm。它指出了现有“Token 驱动”推理的三宗罪:冗余性、离散化瓶颈以及多模态语义流失。在这个坐标系中,潜空间不再只是模型内部的隐藏层,而是一个具备推理、感知、记忆甚至动作规划的全能操作平台。
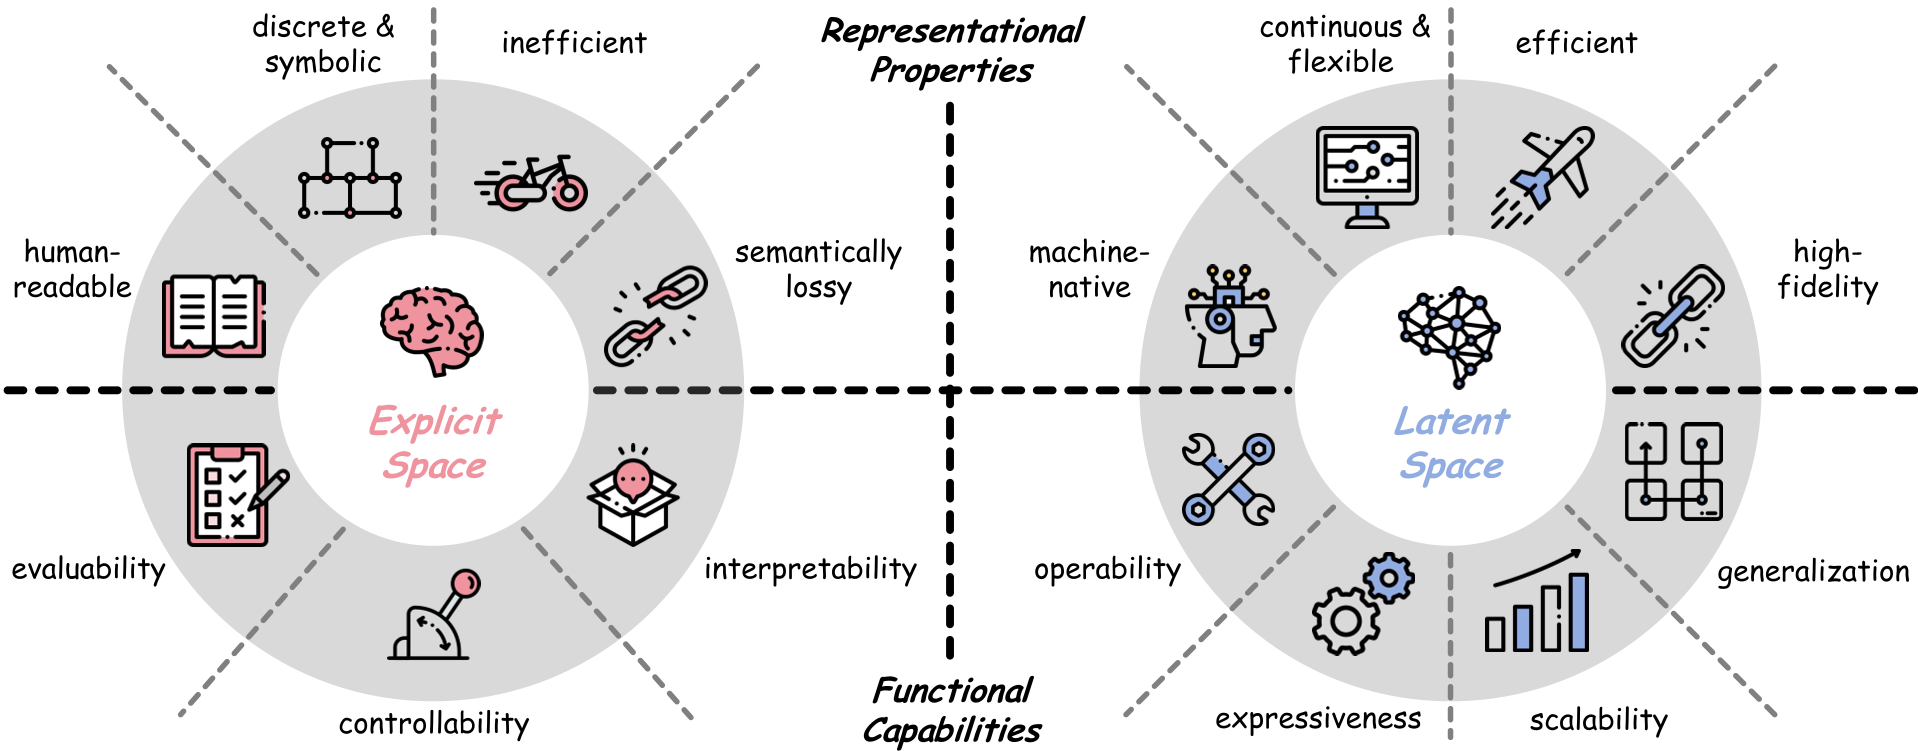
潜空间的崛起:为何“说出来”不如“想出来”?
长期以来,我们通过 Chain-of-Thought (CoT) 来评估 LLM 的推理,但这存在严重的局限性:
- 语言冗余(Linguistic Redundancy):语序和语法占据了大量空间,但逻辑核其实很小。
- 离散瓶颈(Discretization Bottlenecks):每生成一个 Token 都要做全词表概率计算,极其低效。
- 语义流失(Semantic Loss):多模态信息被强行压缩为文字描述时,精细化的空间和时序信息丢失了。
机理拆解:AI 如何在向量里“思考”?
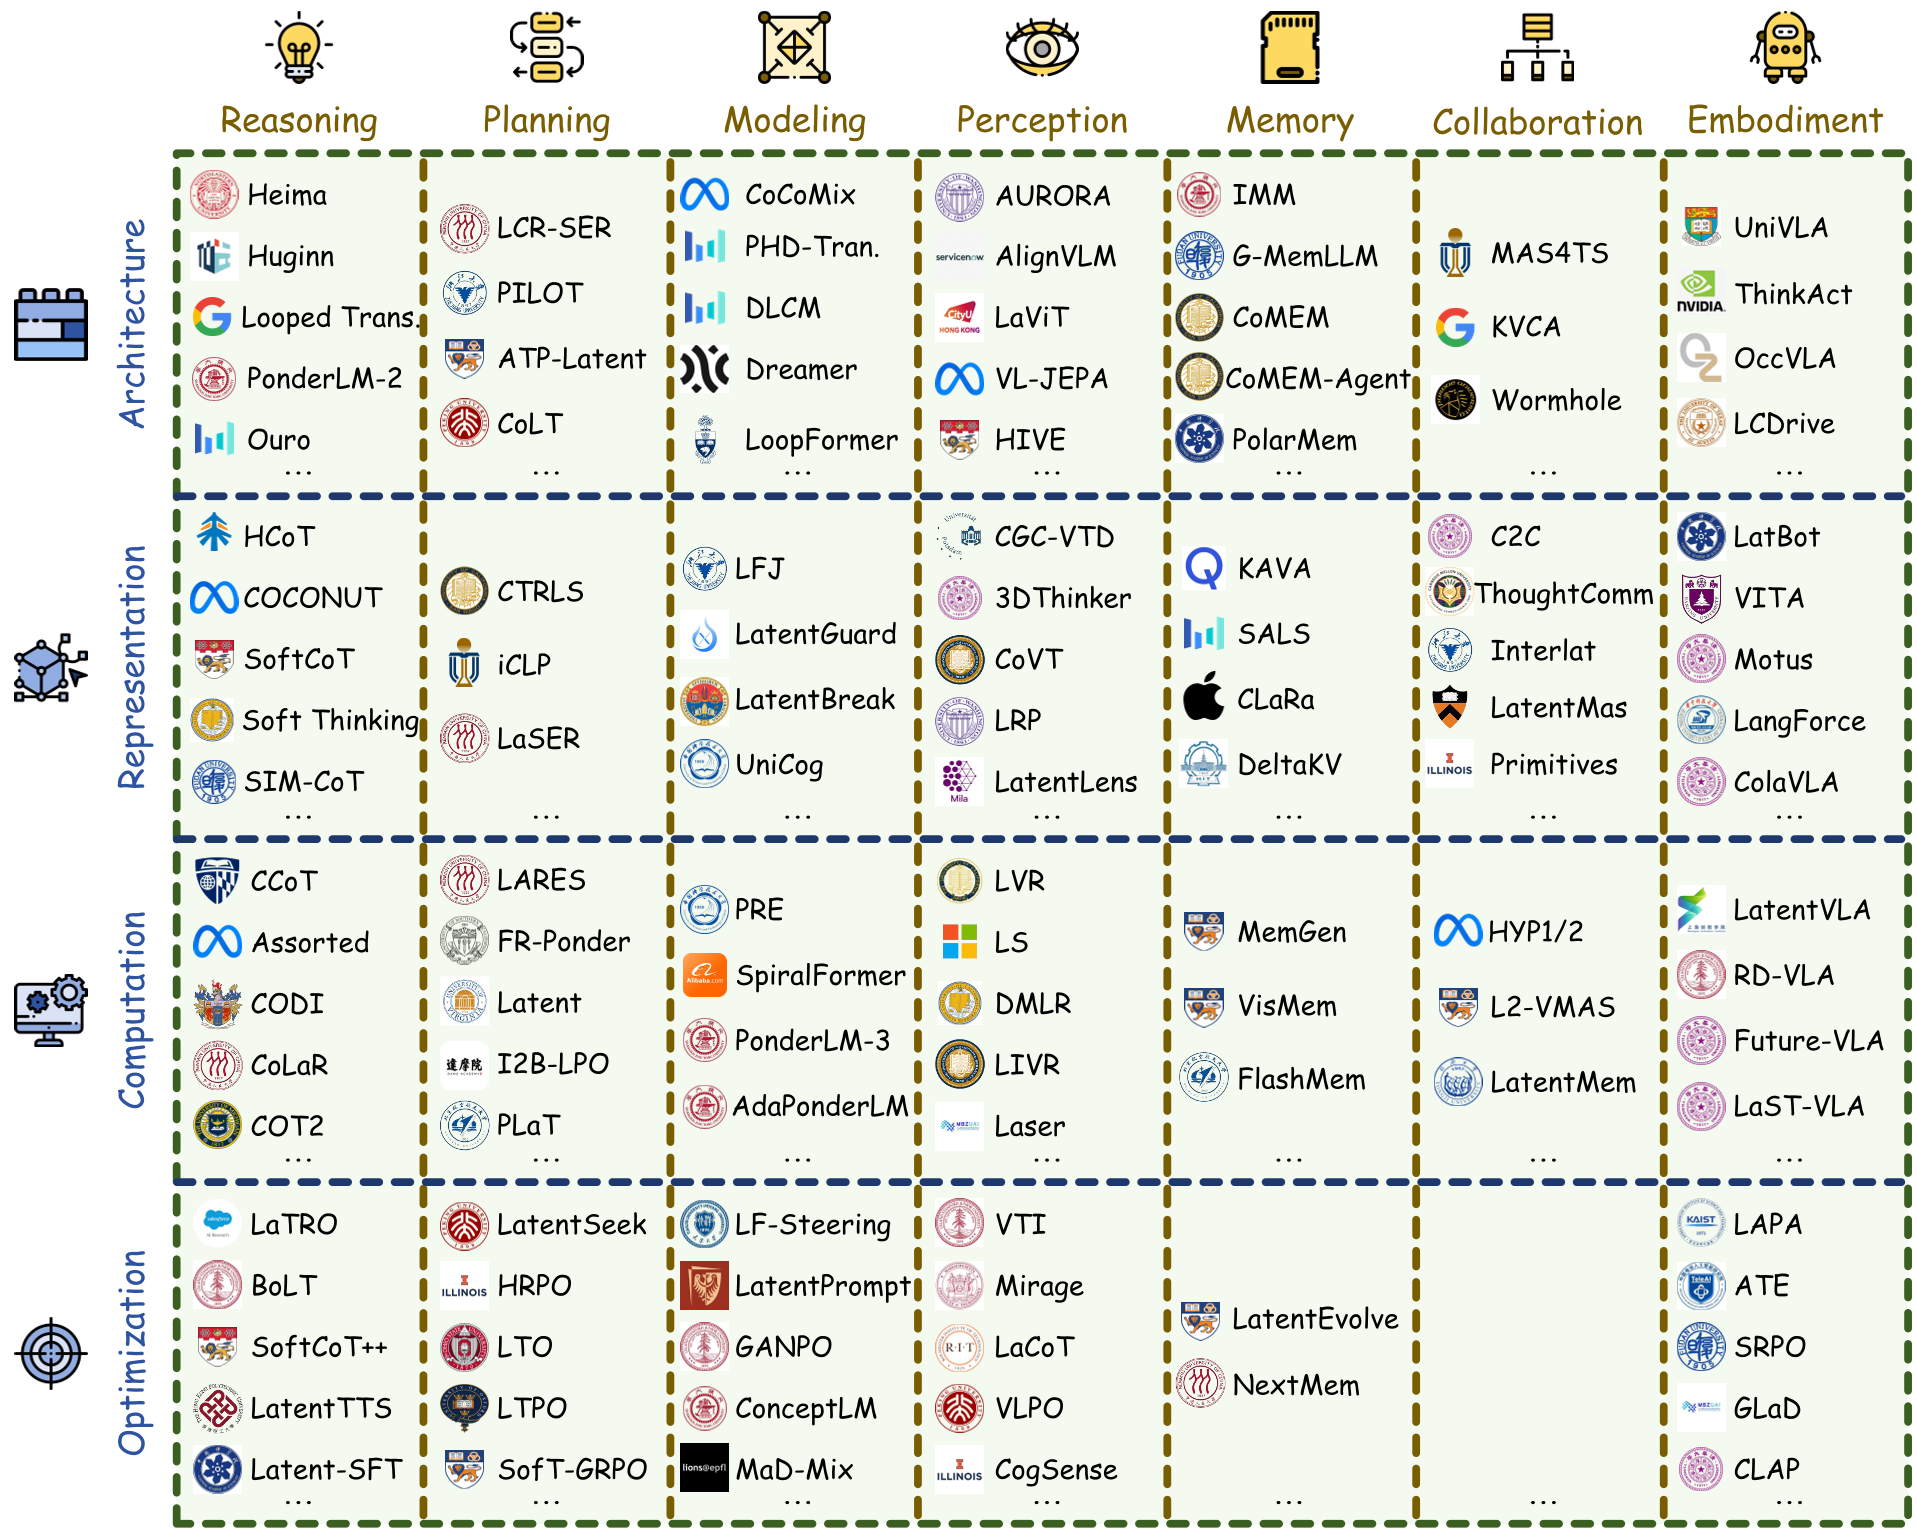
综述将潜空间的构建归纳为四个核心维度:
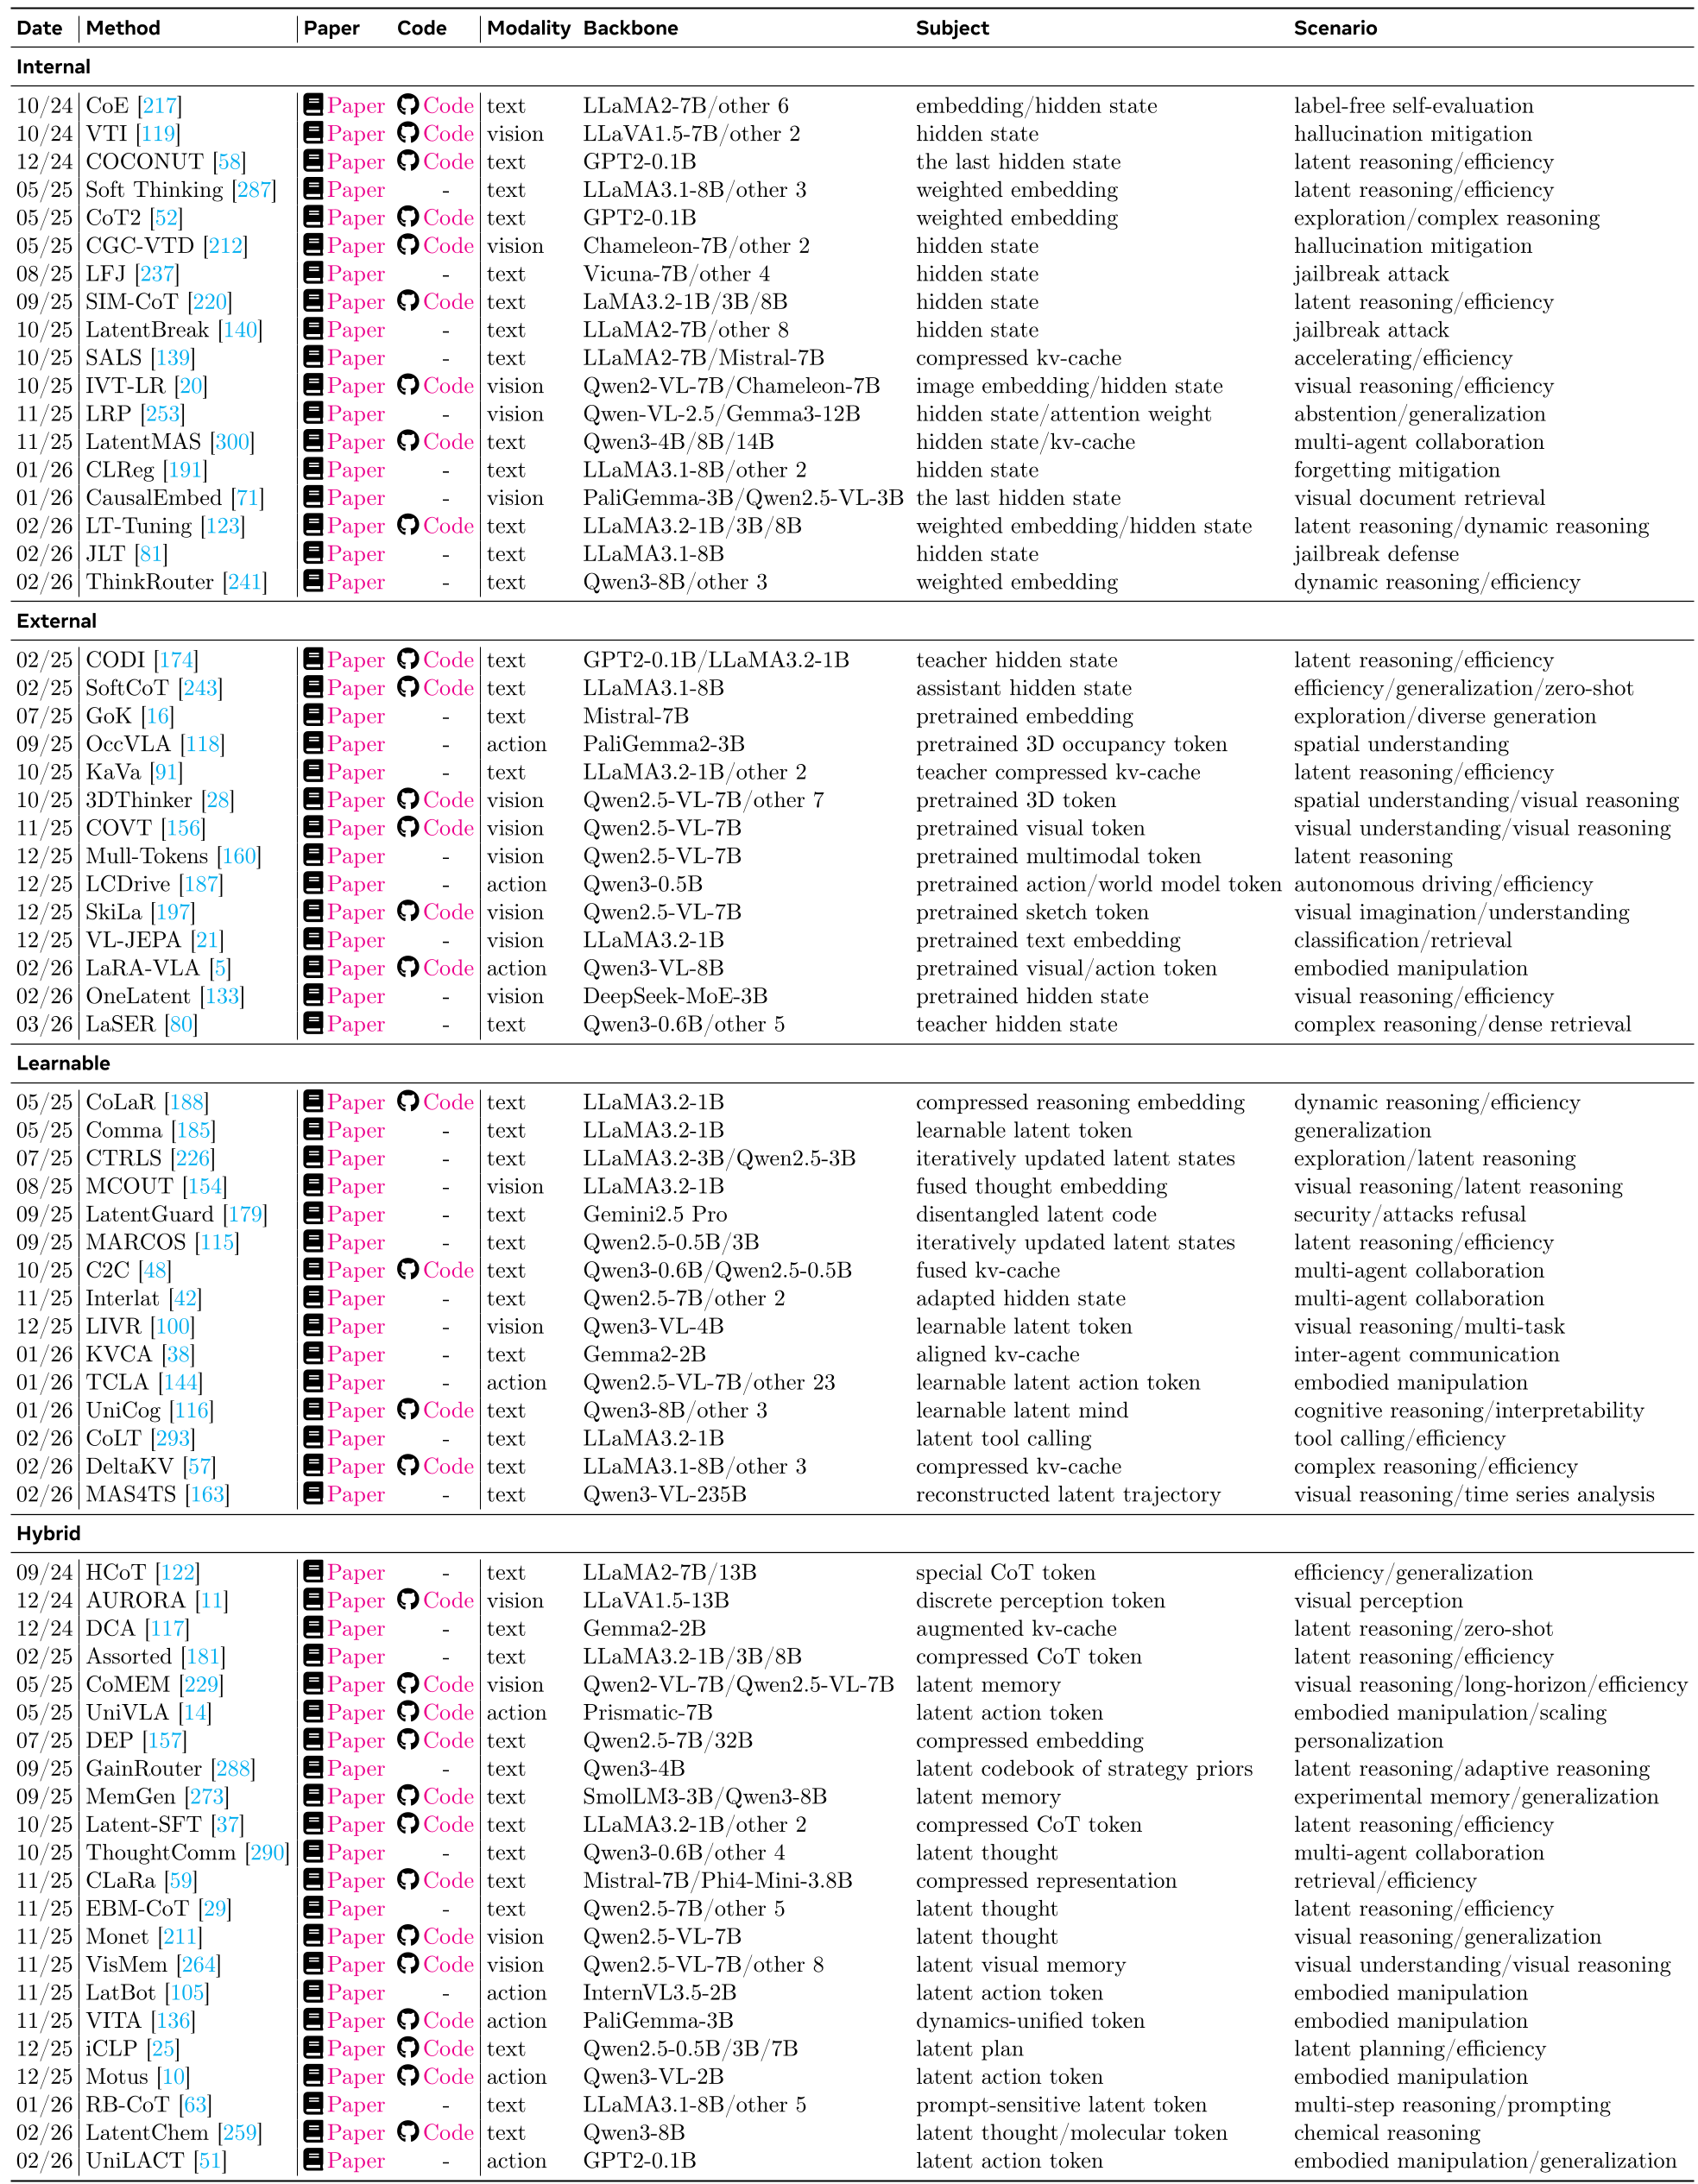
- 架构 (Architecture):从传统的固定层数转向 Looped Transformer 或共享参数的 Recurrent Depth 设计(如 Huginn),让模型可以根据任务难度动态调整“思考深度”。
- 表示 (Representation):不仅使用内部隐藏状态(Internal States),还通过 Learnable Tokens(可学习令牌)或 Hybrid representations(混合表示)将异构信号(如图像纹理、机器人动作轨迹)注入潜空间。
- 计算 (Computation):支持并行分支(Branching Paths)和叠加态推理(Superposition)。这意味着 AI 可以在潜空间里同时“预演”多条路径,而不需要像文字一样非此即彼。
- 优化 (Optimization):引入强化学习(RL)对潜推理路径进行优化,如 Soft-GRPO,让模型自主寻找更高奖励的认知路径。
七大能力:跨越模态与躯体的统一
潜空间彻底释放了 AI 的多项“超能力”:
- 原生感知 (Perception):VL-JEPA 等方法直接在潜空间编码图像,保留了文字无法描述的空间几何结构。
- 连续记忆 (Memory):不再受限于 Context Window,通过潜向量库实现数万步甚至跨任务的长期记忆保留。
- 原生动作 (Embodiment):对于具身智能(VLA),潜空间支持从视频中学习隐动作(Latent Action),绕过了昂贵的人工标注。
资深主编洞察:从“图灵测试”到“机器自主认知”
这篇论文的真正价值在于它回答了 AI 进化的终极方向。目前 LLMs 是在“模仿”人类,因为它们被迫使用人类的语言进行思考。然而,潜空间的成熟意味着:
- 效率将指数级提升:跳过 Token 解码,计算效率提升 3-5 倍。
- “顿悟”的可能:当模型可以在潜空间并行探索并利用梯度优化自身认知时,AI 可能会产生人类无法理解但逻辑自洽的深奥推理。
局限性:当前最大的挑战是可解释性(Interpretability)。潜空间是不可读的黑盒,我们如何监控 AI 是否在“胡思乱想”?如何验证其潜推理的每一步都是合法的?这需要全新的评估工具。
总结
本文为研究者提供了一份详尽的路线图,确立了潜空间作为下一代智能系统的核心位置。从显式生成到隐式计算的迁徙,是 AI 实现具身智能、超长推理和高效演进的必经之路。