
[ACL 2024] 法律推理的“透明化”革命:TL Agent 打造可审计的司法逻辑树
A Law Reasoning Benchmark for LLM with Tree-Organized Structures including Factum Probandum, Evidence and Experiences
本文提出了 TL (Transparent Law Reasoning) 基准测试,旨在通过由事实(Factum Probandum)、证据(Evidence)和人类经验(Experiences)构成的树状结构模型化法律推理过程。核心成果包括首个法律推理众包数据集以及一个集成了多种法律分析工具的 TL Agent 框架,在复杂司法逻辑推演上显著优于 GPT-4o 等通用 LLMs。
TL;DR
法官是如何根据一堆零散的证据判定一个人有罪的?这背后的逻辑往往隐匿在经验与直觉之中。本文提出了 TL (Transparent Law Reasoning) 任务,首次将法律推理过程结构化为包含“事实-证据-经验”的树状模型,并开发了能像顶尖专业律师一样思考的 TL Agent。实验表明,即便使用较小的底座模型,通过法律工具链武装的 Agent 在逻辑严密性上也能吊打 GPT-4o。
背景定位:从“结果预测”到“逻辑溯源”
目前的法律 AI(Legal AI)大多在做“法律应用”——给一段话,预测罪名或刑期。但司法公正的核心在于 Fact-finding(事实发现)。如果 AI 不能解释为什么这个证据能支撑那个事实,那么它永远无法进入真正的“智慧法院”。
本文的地位在于:不仅提出了任务,还填补了数据空白,并给出了一套生产力级的 Agent 解决方案。
痛点深挖:被忽视的“人类经验”
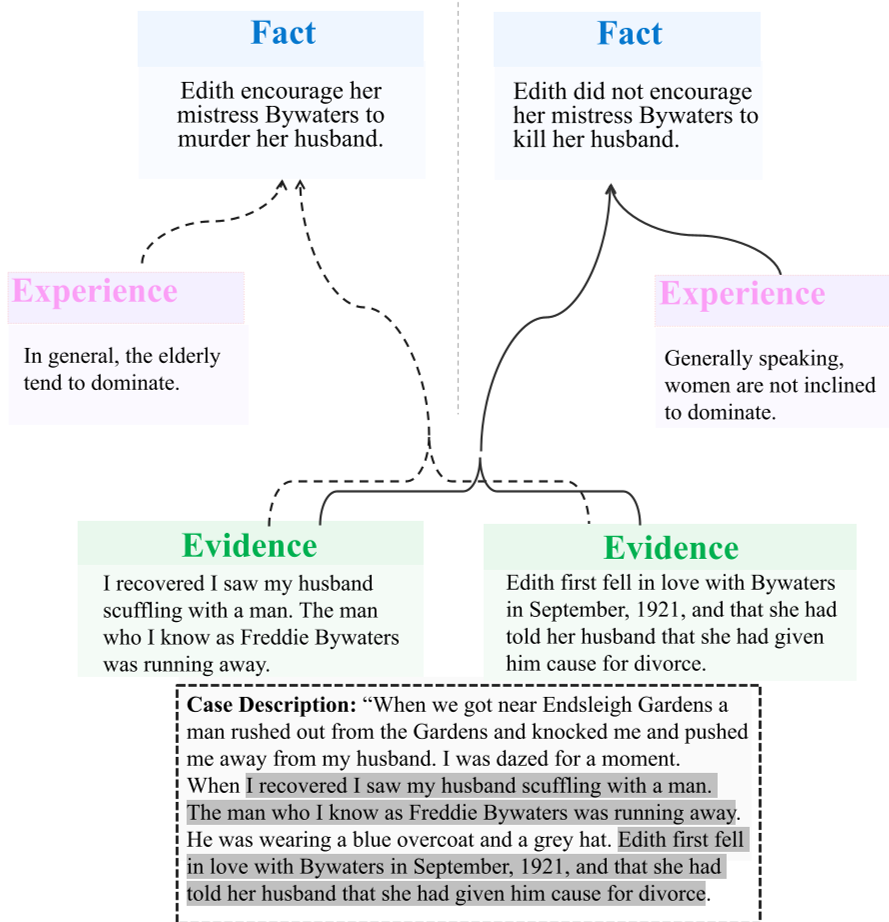
为什么同一个案例,不同人会有不同判断? 作者引用了著名的 Rex v. Bywaters 案(见图 1)。当证据显示一名女性频繁给情人写信时,一种经验认为“年长女性倾向于控制和煽动”,从而判定她教唆杀人;另一种经验则认为“女性更倾向于情感依赖”,判定其无罪。 如果 AI 不把这些隐性经验(Experiences)显性化,司法偏见将永远存在。
核心架构:TL Agent 的“专业头脑”
为了解决法律推理的复杂性,作者没有单纯依靠 Prompt Engineering,而是构建了一个复杂的 TL Agent 工具箱:
1. 结构化 Schema
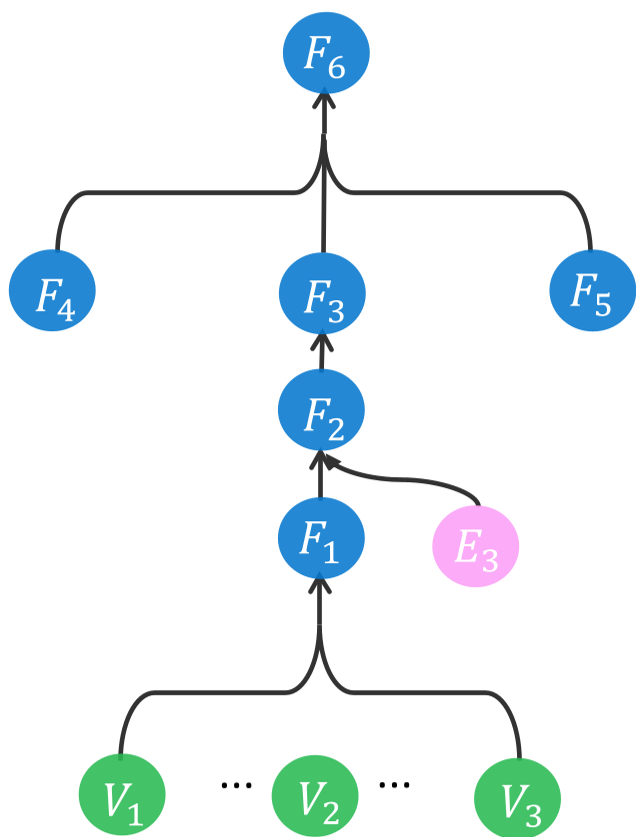
推理过程被严格定义为:证据 (Evidence) -> 中间事实 (Interim Probandum) -> 最终事实 (Ultimate Probandum)。连接这些节点的不仅是逻辑线,还有人类经验 (Experiences)。
2. 核心工具链 (Toolkit)
- Fact Finding Head: 专门负责从非结构化文本中抽取证据和事实节点。
- MultiRole Checker: 模拟法庭辩论。系统会同时扮演律师、检察官和法官,通过多视角投票来检查推理是否存在漏洞。
- Reflection 机制: 在执行每一步后,Agent 都会反思:“基于现有的法律常识,这个证据真的能推导出这个事实吗?”
实验与结果: Agent 协同的力量
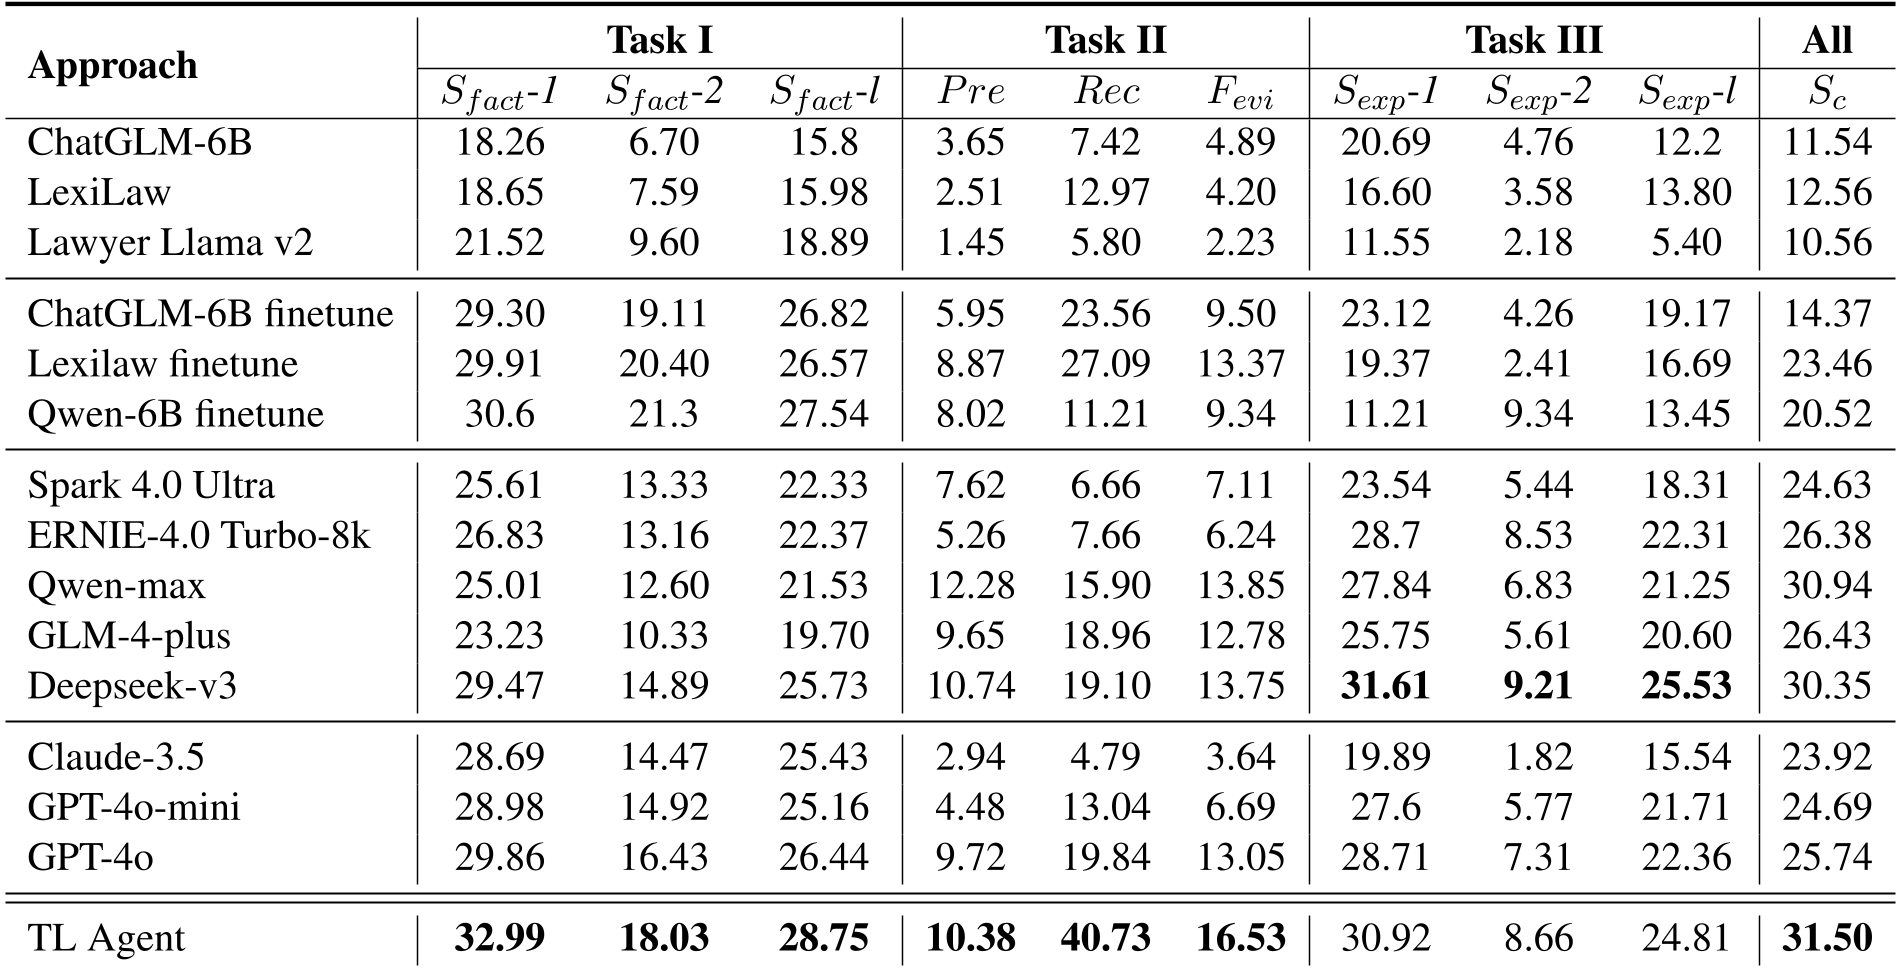
实验结果令人振奋。在包含 453 个真实案例、623 万 Token 的 TL 数据集上,TL Agent 展示了压倒性的优势。
SOTA 对比
在 Evidence Reasoning (Task II) 中,不仅要求找到证据,还要建立正确的关联。TL Agent 的召回率达到了 40.73%,而传统的 LLMs(如 GPT-4o)在没有工具辅助时,这一数值仅为 19.84%。
深度洞察:
- 参数量不是唯一:经过 TL 数据集微调的 6B 模型,在某些特定指标上甚至能和闭源 LLM 扳手腕。
- 经验是最难的环:实验发现 Task III(经验生成)对常识要求极高,这证明了混合法律专业知识与 Agent 通用常识的必要性。
总结与展望 (Takeaway)
这篇论文标志着 Legal AI 进入了“白盒时代”。通过将复杂的 Wigmore 推理图谱转化为机器可处理的树形结构,TL Agent 为未来的“透明司法”奠定了基础。
局限性:虽然逻辑很美,但在处理极端复杂、证据互相矛盾的案例时,Agent 仍可能出现幻觉。此外,如何将这套系统与现有的庭审系统进行端到端集成,仍是未来的挑战。
一句话总结:如果你想让 AI 处理法律,千万别只把它当语言模型,要把它当成一个“携带专业工具的法律专家”。