
NP-Edit:摆脱配对数据枷锁,用 VLM 梯度教扩散模型做编辑
Learning an Image Editing Model without Image Editing Pairs
本文提出了 NP-Edit (No-Pair Edit),一种无需成对训练数据(Image-Editing Pairs)的新型图像编辑模型训练范式。通过结合多模态大模型(VLM)的可微反馈与分布匹配蒸馏(DMD),该方法在 Few-step(如 4 步)采样设置下达到了 SOTA 水平。
TL;DR
Adobe Research 与 CMU 的学者们提出了一种全新的图像编辑训练范式 NP-Edit。它彻底抛弃了对“编辑前-编辑后”图像对(Paired Data)的依赖,转而向多模态大模型(VLM)“借力”。通过将 VLM 的反馈转化为可微损失函数,并配合分布匹配蒸馏(DMD),NP-Edit 在极简的 4 步采样 下便能实现高质量、高指令遵循度的图像编辑,性能直逼甚至超越了使用海量监督数据训练的重型模型。
背景定位:配对数据的“围城”
在 AI 绘画领域,Text-to-Image 已经非常成熟,但精准的 图像编辑 (Image Editing) 依然是一个难点。
- 痛点:由于很难从互联网上直接爬取到大规模的“修改前后”对比图,目前主流做法是利用合成数据 (Synthetic Data),但这会导致模型反复学习由于合成瑕疵产生的伪影。
- 现状:现有的强化学习(RL)方法(如 Flow-GRPO)虽然能利用 VLM 作为奖励模型,但通常需要一个监督微调(SFT)阶段作为起点,这又回到了对配对数据的依赖。
核心直觉:让 VLM 成为可微的“导师”
作者的 Insight 在于:与其让 VLM 作为一个黑盒给出评分(Scalar Reward),不如利用 VLM 的推理能力直接对生成结果进行结构化提问(如:“图中的狗被移除了吗?”),并将预测概率通过反向传播指导扩散模型。
1. 训练方案设计
为了解决扩散模型中间状态模糊的问题,NP-Edit 采用了 两步展开(Two-step Unrolling) 策略:
- 模型先从噪声预测出一个清晰的 provisional 图像。
- 再次反推到中间步并重新生成,确保 VLM 面对的是清晰、可辨识的对象。
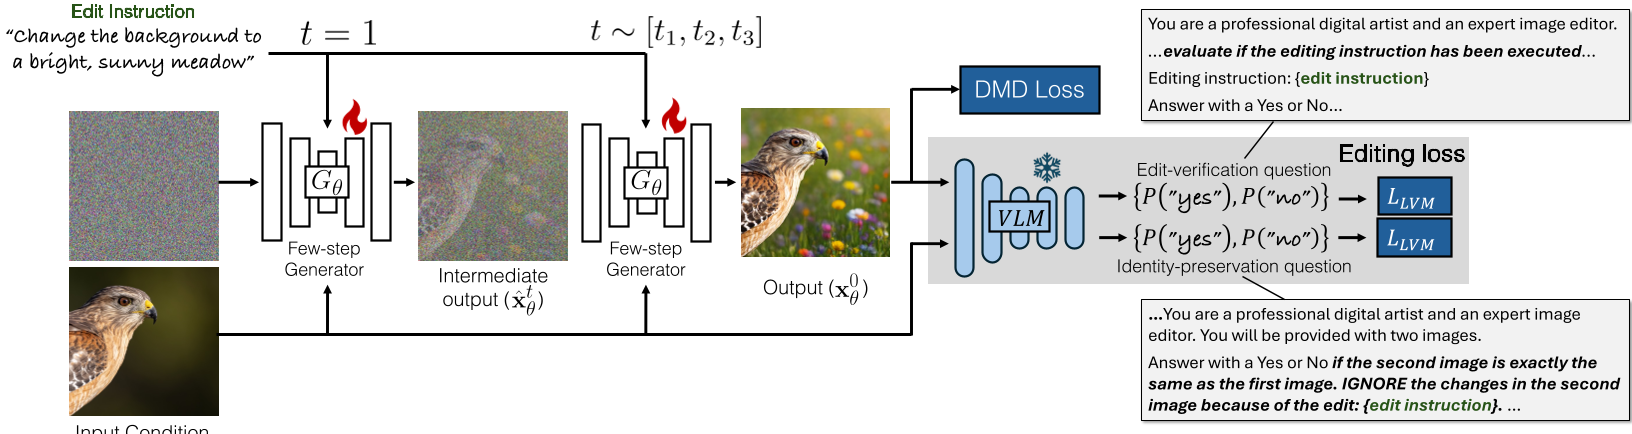 图 1:NP-Edit 训练流程,展示了 VLM 反馈与 DMD 损失的结合
2. 双重逻辑约束
- 编辑验证 (Edit-verification):询问 VLM 编辑指令是否落实。
- 身份保持 (Identity-preservation):询问 VLM 除了编辑部分,图像其他特征是否与原图一致。
- 分布匹配 (DMD):为了防止 VLM 过度干预导致图像“崩坏”,引入 DMD 损失,强制生成结果保持在预训练模型的自然图像流形中。
实验战绩:以小博大的胜利
实验结果令人惊喜。仅有 2B 参数的 NP-Edit 在 4 步采样 的设置下,其感知质量(PQ)全面超越了 12B 的 Step1X-Edit 和 20B 的 Qwen-Image-Edit。
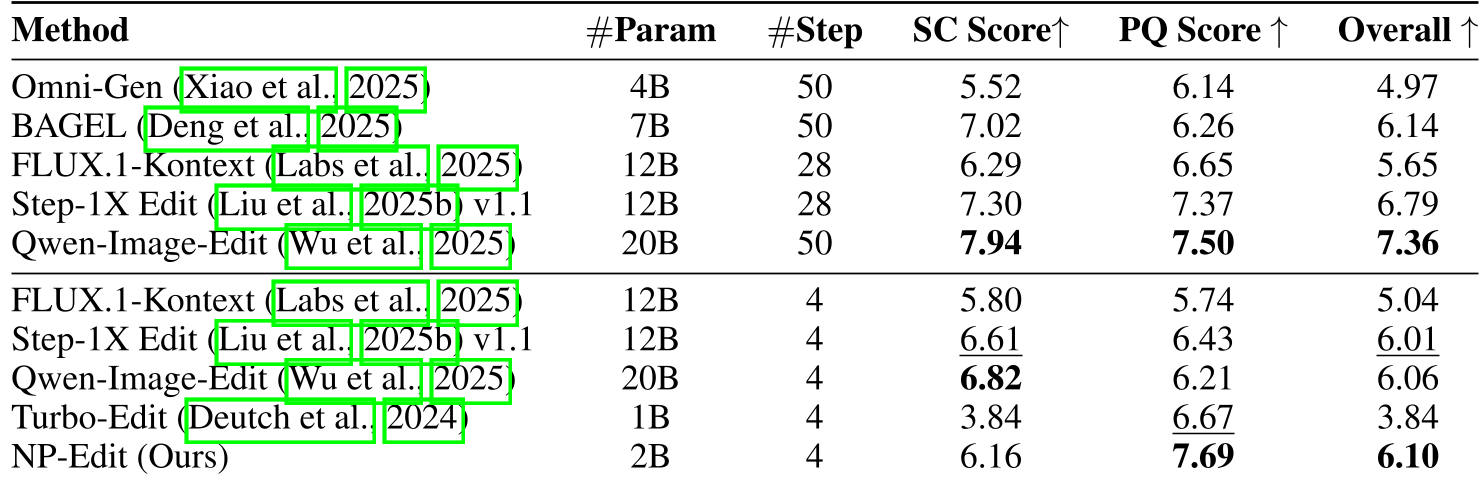 表 1:GEdit-Bench 定量对比,展示了 NP-Edit 在感知质量上的显著优势
在定性结果中,NP-Edit 表现出了极强的鲁棒性。无论是复杂的“羊毛颜色改变”,还是“将蜡烛点燃”,生成的图像在光影衔接和背景融合上都表现得非常自然。
 图 2:局部编辑效果展示,可见其在少步采样下依然保持了极高的保真度
深度洞察:为什么这种方法有效?
- 回避了误差累积:不使用合成的配对数据,意味着模型直接在真实图像上学习编辑逻辑。
- 梯度的力量:相比于 RL 的标量奖励,梯度反馈携带了更丰富的语义信息,使得模型能更快找到“如何改”的路径。
- 少量即是全量:通过 DMD 借用了大模型的先验,使得即使在小规模 Unpaired 场景下,也能维持 SOTA 级别的画质。
局限与未来
当然,NP-Edit 也不是完美的。由于缺乏像素级的直接监督,它在处理极度复杂的空间关系(如“把左边的苹果移到右边”)时偶尔会失准。此外,这种方法的高度依赖 VLM 自身的理解能力。
总结:NP-Edit 为图像编辑领域指明了一个方向——当数据成为瓶颈时,利用多模态模型作为“桥梁”进行跨模态知识迁移,可能是突破长尾、由于数据匮乏导致的性能瓶颈的最优解。