
把算力留给没解开的题:RL for LLMs 中的 Matthew Effect 与 Never Give Up
Learning to Solve Hard Problems in RL for LLMs by Never Giving Up
本文研究了大语言模型强化学习后训练中的 Matthew Effect,指出强化学习更偏向提升模型已经擅长的简单题目,而困难题目提升有限。作者提出 Never Give Up 动态重采样方法,在异步 RL 流水线中保留未解 prompt 并继续采样,把算力从易题转向难题。结果显示该方法在 Deepscaler 数学和 Manufactoria 代码任务上改善困难样本表现,并在固定算力下取得更高平均 pass@1。
核心速览
这篇论文的核心发现不是某个新 loss,而是一个训练分布层面的现象:LLM 经过 RL 后,并不会在整个数据分布上均匀变强,而是更容易在自己原本已经会的题上继续提升,原本不会的难题则几乎停滞。作者把这个现象命名为 The Matthew Effect in RL for LLMs,并进一步指出,常见解释“难题需要更多采样”并不充分。真正的问题是现代 GRPO 类算法把固定采样预算平均摊给每个 prompt,导致算力大量消耗在已经接近全对的易题上。作者提出的 Never Give Up 很直接:先小批量采样,如果全错,就以概率继续重采,直到出现正样本;如果全对,则立即丢掉。配合异步 RL 与 staleness 过滤,它让简单题少占算力,让难题多占算力。
从学术位置看,这项工作更像一篇“诊断加处方”型论文。它没有把目标放在单点 SOTA 刷榜上,而是先用三个公开 RL 模型证明现象的普遍性,再用小规模实验排除常见解释,最后给出一个工程上容易接入异步训练栈的方法。Figure 1 显示,Olmo 3.1 RL-Zero Math、DeepCoder 和 DeepSWE 三个模型在数学、代码生成和 agentic coding 上均呈现同一模式:RL 的提升幅度与初始 pass rate 正相关。这个图是全文问题陈述的锚点,也是判断它不是单数据集偶然现象的关键证据。
问题与动机
如果只看最终平均分,很多 RL 训练曲线看起来仍然很好,因为这往往意味着大量简单题被继续刷到接近满分。但一旦按难度分桶,问题就暴露出来:RL 对已经会做的题加分明显,对不会的题几乎没有推进。论文将这一现象概括为 RL improves performance on a task in proportion to a model’s initial competence。它并不是单纯的模型容量不足,也不只是“难题太难”,因为后续实验会说明,即便增加采样次数,固定预算也会产生新的偏差。
现代 GRPO 类方法的核心是组内比较:对同一个 prompt 采样多个 completion,用每个 reward 减去组均值作为 advantage。这个机制本身要求组内同时存在不同 reward,否则梯度为零。于是常见解释是 signal loss:难题全错,所以没有学习信号;解决办法是把每组采样数 K 调大,增加至少采到一个正样本的概率。这个解释看似自然,但论文用实验反驳了它。作者用 Qwen2.5-0.5B 在 GSM8k Platinum 上训练,并设计一个固定总 batch size 的测试:K 分别取 4、8、16、32,同时把 prompt 数 N 反向调整到 64、32、16、8。Figure 2 显示,K=4 整体最好,最难 subset 上尤其明显。也就是说,单纯增大 K 并不能解决 Matthew Effect。
这一结果把问题从“难题是否被采样到”推进到“算力是否被高效使用”。当 K 很大时,一个简单题只要在 K 个样本里偶然出现一个错误,就会进入训练更新;这会持续消耗 batch 去强化已经几乎解决的模式。相反,当 K 很小时,简单题更容易被全对过滤掉,训练批次反而更容易留下有信号或尚未解决的题。Figure 3 支持了这个解释:K=32 在训练后期仍包含更多易题,而 K=4 在步骤推进后更多训练难 prompt。于是作者提出 signal efficiency hypothesis:RL for LLMs 的关键不是绝对采样次数,而是让每个有效梯度单位尽可能落在尚未解决的信息上。
核心章节:从固定采样预算到失败驱动的动态重采样
GRPO 基线的形式:为什么固定 K 会把 batch 推向易题
论文的出发点是一个已经被广泛使用的组内优势估计。给定一个 prompt 和 K 个 completion,GRPO 将第 i 个 completion 的 advantage 写成:
其中 是第 个 completion 的二值或标量 reward, 是同一 prompt 内采样的 completion 数, 是组内平均 reward。这个式子在论证链里的作用是定义“什么算有效学习信号”:如果组内 reward 全相同,所有 都归零,该 prompt 不产生梯度。若把它和过滤策略结合,就会发现固定 有一个隐藏偏差:全对组会被过滤,全错组也会被过滤,只有混合组进入更新。随着模型能力增强,越来越多的题变成“大概率全对”,于是训练数据逐渐偏移到仍能制造差异的题上。这里的失效机制不是梯度公式写错,而是固定采样规模与过滤规则共同改变了训练分布:它没有显式把难 prompt 拉出来,反而让易 prompt 的偶发失败继续占据更新预算。
Never Give Up 的核心机制:失败次数决定额外采样预算
NGU 的直观规则很短:先采一小批,例如 。如果全部正确,说明当前模型已经解决该题,直接过滤;如果混合结果,说明存在可用 advantage,正常进入 GRPO 更新;如果全部错误,则不像标准 GRPO 那样放弃这个 prompt,而是以概率 继续再采 个,直到某个 completion 正确或选择放弃。这个随机停止把“继续采样次数”写成了一个几何分布。在论文给出的近似中,每次仍保持固定小组规模 ,只要尚未成功就以概率 继续,那么平均总采样数为:
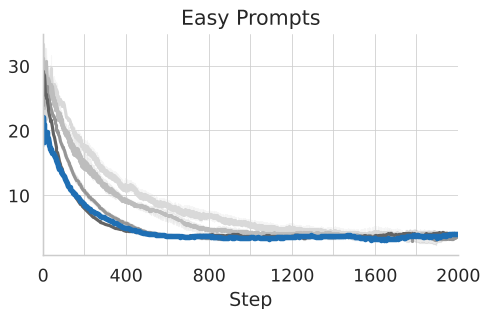
其中 是失败后继续采样的概率, 是每轮结束后放弃的概率。这个式子说明 NGU 并不是无差别把所有 prompt 都放大到很大的组规模,而是让平均预算维持在某个目标值附近,同时让难 prompt 有机会获得更长采样尾巴。相比直接设 ,NGU 的差别在于它只对“仍然全错”的 prompt 追加预算;相比完全不追加,它又不会把所有难题直接筛掉。Figure 5 给出了这一机制的关键证据:NGU 在训练早期拥有较多难 prompt,接近大 的行为;训练后期又能像小 一样过滤掉大量易题,从而在难样本比例与易样本过滤之间接近 Pareto 最优。这里的核心不是“多采样”本身,而是多采样被绑定到了失败事件上,而不是绑定到了每个 prompt 的固定预算上。
异步、staleness 与优势重标定:让旧样本进入 baseline 但不一定进入 loss
NGU 的另一个重要设计是保留历史 completion。标准 GRPO 如果只用最后一次采到的 个样本,那么即使模型已经为该难题采了上百次全错,最终偶尔采到一个正样本时,优势幅度仍可能只有 。NGU 会把之前非 stale 的负样本与当前正样本合并成更大的 GRPO 组,让正样本获得更大的有效 advantage。但异步 RL 会引入 stale rollout:旧 completion 来自更早的 policy 版本,直接全部送入 loss 会伤害训练稳定性。论文因此设置年龄阈值 ,只允许足够新的 completion 参与更新。作者发现 到 性能上升,但 和 下降,说明 stale 样本对 loss 是双刃剑:它们可以提供更好的 baseline,却不应无限制进入 policy gradient。
对于被过滤掉的旧样本,NGU 仍可以利用它们的 reward 来估计一个更稳的组平均基线。论文算法中的加权更新可以形式化为:
其中 是缓冲区中旧样本的平均 reward, 是旧样本计数, 是当前新采 个样本的平均 reward。这个式子的作用是把不同年龄、不同有效样本数的历史统计合并成一个更可靠的 baseline,减少小样本导致的均值波动。不过,如果 baseline 包含了已经被过滤出 loss 的负样本,而 advantage 仍然按 GRPO 零和直觉使用,更新组的优势和可能不再严格为零。作者提出 anchoring the positives:保持正样本 advantage 的锚定,并对剩余负样本的 advantage 进行重缩放,使更新组重新满足零和约束:
其中 是真正参与 loss 的新样本与未过期旧样本组成的更新组。这个式子并不描述某个具体奖励函数的物理量,而是一个训练稳定性约束:它要求被送入 policy gradient 的那部分样本不会整体偏向正例或负例。原文对重缩放的精确解析式在提供的文本中有 OCR 断裂,但机制已经清楚:正样本被保留为锚点,负样本按剩余比例重新分配,从而避免 stale 样本污染更新方向。
实验与证据
GSM8k 消融:每个设计选择都不可省
论文先用 GSM8k 小实验定位原因,再用 Table 1 对 NGU 做机制消融。这里的关键不是平均分,而是 extra hard 这一列。Baseline GRPO 在简单、中等和困难题上接近满分,但 extra hard 只有 47.1。若把 NGU 的放弃概率设为 ,相当于永远不放弃所有全错 prompt,系统会卡死,extra hard 跌到 2.7。若加入 但使用同步 RL,难题采样无法快速填补易题过滤留下的空位,extra hard 仍只有 14.8。加入异步 RL 后,downsampling 方案把负样本削减到与正样本数量平衡,这看起来更符合对称直觉,却丢失了大量有信息量的负样本,extra hard 为 63.9。最终的 NGU 异步 RL 加正样本锚定在简单题保持 100.0 的同时,把 extra hard 提到 87.9。Table 1 报告了 NGU 关键设计选择在 GSM8k 上的 pass@1 消融,列为四个难度桶:
| 方法 | easy | medium | hard | extra hard |
|---|---|---|---|---|
| Baseline GRPO | 100.0 ± 0.0 | 99.9 ± 0.1 | 99.6 ± 0.2 | 47.1 ± 6.4 |
| NGU p=1.0 | 83.9 ± 0.7 | 61.2 ± 2.3 | 36.3 ± 3.3 | 2.7 ± 1.0 |
| NGU p=0.75 加同步 RL | 99.0 ± 0.5 | 97.3 ± 0.5 | 93.8 ± 2.3 | 14.8 ± 5.2 |
| NGU p=0.75 加异步 RL 加 downsampling | 99.5 ± 0.3 | 96.7 ± 0.7 | 95.4 ± 0.9 | 63.9 ± 5.5 |
| NGU p=0.75 加异步 RL 加正样本锚定 | 100.0 ± 0.0 | 99.2 ± 0.4 | 98.6 ± 0.3 | 87.9 ± 2.2 |
这张表把方法拆成三层:停止规则、异步基础设施、历史样本的使用方式。它说明 NGU 的收益不是来自一个单点 trick,而是三者共同成立:没有放弃概率会 stall,没有异步则过滤出的算力槽位不能被难题重采样填补,没有正样本锚定则会误伤难样本的更新幅度。
Deepscaler:更大模型与更高算力下仍改善难例
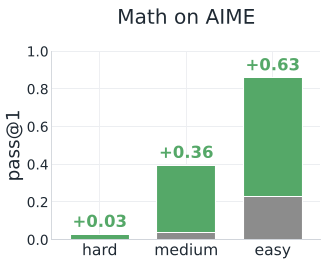
作者随后把实验推到更接近现实 RL post-training 的规模:Qwen3 4B-Base 在 10k Deepscaler 子集上训练,用约 120 H100 小时做算力匹配,并在 AIME 2025 和 BRUMO 2025 上评测。难度分桶基于初始模型 pass@64:hard 是 pass@64=0,medium 平均为 2.9%,easy 平均为 46.1%。Table 2 报告了最终 pass@1 结果,表后说明均为三个 seed 的平均与标准差:
| 方法 | AIME 2025 | BRUMO 2025 | 平均 |
|---|---|---|---|
| Qwen 3 4B Base | 7.63 | 16.3 | 12.6 |
| GRPO N=2, K=64 | 20.3 ± 0.9 | 28.8 ± 0.7 | 24.5 ± 0.5 |
| GRPO N=4, K=32 | 21.4 ± 1.3 | 29.2 ± 0.7 | 25.3 ± 0.5 |
| GRPO N=8, K=16 | 20.0 ± 1.5 | 29.6 ± 1.4 | 24.8 ± 1.0 |
| NGU K=16, p=0.875 | 21.8 ± 0.2 | 31.2 ± 1.3 | 26.5 ± 0.6 |
| NGU K=16, p=0.75 | 21.3 ± 2.1 | 31.6 ± 1.5 | 26.4 ± 0.7 |
| NGU K=16, p=0.5 | 22.0 ± 0.7 | 30.1 ± 1.6 | 26.1 ± 0.6 |
| Darling | 20.1 | 31.7 | 25.9 |
整体平均看,NGU p=0.875 的最佳设置把最强 GRPO 基线从 25.3 提升到 26.5,超过 Darling 的 25.9。这个数字本身不算巨大,但结合难度分桶更有意义。Table 3 报告了相对初始 Qwen3 4B-Base 的 pass@1 提升,按 easy、medium、hard 子集拆分:
| 方法 | easy 提升 | medium 提升 | hard 提升 | total 提升 |
|---|---|---|---|---|
| GRPO N=2, K=64 | 23.3 ± 1.9 | 15.3 ± 1.5 | 2.5 ± 0.2 | 11.5 ± 0.5 |
| GRPO N=4, K=32 | 26.0 ± 2.5 | 15.4 ± 1.8 | 2.5 ± 1.1 | 12.2 ± 0.5 |
| GRPO N=8, K=16 | 26.8 ± 2.6 | 14.5 ± 3.6 | 1.6 ± 0.3 | 11.7 ± 1.0 |
| NGU K=16, p=0.875 | 26.8 ± 1.7 | 16.3 ± 0.9 | 4.3 ± 1.2 | 13.5 ± 0.6 |
| NGU K=16, p=0.75 | 28.1 ± 0.2 | 16.8 ± 3.3 | 3.0 ± 1.2 | 13.4 ± 0.7 |
| NGU K=16, p=0.5 | 25.1 ± 2.3 | 17.9 ± 2.2 | 3.3 ± 1.9 | 13.0 ± 0.6 |
| Sampling Curriculum | 22.7 ± 1.6 | 15.5 ± 1.4 | 4.0 ± 1.1 | 12.1 ± 0.8 |
这里最重要的不是 p=0.875 在所有列都第一,而是 NGU 在 easy 提升没有明显牺牲的情况下把 hard 提升从基线的 2.5 提到 4.3。对比显式 Sampling Curriculum,后者虽然 hard 提升也达到 4.0,但 easy 只有 22.7,明显低于 NGU p=0.875 的 26.8。这说明静态课程虽然知道“难题要多采样”,却把初始难度估计固化了;模型训练中一些题会从难变易,课程若不能重新评估,就会误伤易题或浪费难题预算。NGU 的价值恰恰在于在线适应:不预设每个 prompt 的终身分级,只用当前采样是否成功来决定是否继续。
Manufactoria:从 prompt 难度到 test 难度的 Harness-Aware Matthew Effect
代码任务提供了一个更细粒度的观察维度。Math prompt 通常只有一个最终答案,而 Manufactoria 的每个问题包含 14 到 30 个 test cases,同一 prompt 内部就有容易测例和困难测例。Sun et al. 的原始 GRPO 使用 per-test reward,能学到通过大量简单测例,却很少能通过一题的所有测例。论文解释这是信号效率问题:模型几乎总通过 easy tests,hard tests 的成功率长期低于 20%,中等难度 tests 的不稳定通过贡献了主要 reward variance。换句话说,训练信号被反复分配给已经接近解决的局部行为,而不是推进完整任务。
NGU 在 Manufactoria 上的设置是标准 GRPO 加 。Figure 9 显示,标准 GRPO 在总测例通过率上很快 plateau,而 NGU 虽然早期在总体测例通过率上不一定领先,却能持续改善 hard tests,并最终学会通过全部测例。论文还提到一个重要的概念修正:如果直接用初始模型 pass rate 分桶,Manufactoria 上看不出明显 Matthew Effect;但模型先需要适应 prompt/harness,在约第 100 步后重新定义难度,就会看到清晰的马太效应。这让论文从“题目本身难度”推进到“模型在特定 harness 下的有效难度”,对工程实践更有意义。
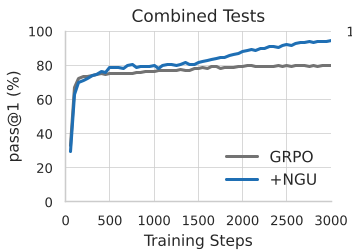
另一个值得单独拿出来看的证据是 Figure 10。Sun et al. 原本需要两阶段训练:先用 per-test reward 训练到 plateau,再切换到 all-tests reward,因为初始模型无法在 all-tests reward 下直接获得正例。论文从 3000 步后的 GRPO checkpoint 继续比较:per-test reward 加 NGU 与 all-tests reward 标准 RL 相比,在算力效率上大致相当。这个结果的含义不只是 NGU 能解难题,而是它能从已经被次优奖励带偏的模型中恢复有效训练信号。它也说明 LLM RL 的 Matthew Effect 不同于从头训练时的 plasticity loss:即使前期用 suboptimal objective 训练了很久,后续只要提供正确的信号和算力分配方式,模型仍可继续进步。
证据质量与边界
论文的强证据链来自三层:现象层用 Figure 1 在三个域展示难度偏差;机制层用 Figure 2 与 Figure 3 排除“增大 K 即可”的解释;方法层用 Table 1、Table 2、Table 3 和 Manufactoria 实验说明 NGU 的收益来自具体设计。尤其 Table 1 的价值很高,因为 NGU 听起来只是一个采样策略,但实验证明如果去掉放弃概率、去掉异步 RL 或去掉 stale 样本的正样本锚定,结果会分别退化为 stall、同步等待和过度丢弃负样本。这使得结论不只是“方法更好”,而是“为什么必须这样组合”。
但论文也有清晰边界。NGU 依赖一个隐含条件:训练分布中存在足够多可以被快速过滤的 easy prompts。如果几乎所有题都很难,异步重采样会显著拖慢组完成速度,并产生更多 off-policy 样本,反而削弱训练信号。论文作者在 Limitations 中明确不推荐 完全用 控制 batch,因为这会让训练更 off-policy。此外,难度分桶依赖初始模型的 pass@N,而 Manufactoria 的 harness-aware 结果已经说明初始 pass rate 会被 prompt 适应过程污染;这意味着 NGU 的收益虽然在线适应,但评估难度仍然不是唯一真值。
总结
这项工作把 RL for LLMs 的一个常见误解拆开:难题表现差,并不只是因为采样不够多,而是固定采样预算会持续把算力喂给已经会做的题。Never Give Up 的贡献不在于复杂算法,而在于把“失败”重新解释为资源分配信号:全错不等于应该丢弃,全对也不等于应该继续占坑。配合异步 RL 和 stale rollout 的精细处理,NGU 在数学竞赛和代码测试任务上都提高了困难样本的有效训练密度。更实际地说,它提示后训练系统设计者:如果训练栈已经异步,那么把采样预算从固定 K 改为按失败动态延长,可能是比堆大组规模更便宜也更稳的起点。