
TTT-Discover:让 LLM 在测试环节“边跑边进化”,刷新多项科学发现纪录
Learning to Discover at Test Time
本文提出了 TTT-Discover,一种在测试阶段通过强化学习(RL)提升大语言模型(LLM)发现能力的框架。该方法在数学、GPU算子工程、算法竞赛和生物学领域均取得了新的 SOTA,例如在 Erdős 最小重叠问题上刷新了世界纪录。
TL;DR
斯坦福与 NVIDIA 等机构的研究团队推出了 TTT-Discover (Test-Time Training to Discover)。它不再只是让 LLM 反复尝试(Best-of-N),而是让模型针对特定的科学问题在测试阶段即兴“闭关修炼”。通过强化学习更新参数,它在 Erdős 最小重叠问题、GPU 算子优化及算法竞赛中均超越了人类专家和此前的最强 AI。
痛点深挖:搜索的尽头是学习
当下的 LLM 解决难题时,业界主流采用“测试时计算(Test-time Compute)”——即让模型多想几遍或进行进化搜索(Evolutionary Search)。但这些方法都有一个致命弱点:模型是“死”的(Frozen)。
如果一个问题极其艰深,超出了模型的预训练分布(Out-of-Distribution),无论搜索多少次,模型可能永远无法“开窍”。人类在面对这类难题时,往往是通过不断的失败来磨练直觉。TTT-Discover 的核心直觉是:与其让 LLM 大海捞针地搜,不如让它在搜索过程中学会怎么搜。
核心方法:Test-Time Training (TTT) 重构强化学习
1. 从“平均分”转向“最高分”
传统 RL 旨在提高平均预期收益。但在科学发现中,我们只需要模型产出一个惊世骇俗的解即可。为此,作者提出了熵目标函数 (Entropic Objective):
这种机制通过调节 参数,让模型呈指数级地倾向于追逐高奖励路径,而不是稳扎稳打地拿平均分。
2. PUCT 状态重用机制
在复杂的搜索树空间里,模型需要决定从哪个历史状态(State)继续探索。作者借鉴了 AlphaZero 这种基于 MCTS(蒙特卡洛树搜索)的思路,但在评估状态价值 时,仅考虑该路径下的最大奖励,而非平均奖励。
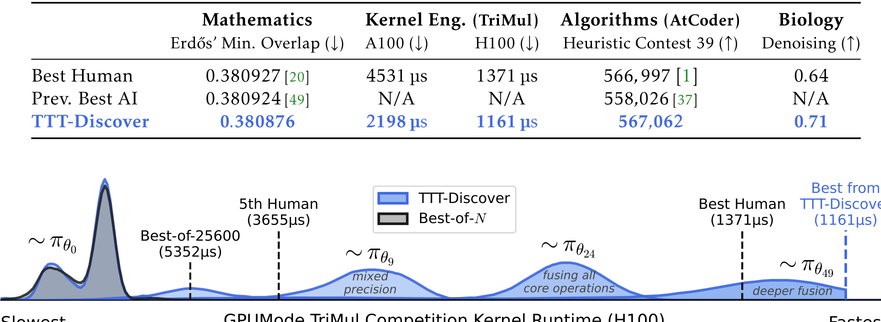 图 1:TTT-Discover 的迭代逻辑。模型 πθi 在每一步训练后权重都会更新,从分布图中可以看到,随着训练进行(从 step 0 到 49),模型生成解的奖励分布明显向右移动,最终超越了人类专家的基准。
实验与结果:全方位的跨界打击
1. 数学重地:刷新 Erdős 纪录
Erdős 的最小重叠问题已困扰数学界多年。此前由 DeepMind 开发的 AlphaEvolve 将界限推进到了 0.380924。而 TTT-Discover 通过在测试时进行 RL 训练,发现了一个不对称的 600 段阶梯函数,将该纪录进一步刷新至 0.380876。
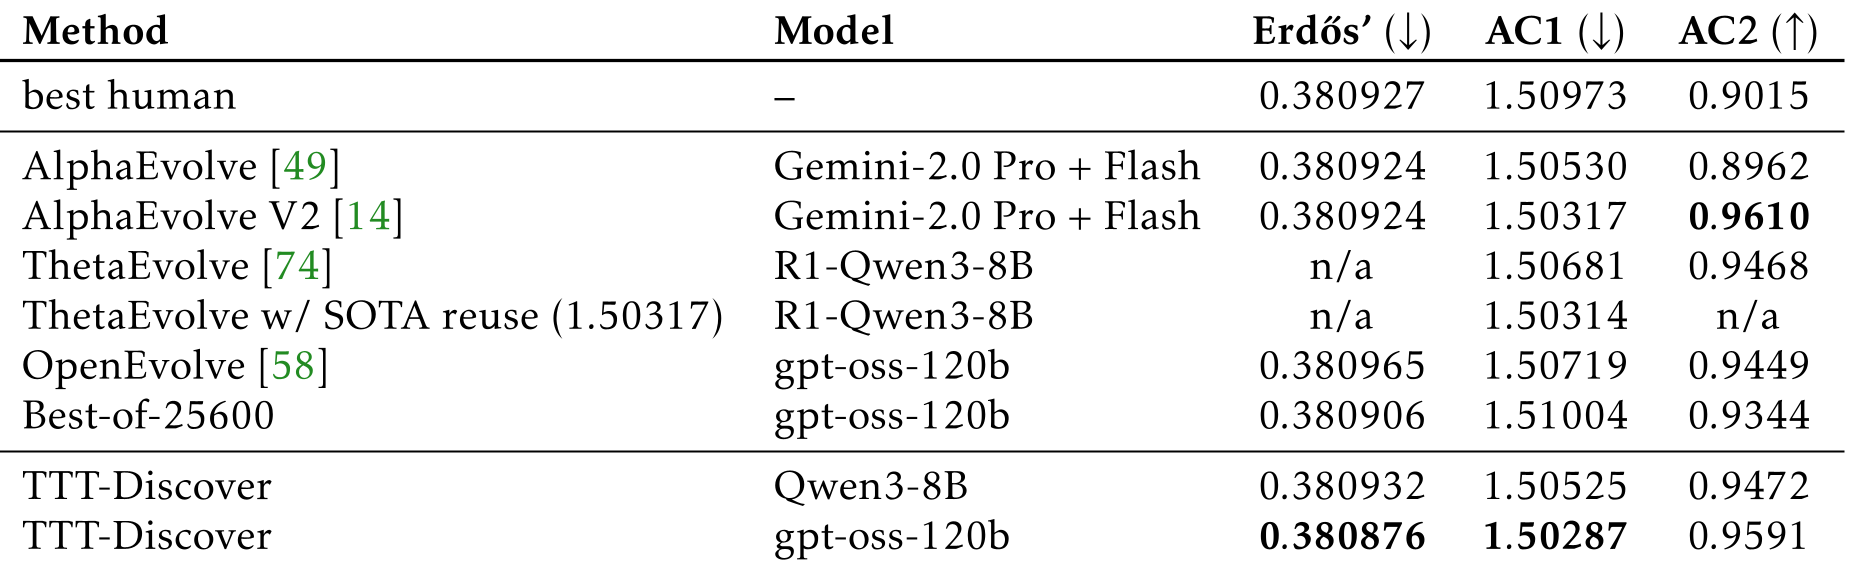 表 2:在多项自相关不等式和数学问题上,TTT-Discover(即便是配合较小的模型)也能击败使用 Gemini 2.0 等前沿模型的竞争者。
2. 算子工程:超越人类专家
在 GPUMode 举办的 TriMul(三角矩阵乘法)竞赛中,TTT-Discover 生成的 Triton 算子在 A100 上比人类冠军还快 50%。其成功的关键在于模型学到了如何进行极致的算子融合(Fusion),减少了 GPU 的显存 I/O。
3. 算法竞赛:AtCoder 模拟首位
在 AtCoder Heuristic Contest (AHC) 的模拟中,TTT-Discover 编写的 C++ 程序得分能够排在官方排行榜的第一名,超越了所有人类参赛选手。
深度洞察:开源模型的降维打击
最让行业震撼的一点是:这些成果绝大多数是在开源模型(gpt-oss-120b)上完成的。
以往我们认为,解决这类难题必须依靠像 GPT-4o 或 Gemini Pro 这样规模巨大、推理能力封神的闭源模型。但 TTT-Discover 证明了:算法的架构优越性(测试时训练)可以弥补模型本体的规模不足。 仅仅耗费几百美元的推理与梯度更新成本,就能让一个中型规模的开源模型在特定任务上进化成“垂直领域最强者”。
总结与局限
TTT-Discover 展示了 AI “自主科研”的新范式。尽管它目前仍受限于连续奖励函数(Continuous Rewards)——即系统必须能给出一个明确的“分数”来引导强化学习,但在数学推导和代码优化等可量化领域,它已经展现了统治力。
未来,如果能将这种测试时参数进化的能力扩展到稀疏奖励甚至无奖励的纯推理领域,LLM 可能会真正具备解决“未解之谜”的创造力。