
学习于无形:揭秘 Transformer 上下文学习的隐式动力学
Learning without training: The implicit dynamics of in-context learning
本文提出了“上下文块”(Contextual Blocks)理论框架,证明了 Transformer 的上下文学习(ICL)在数学上等价于对其 MLP 层权重的隐式低秩更新。该研究通过闭式解公式,将复杂的注意力机制效果映射为 MLP 的 Rank-1 权重补丁(Token-Patch),实现了“无需训练的学习”。
TL;DR
为什么大模型在不改动权重的情况下,仅凭几个示例就能学会新任务?Google Research 的这项工作给出了一个令人惊喜的数学解释:In-Context Learning (ICL) 本质上就是一种“隐式微调”。 作者证明,Transformer 的每一层前向传播,实际上都在物理上等效于对模型 MLP 权重进行了一次 Rank-1 的低秩更新。
1. 核心动机:当推理变成“训练”
在传统机器学习中,学习意味着权重更新();但在 ICL 中,权重是冻结的。研究界一直猜测模型内部可能在“模拟”某种优化算法。
本文作者不仅证实了这一直觉,还给出了精确的解析解。他们提出:Self-Attention 负责提取上下文特征,而这些特征随后被“注入”到了紧随其后的 MLP 层权重中。 这种机制让模型在处理每一个新 Token 时,都像是在经历一次极速的在线微调。
2. 数学直觉:最小 Token 补丁 (Minimal Token-Patch)
作者定义了一个核心概念——Contextual Block。 假设输入序列为 ( 为上下文, 为查询),模型在 存在下的输出,完全等同于在没有 的情况下,使用修补后的权重 对 进行计算。
通过求解 Frobenius 范数最小化问题,作者得到了 的唯一闭式解:
这个公式揭示了:
- 低秩性:更新矩阵是一个 Rank-1 矩阵,这与 LoRA 等微调技术异曲同工。
- 保守性:由于更新是正交的,它只影响与当前上下文相关的方向,不破坏模型原有的知识。
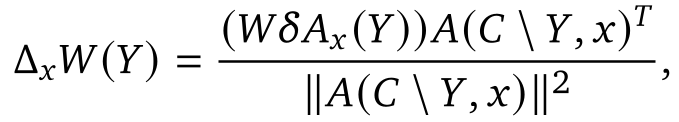
3. 实验验证:隐式与显式的完美对齐
为了验证理论,作者进行了几项关键实验:
3.1 精度验证
在 10 层深度 Transformer 中,使用该理论计算出的“补丁权重”进行推理,其输出结果与原始带上下文推理的误差仅为 ,证明了数学上的严丝合缝。
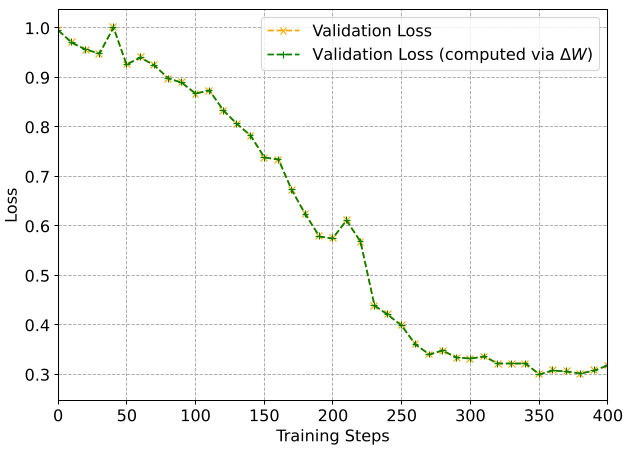 图注:左侧显示补丁模型与原始模型的 Loss 曲线重合,右侧显示层间输出差异极小。
3.2 模拟 SGD 过程
实验发现,随着上下文 Token 的逐个输入,模型权重的隐式演化轨迹与显式使用 SGD 进行微调的轨迹高度一致。这意味着 Transformer 架构本身就是一个天然的优化器。
4. 架构诊断:为什么 RNN 不行?
通过这一工具,作者对比了 Attention 和 RNN。
- Attention:生成的隐式梯度更新平滑且收敛。
- RNN:更新极其不稳定,无法有效将上下文转化为稳定的权重状态。 这从动力学角度解释了为什么 Transformer 在长上下文适应上远优于传统循环架构。
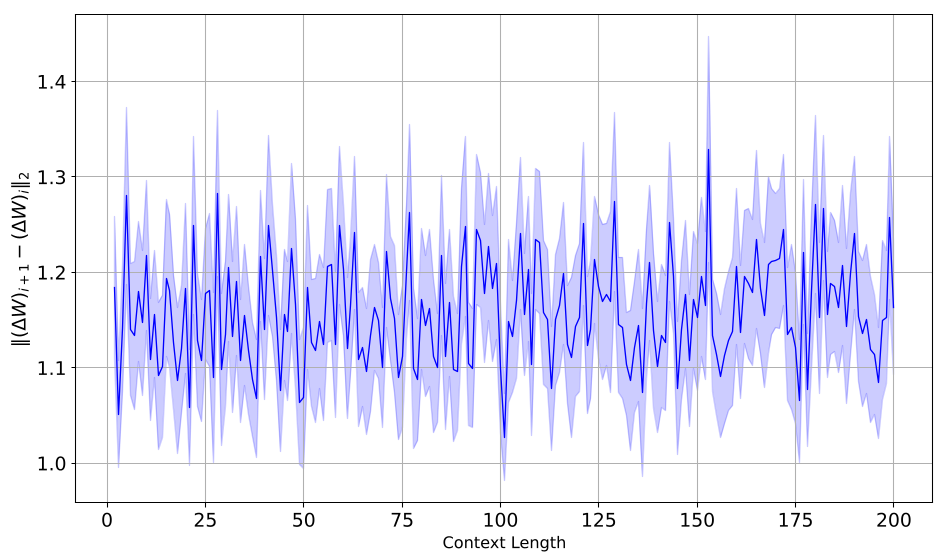 图注:Attention(左)的更新向量随长度增加趋于稳定,而 RNN(右)始终处于震荡状态。
5. 商业价值:迈向“无 KV-Cache”推理
既然上下文可以转化为权重补丁,那我们是否可以把冗长的 Prompt 压缩成几颗“权重种子”? 作者提出了 Thought Patch(思维补丁):通过最小二乘法将特定上下文的更新聚合为一个静态权重。实验表明,这种静态补丁在未见过的查询(Test Token)上依然具有极强的泛化能力。
这意味着,未来我们可能通过直接修改模型权重来“注入”长文档信息,从而彻底省去推理时沉重的 KV-Cache 负担,极大提升推理速度。
6. 总结与反思
这篇论文的真正价值在于:它告诉我们 ICL 不是什么魔法,而是 Transformer 这种特定拓扑结构的数学必然。
- 局限性:目前的 计算仍依赖于特定的输入,通用的“上下文到权重的完美转换”仍有待探索。
- 启示:MLP 并非仅仅是线性映射,它是 Transformer 处理动态任务的“内存条”。理解了这一点,我们就掌握了模型编辑和高效推理的新钥匙。