
LightRAG:把图关系压缩成双层检索索引,同时降低 GraphRAG 的更新成本
Lightrag: Simple and fast retrieval-augmented generation
本文提出 LightRAG,用 graph-based text indexing、dual-level retrieval 和 incremental update 改进检索增强生成。论文显示,它在 Legal 上以 84.8% Overall 胜率超过 NaiveRAG,并在检索阶段把 GraphRAG 的约 610000 tokens 社区遍历压缩到不足 100 tokens 与 1 次 API 调用。
TL;DR
LightRAG 针对现有 RAG 的两个结构性弱点展开:一是扁平 chunk 检索难以回答跨实体的复杂问题,二是已有 graph RAG 方法往往用社区报告换取全局能力,却在检索和增量更新上付出高成本。论文提出 graph-based text indexing、dual-level retrieval 和 incremental update 三件事:先把文本抽取成实体和关系,再给实体与关系生成可向量检索的 key value,最后通过低层关键词命中实体、高层关键词命中主题关系,并合并新图实现更新。Table 1 显示,LightRAG 在 Legal 上对 NaiveRAG 的 Overall 胜率达到 84.8%,对 GraphRAG 的 Overall 胜率达到 52.8%;4.5 节成本表显示,在 Legal 检索阶段,GraphRAG 约消耗 610000 tokens 并进行多次社区遍历,LightRAG 只使用不足 100 tokens 和 1 次 API 调用。
背景定位:一篇面向工程效率的 Graph RAG 修补之作
这项工作的定位不是开创 Graph RAG,而是修补 GraphRAG 在效率和动态更新上的短板。原文在 4.1 节选择 UltraDomain 中的 Agriculture、CS、Legal、Mix 四个领域,附录 Table 4 显示这些语料规模从 619,009 tokens 到 5,081,069 tokens 不等,其中 Legal 最大。作者比较的对象也不是弱基线,而是 NaiveRAG、RQ-RAG、HyDE、GraphRAG 四类近年常见做法。GraphRAG 已经证明社区报告能改善全局问答,但它把全局信息绑定在预先生成的大量社区报告上;LightRAG 的判断是,真正需要的是能被向量库快速索引的结构化关系,而不是必须逐社区读取的自然语言摘要。
因此,这篇论文更像是一个“系统约束下的方法改进”。它没有给出严格定理,也没有提出复杂训练目标;它的贡献集中在索引结构、检索路径和更新策略三个工程点上。这个定位很重要:如果读者用理论创新的标准去看,会觉得它形式化程度有限;但如果用 RAG 落地成本看,它抓住了 GraphRAG 最难被忽略的两个问题:查询延迟和知识库漂移。
问题与动机:扁平检索丢失关系,社区检索丢失效率
原文的出发点可以压缩成一个标准 RAG 形式。论文在 2 节给出:
其中 是整个检索增强生成系统, 是生成模块, 是检索模块, 是索引函数, 是检索函数, 是用户查询, 是外部知识库, 是索引后的数据结构。这个式子的作用是把 RAG 拆成两个可替换的接口:系统是否有效,主要取决于 能否组织出对查询友好的信息,以及 能否高效命中这些组织后的信息。若 只是把文档切成固定长度块, 只是做 embedding 最近邻,那么系统很容易在回答跨块问题时失败:它能把“电动车”“空气质量”“公共交通”各自找到,却未必能把三者之间的因果链拼接起来。LightRAG 的问题意识正是从这里出发,它试图让 保留实体关系,让 能同时检索细节实体和主题关系。
GraphRAG 代表了另一种方向:用图结构抽取社区报告,让全局问题有可读摘要。但原文在 4.5 节指出,这在查询阶段变成了大量社区报告的遍历。GraphRAG 在 Legal 上生成 1,399 个社区,其中 610 个 level-2 社区用于检索,每个社区报告约 1,000 tokens,仅检索上下文就达到约 610,000 tokens。这个成本不是实现瑕疵,而是范式代价:全局信息被固化在“报告”里,查询就必须把许多报告拉进上下文。LightRAG 想换一种做法:不把所有全局信息提前写成大段社区报告,而是把实体和关系变成短 key,再用向量匹配和一跳图扩展在查询时现场组装上下文。
核心章节
从扁平块检索转向图增强索引
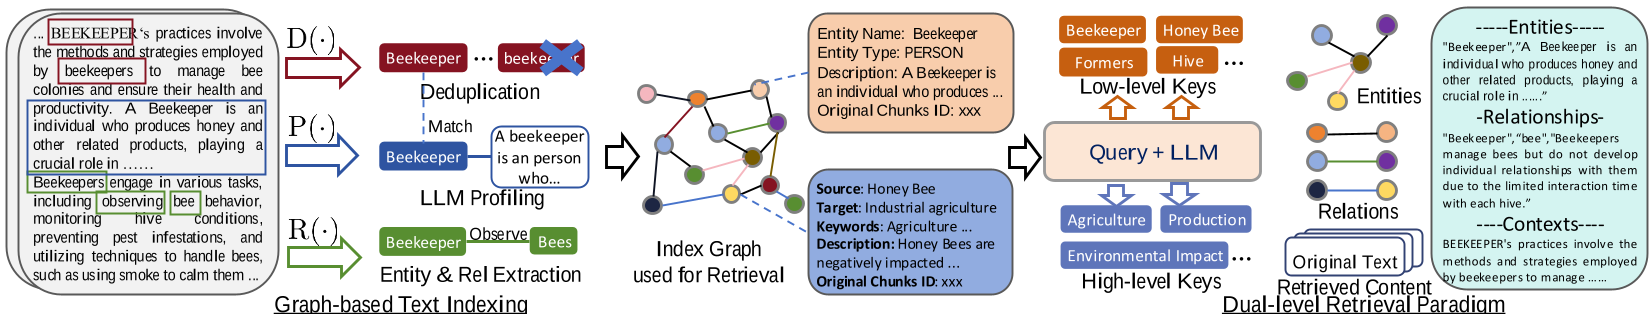
LightRAG 的第一步不是生成更好的答案,而是重写索引。论文在 3.1 节给出图式索引公式:
其中 是外部知识库中的文本块, 由 LLM 从文本块中抽取实体集合 和关系集合 , 为每个实体和关系生成 text key value pair, 合并来自不同块的相同实体与关系,最终得到索引图 。相比前一个式子中的 ,这个公式把“索引结构”具体化了:索引不再是一堆 chunk embedding,而是一张经过 LLM 标注、简化和去重的图。这里的关键设计是 key value:实体用自己的名称作为唯一索引 key,关系则可以拥有多个 key,因为关系边会被 LLM 附加来自两端实体的全局主题词。这个选择让向量库不再只匹配“整段文本像不像”,而是匹配“这个实体或关系在语义上属于哪些主题”。
若只做到这一步,LightRAG 仍然只是一个轻量知识图谱抽取器。论文真正想让它工作起来,依赖两个判断:第一,实体和关系本身就是自然语言中较稳定的检索锚点;第二,图结构中的邻接关系可以补充向量相似性无法直接建模的上下文。这也解释了为什么作者强调 Dedupe 不是可选清洁工作,而是效率来源:图越小,一跳扩展越便宜,重复实体带来的检索噪声也越少。但论文没有给出实体对齐误差如何累积的定量分析,这使“去重能提升效率”的判断主要来自工程描述,而不是误差分析。
双层检索:低层实体与高层主题共用向量索引
LightRAG 的第二个核心是 dual-level retrieval。论文区分 specific queries 和 abstract queries:前者指向某个实体的精确事实,例如“谁写了 Pride and Prejudice”,后者指向主题或关系链,例如“人工智能如何影响现代教育”。系统先为查询生成 local query keywords 和 global query keywords ,然后用向量库分别匹配候选实体和候选关系。命中之后,它还会沿图扩展一跳邻居:
其中 是待纳入上下文的节点, 表示已检索节点 的一跳邻居集合, 表示已检索关系边 的端点邻居集合, 是图索引中的节点集合。这个式子在论文中的作用是说明 LightRAG 并非只做向量命中,它还会把命中结果周围的结构信息拉进来。相比社区报告需要预先组织全局摘要,这一扩展把“全局性”推迟到查询时,用命中的实体和关系作为锚点局部展开。若去掉低层检索,系统只靠关系主题词,就容易泛化到宽话题但缺实体细节;若去掉高层检索,系统只盯实体和直接属性,就容易在复杂主题问题上显得窄。Table 2 的消融正好对应这个判断:在 Overall 维度上,以 NaiveRAG 为参照,完整 LightRAG 在 Legal 上胜率是 84.8%,而 -High 和 -Low 分别为 78.0% 和 81.2%。
这一机制还有一个容易被忽略的细节:检索对象不再是 chunk,而是 entity 和 relation 的 values。论文在 3.3 节说明,答案生成使用从相关实体和关系中拼接出的 values,包括名称、描述、关系摘要和原文摘录。这使得 LLM 看到的上下文已经被图结构预组织过,而不是原始块列表。但这也带来一个新的不确定性:如果 Recog 和 Prof 阶段抽取错误,错误会被当作事实进入上下文。论文没有提供对抽取错误传播的独立审计,因此实验结论更适合作为端到端答案质量的证据,而不是图抽取精度本身的证据。
增量更新与成本边界
LightRAG 的第三个贡献点是把新知识纳入旧图的成本压得很低。论文在 3.1 节说明,对新文档 ,系统仍使用同一索引流程 得到 ,然后把新图和旧图合并:
其中 是节点集合并集, 是边集合并集。这个式子看似简单,却是与 GraphRAG 拉开成本差距的关键。GraphRAG 的社区结构一旦加入新节点或新关系,往往需要重新组织社区并重新生成社区报告;LightRAG 则把更新限制为“抽取新块中的实体关系,再并入已有图”。这并不意味着没有成本:论文仍然承认 的存在,即新文本仍需 LLM 抽取实体和关系。真正被省掉的是全局重建社区报告的成本。3.4 节的复杂性分析也说明这一点:索引阶段按文本总 token 数除以 chunk size 调用 LLM,检索阶段主要是一次关键词生成和向量检索,而不是逐社区遍历。
4.5 节在 Legal 上给出成本对比:
| 阶段 | 模型 | Tokens | API Calls |
|---|---|---|---|
| 检索阶段 | GraphRAG | ||
| 检索阶段 | LightRAG | ||
| 增量更新 | GraphRAG | ||
| 增量更新 | LightRAG |
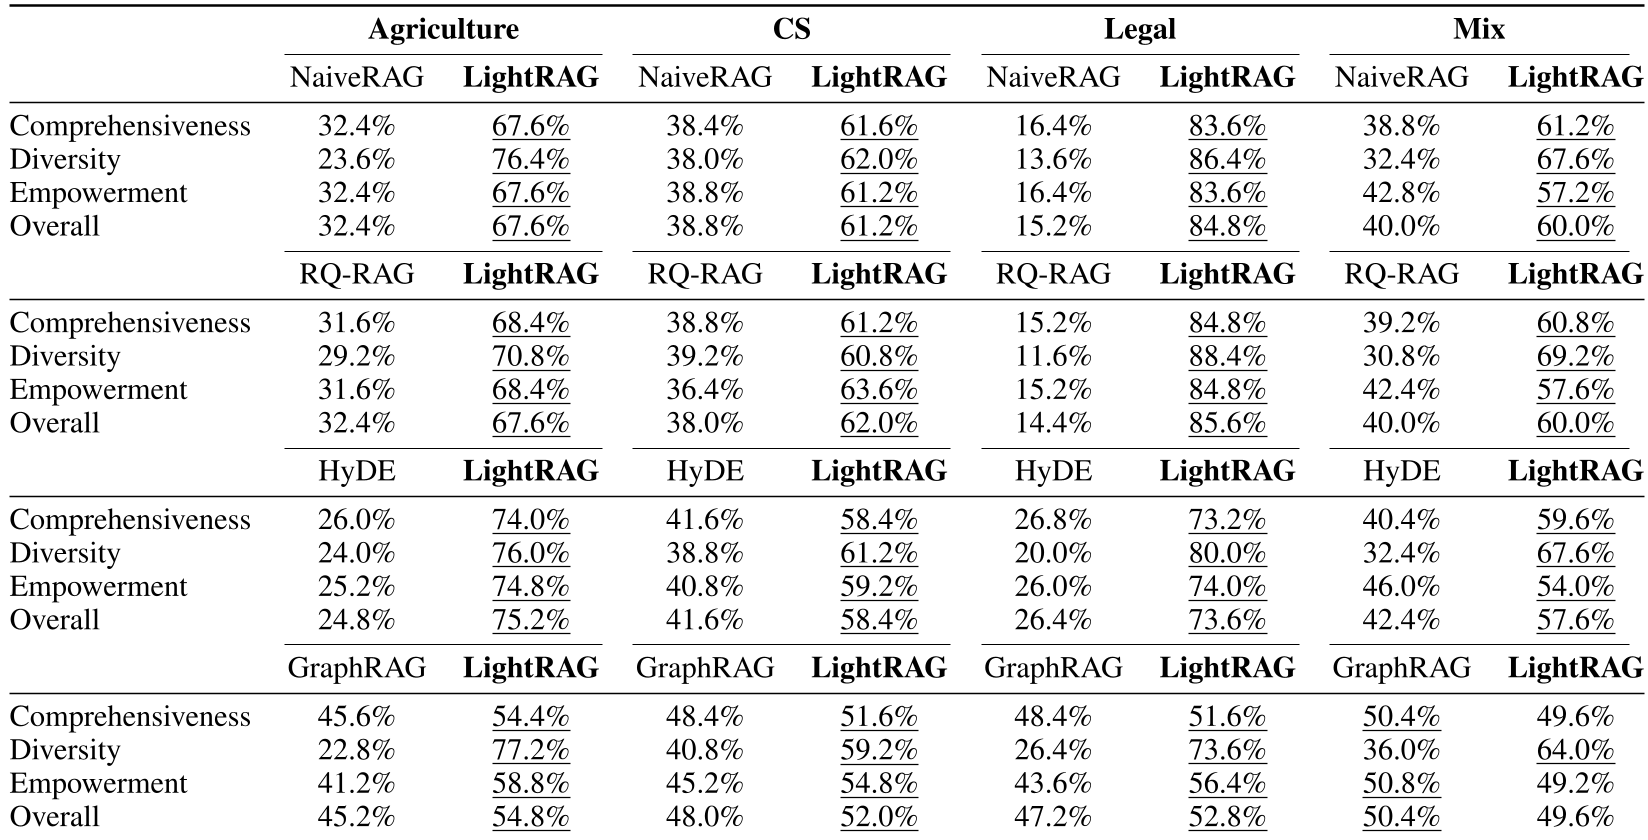
其中 是单次 API 调用允许的最大 token 数, 是抽取阶段所需 API 数, 是实体和关系抽取的 token 开销。Table 1 的原始截图展示多个基线在四个数据集上的胜率对比。
实验与证据:端到端胜率有效,但机制证据仍需补强
主结果来自 Table 1。表中的数字是 LLM judge 比较两个答案后给出的 LightRAG 胜率,四个维度为 Comprehensiveness、Diversity、Empowerment、Overall。下面选取 Overall 维度:
Table 1 报告了 LightRAG 在 Overall 维度对四个基线的胜率:
| 基线 | Agriculture | CS | Legal | Mix |
|---|---|---|---|---|
| NaiveRAG | 67.6 | 61.2 | 84.8 | 60.0 |
| RQ-RAG | 67.6 | 62.0 | 85.6 | 60.0 |
| HyDE | 75.2 | 58.4 | 73.6 | 57.6 |
| GraphRAG | 54.8 | 52.0 | 52.8 | 49.6 |
Table 1 的结论需要分开看。第一,LightRAG 对三种非图方法的优势比较稳定,尤其在最大的 Legal 上,对 NaiveRAG、RQ-RAG、HyDE 的 Overall 胜率分别是 84.8%、85.6%、73.6%。这支持论文的核心主张:在大语料上,单纯 embedding top-k 或查询改写不足以恢复跨块关系,图索引确实能带来更完整的上下文。第二,LightRAG 对 GraphRAG 的优势并不夸张。Agriculture、CS、Legal 上它分别以 54.8%、52.0%、52.8% 略胜;但在 Mix 上反而以 49.6% 对 50.4% 低于 GraphRAG。这说明 dual-level retrieval 并不在所有语料上天然优于社区报告:Mix 语料只有 619,009 tokens,是四者中最小,GraphRAG 的社区摘要可能已经足够覆盖其主题结构,而 LightRAG 的图扩展收益被稀释。
消融实验来自 Table 2。论文分别构造 -High、-Low 和 -Origin 三个变体,并用 NaiveRAG 作为参照:
Table 2 报告了以 NaiveRAG 为参照时,各 LightRAG 变体在 Overall 维度的胜率:
| 变体 | Agriculture | CS | Legal | Mix |
|---|---|---|---|---|
| LightRAG | 67.6 | 61.2 | 84.8 | 60.0 |
| -High | 64.8 | 56.0 | 78.0 | 57.6 |
| -Low | 65.2 | 56.4 | 81.2 | 64.8 |
| -Origin | 74.4 | 60.8 | 84.4 | 55.6 |
这张表的信息比表面更微妙。-High 去掉高层检索,在所有数据集上的胜率都低于完整 LightRAG;-Low 去掉低层检索,在 Agriculture、CS、Legal 上低于完整模型,但在 Mix 上反而更高,说明在较小或主题较分散的语料上,高层关系的广度可能比实体深度更有用。-Origin 去掉原始文本后,在 Agriculture 上反而达到 74.4%,高于完整模型的 67.6%。论文把这解释为图索引已经抽取了足够关键信息,原文反而带来噪声。这个结果很值得注意,但也暴露了评测方法的局限:它只说明 LLM 生成答案的质量没有被原文噪声拖慢,并不说明实体关系抽取一定优于原始 chunk,更不说明复杂法律推理中遗漏原文不会造成事实错误。
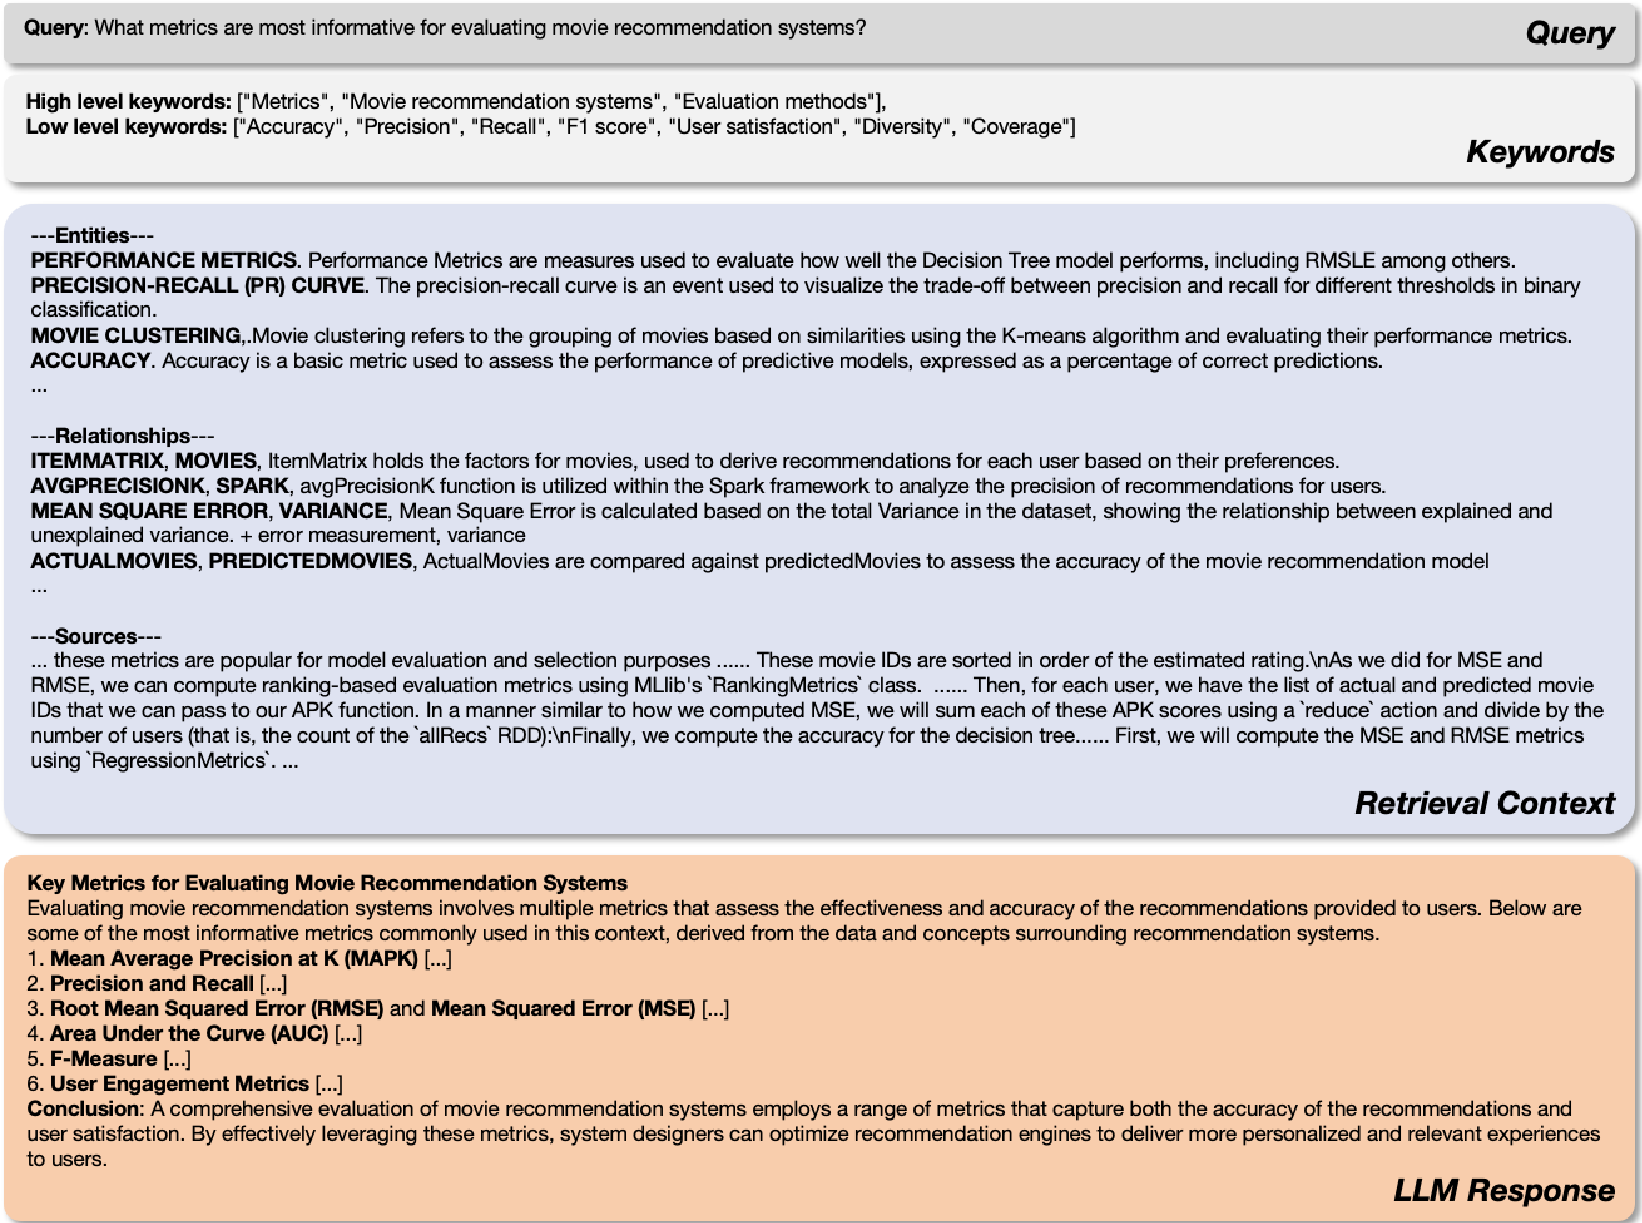
案例证据来自 Table 3 和附录 Table 5。Table 3 对比了一个机器学习推荐系统指标问题,LLM judge 在 Comprehensiveness、Diversity、Empowerment、Overall 四个维度都选择 LightRAG。附录 Table 5 对比了一个原住民视角与企业并购问题,LightRAG 同样在四个维度胜出。这些案例有助于解释为什么 LightRAG 更“全面”:它倾向于从实体、关系和主题词三个路径聚合内容。但案例也提醒读者,这里的“全面”是 LLM 判定后的表达全面,不是可验证事实覆盖率的提升。论文没有报告传统 IR 指标如 recall at k、precision at k,也没有报告检索到的图元素与 ground truth 的关系命中率。
证据质量评估需要谨慎。4.1 节说明每个数据集生成 125 个问题,来自 5 个用户、5 个任务和每组合 5 个问题。这个规模足以展示趋势,但不足以覆盖真实企业搜索中的长尾查询。实现细节上,所有 LLM 操作默认使用 GPT-4o-mini,chunk size 为 1200,gleaning 参数为 1。评测也使用 GPT-4o-mini 作为 judge。这使实验内部一致,但也带来潜在同模型偏好风险:生成模型和裁判模型同源,若它们在某些表达风格、列表结构或“丰富性”判断上共享偏好,win rate 可能高估真实用户效用。论文通过交替答案位置来降低顺序偏差,这是必要控制,但仍不能消除同模型 judge 的结构性问题。
深度洞察与总结
LightRAG 的真正价值在于它对 Graph RAG 成本结构的重分配。GraphRAG 把昂贵计算放在离线阶段:社区发现、社区报告、全局摘要;LightRAG 则把昂贵计算压回文本块抽取阶段,并用在线时的向量匹配和一跳图扩展恢复全局性。两者不是简单优劣关系,而是不同约束下的选择。GraphRAG 更适合需要稳定摘要、可人工审阅、且语料更新频率较低的场景;LightRAG 更适合查询频繁、文档增量明显、又希望避免全局重建的场景。
论文的局限性同样具体。第一,核心评测依赖 LLM judge 和 Overall win rate,没有独立检索指标,因此无法判断提升来自召回更多有效图元素,还是生成上下文更适合 LLM 阅读。第二,成本表只在 Legal 数据集上给出,且 4.5 节只比较了 GraphRAG,没有比较不同 chunk 数、不同实体密度或不同并发查询规模下的成本。第三,-Origin 变体在 Agriculture 上优于完整模型,说明原文上下文并非始终有用;这反过来提示,图抽取和 profiling 的质量是系统上限,论文没有给出抽取错误的量化边界。第四,增量更新公式只描述节点边并集,未详细处理合并冲突、实体消歧失败、关系过期和权重漂移。对动态知识库而言,这些不是附录级细节,而是决定长期可信度的机制。
未来更有技术含量的方向不是“扩展到更多领域”,而是把 LightRAG 的每个接口单独审计。例如,可以建立 entity retrieval recall 和 relation retrieval recall,分别测量低层与高层关键词命中的准确率;可以比较不同 LLM 作为 generator 和 judge 时的 win rate 稳定性;可以在动态更新中加入实体冲突解决和边失效机制;还可以把 key value 索引进一步拆分为事实型、主题型、因果型三类,以解释为何某些抽象查询受益明显而另一些则不明显。LightRAG 给出了一个清晰工程路径:图结构不必总被写成大段社区报告,它可以变成短 key、向量索引和查询时扩展。下一步的问题是,这种短 key 是否足够可靠,以及它什么时候会在真实知识生产中变得危险。