
轻量级 RAG + LLM:打破医疗临床试验匹配的“扩展性瓶颈”
Lightweight Retrieval-Augmented Generation and Large Language Model-Based Modeling for Scalable Patient-Trial Matching
本文提出了一个轻量级检索增强生成 (RAG) 框架,用于解决患者与临床试验的匹配问题。该框架结合了本地部署的开源大语言模型 (LLMs) 和降维技术,在多模态电子健康记录 (EHR) 处理中实现了与闭源巨量模型相当的性能。
TL;DR
临床试验招募中,患者与试验准入标准的匹配(Patient–Trial Matching)一直是个“体力活”。Mayo Clinic 的研究团队提出了一种轻量级框架,通过 RAG 筛选关键信息 + 开源 LLM 提取表征 + 智慧降维,仅需本地算力即可在处理数千 token 的复杂电子健康记录(EHR)时,达到甚至超越 GPT-4 的匹配精度。
痛点深挖:为何临床匹配如此之难?
在真实场景中,一名患者的病历可能长达几千页,包含结构化的化验单和非结构化的医生手记。
- 高昂成本:直接将全部病历喂给 LLM 会消耗大量 Token。
- 噪声干扰:冗长的历史记录中,真正符合筛选指标的可能只有几句话。
- 隐私焦虑:医疗数据极其敏感,通过 API 发送给闭源模型存在合规风险。
核心方法论:RAG 与 DimRed 的“降维打击”
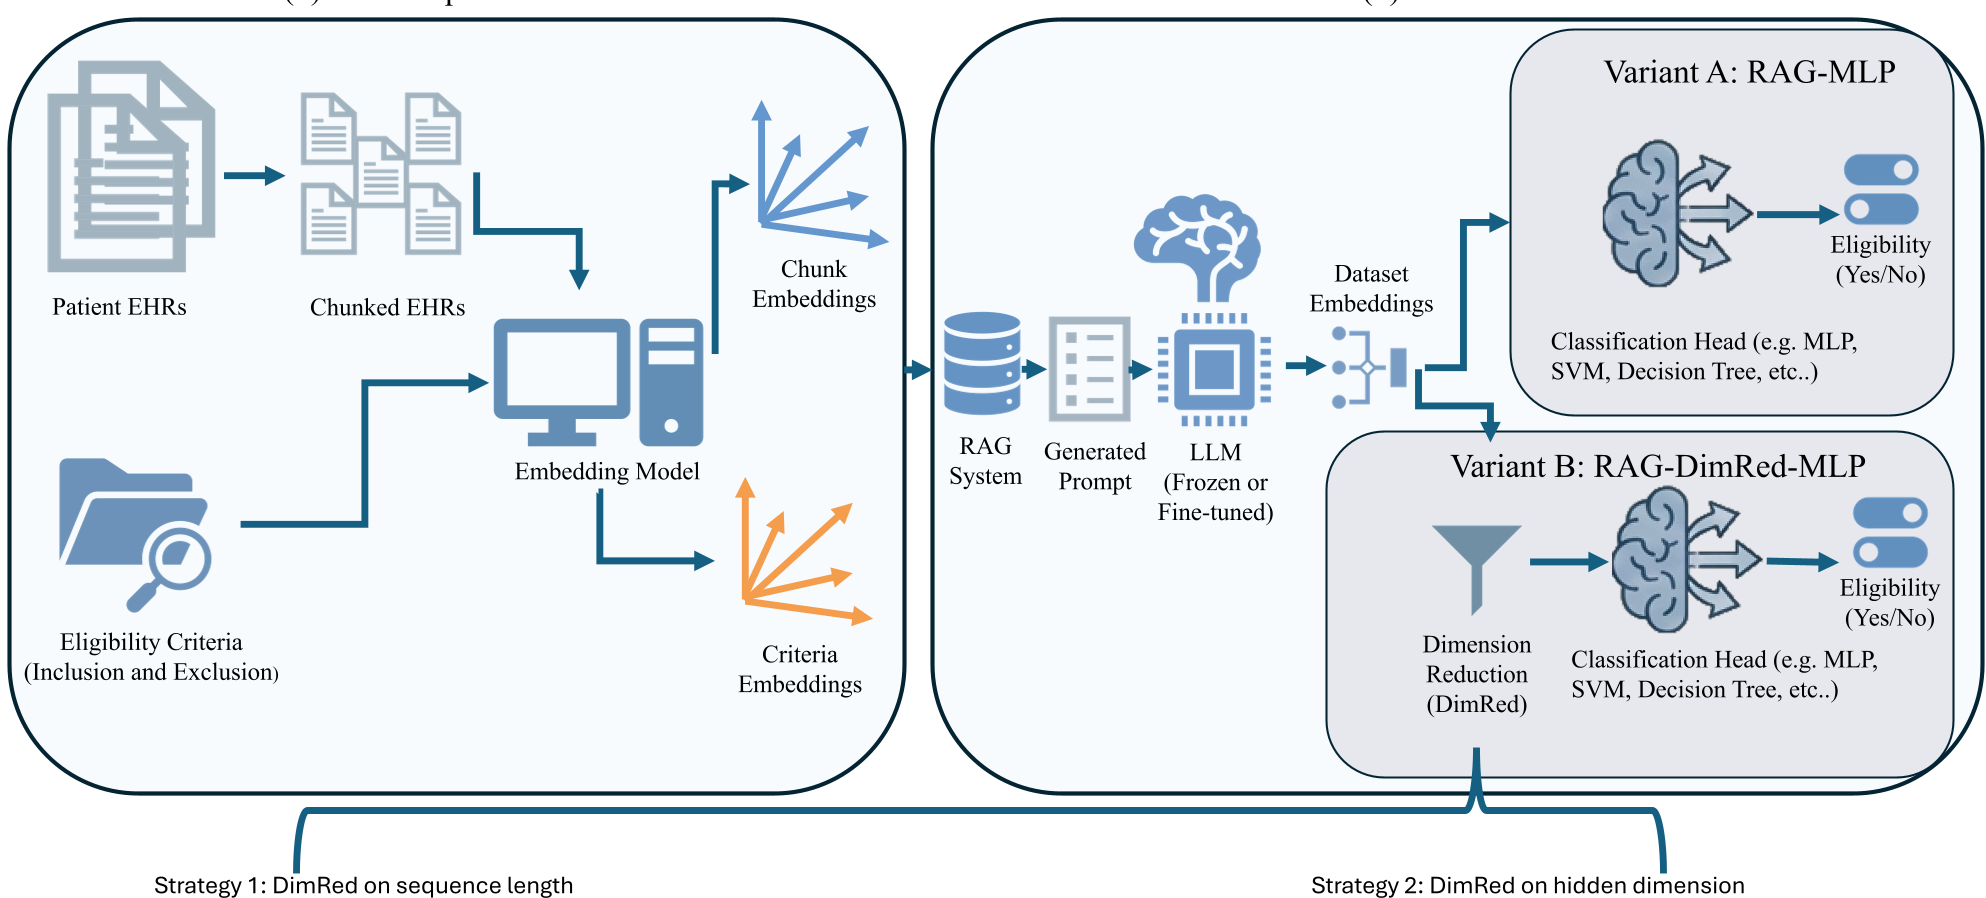
作者并没有采用昂贵的端到端全序列建模,而是设计了一个精巧的流水线:
1. 语义检索 (RAG Module)
利用 BioBERT 等医学专用 Embedding 模型,计算病历文本块与试验准入标准(Eligibility Criteria)的余弦相似度,剔除 90% 以上的无关信息。
2. 表征学习与降维 (Representation & DimRed)
系统将筛选后的文本输入到 Mistral-7B 或 Falcon-7B 等模型中。关键创新在于降维策略:
- 序列聚合:在 Token 维度进行降维(DimRed on Sequence Length),将长序列信息压缩为紧凑的患者特征向量。
- 隐藏层压缩:针对隐藏状态进行降维,保留最关键的预测信号。
实验战果:微调是解锁性能的钥匙
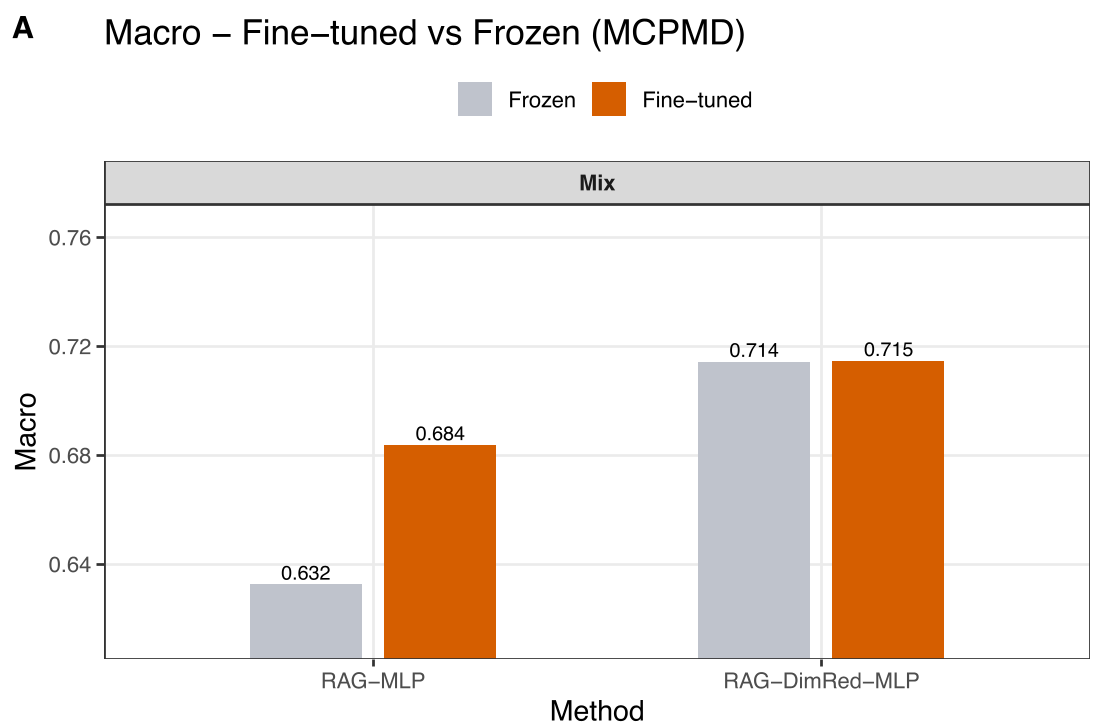
实验在 Mayo Clinic 的真实多模态数据集 (MCPMD) 上展开,结论非常清晰:
- Frozen vs. Fine-tuned:对于结构化数据,预训练模型的 Inductive Bias 尚可胜任;但对于非结构化笔记,微调(Fine-tuning)是达到 SOTA 的必要条件(Macro-F1 得到显著提升)。
- 降维的有效性:Task 3 结果显示,在序列维度进行降维比单纯提取
[CLS]向量或 Last Token 更能稳定保留临床信号。
深度洞察:跨试验泛化的“深水区”
在 Task 6 (Cross-Trial Generalization) 中,作者揭示了一个残酷的现实:当模型面对完全没见过的临床试验(0% 训练样本)时,性能会大幅滑坡。
这说明:现在的 AI 匹配模型依然高度依赖于特定试验的语言分布和协议逻辑。 真正的“通用匹配器”还需要在训练数据中覆盖更广泛、更异质的试验设计。
总结与未来展望
本文提出的 RAG + 轻量级 LLM + 合理降维的组合,为医疗 AI 提供了一个隐私保护 + 经济高效的范式。
启示:不要盲目追求大模型。通过 RAG 进行“信息减负”,比单纯增加上下文窗口长度更符合临床实践的 ROI。
局限性:目前的匹配依然停留在标签层面,尚未模拟真实的医生决策过程(如 site capacity 等运营约束),这预示着下一步的研究方向将是个性化的决策支持(Decision Support)。