
StateKV:突破长视频理解的二次方计算屏障
Linear Scaling Video VLMs for Long Video Understanding
本文提出了 StateKV,一种针对长视频多模态模型(Video VLMs)的推理时优化方法。该方法通过引入基于重要性的固定容量递归状态,将视频预填充阶段的计算复杂度从二次方降至线性,同时在解码阶段保留全量细粒度特征,在多个长视频基准测试中达到了接近全自注意力的 SOTA 性能。
TL;DR
斯坦福大学的研究团队推出了 StateKV,这是一种创新的长视频推理加速策略。它通过一种“双缓存”机制,巧妙地将视频预填充(Prefill)阶段的复杂度从 O(N²) 降至 O(N),且无需任何模型微调。这意味着我们处理 1 小时的视频将不再比处理 1 分钟的视频面临更陡峭的算力增长。
核心速览
在长视频理解领域,传统的 Self-attention 机制是一把双刃剑:它赋予了模型全局视野,但也带来了灾难性的计算开销——随着帧数增加,每增加一帧所需的计算量呈线性增长,总计算量呈二次方爆炸。现有的滑动窗口(ReKV)等方法虽然快,但往往因为“近视”而丢掉了视频开头的关键线索。
StateKV 的定位:它是长视频 VLM 的“计算助推器”,在保持高性能的同时,实现了真正的线性扩展性。
痛点深挖:为什么长视频这么难?
现有的主流优化手段主要有两类,但各有各的痛点:
- Token/Frame Dropping:简单粗暴地丢弃 Token,但这往往会破坏空间结构或动作连贯性,导致长程推理(Long-horizon reasoning)失败。
- Recency-based Window (如 ReKV):预设了一个假设——最近的帧最重要。但在视频问答中,关键线索往往埋藏在视频开头或中间的某个特定瞬间。
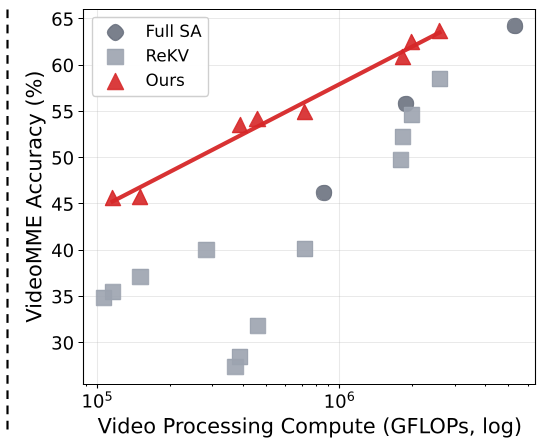 图 1:左侧显示 StateKV 实现了线性预填充开销;右侧显示其在固定计算预算下达到了更高的准确率。
方法论详解:双缓存与时间锚点 (Temporal Sinks)
StateKV 的核心设计哲学是 “预填充时压缩,生成时保留”。
1. 物理直觉:时间锚点
作者通过实验发现,VLM 在处理视频时,注意力并不是平铺的,而是集中在极少数关键 Token 上。这些 Token 就像是视频流中的“锚点”,承载了大部分跨帧交互的权重。
2. 架构解析
StateKV 为每一层 Transformer 维护了两个状态:
- cstate (Compressed State):这是一个固定容量(如 4096 个 Token)的缓冲区。它只在预填充阶段工作,通过动态更新策略,确保每一帧都能看到之前最重要的“历史遗迹”。
- dstate (Detailed State):它默默记录下每一帧的所有细节。当视频处理完,进入最后的文本生成环节时,模型会调取这些全量细节进行精准回答。
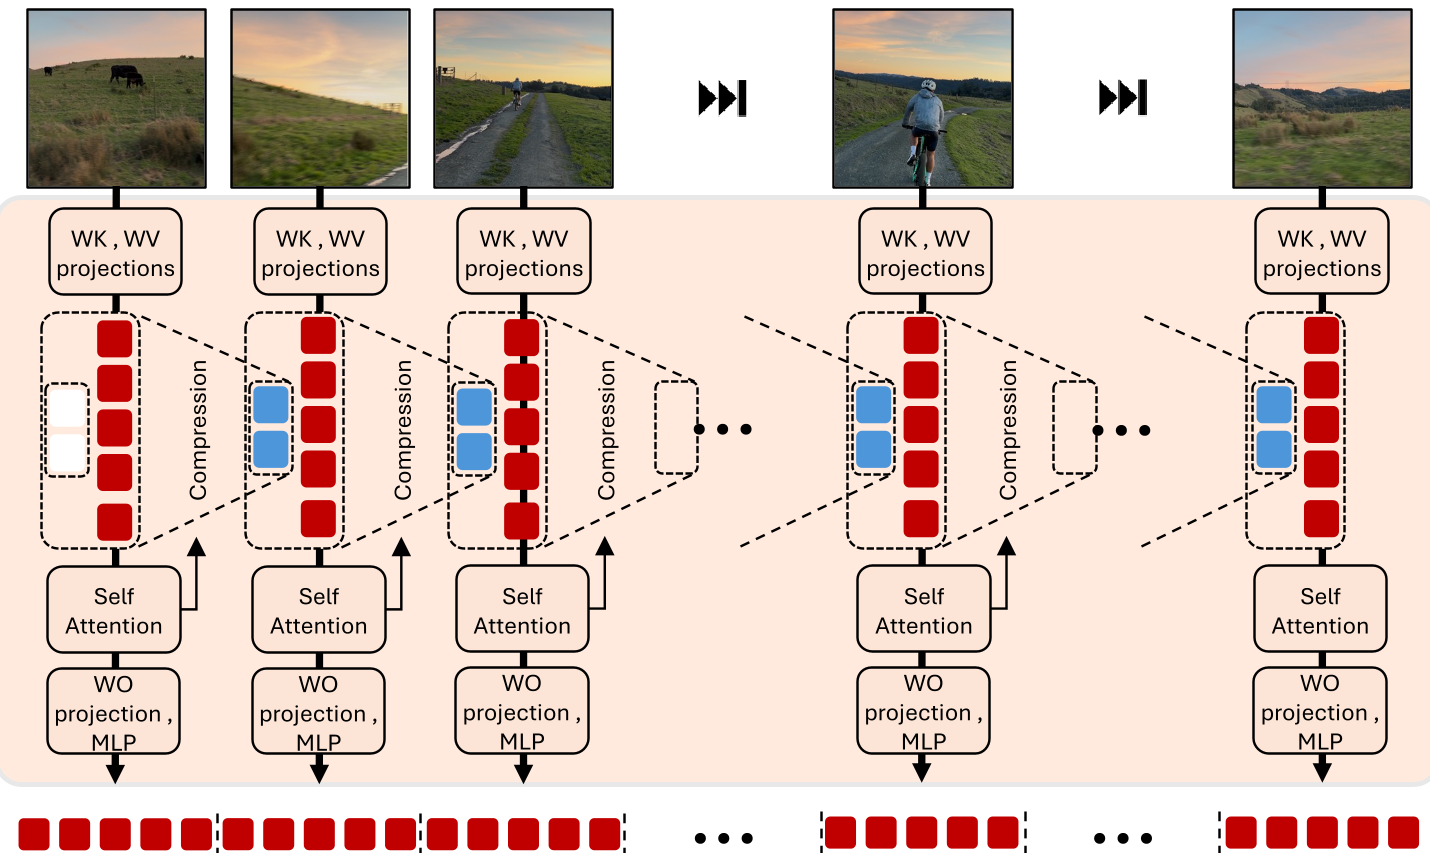 图 2:StateKV 通过重要性分数动态筛选历史 Token 进入压缩缓存。
实验与结果:算力换规模的“炼金术”
StateKV 带来的最大变革在于:由于单次推理省下了大量算的力,你可以把这些算力投资到更大的模型上。
在实验中,使用 StateKV 运行的 InternVL3-8B 模型,其计算成本甚至低于运行全注意力的 1B 版本,但准确率却从 46.2% 飙升至 62.5%。
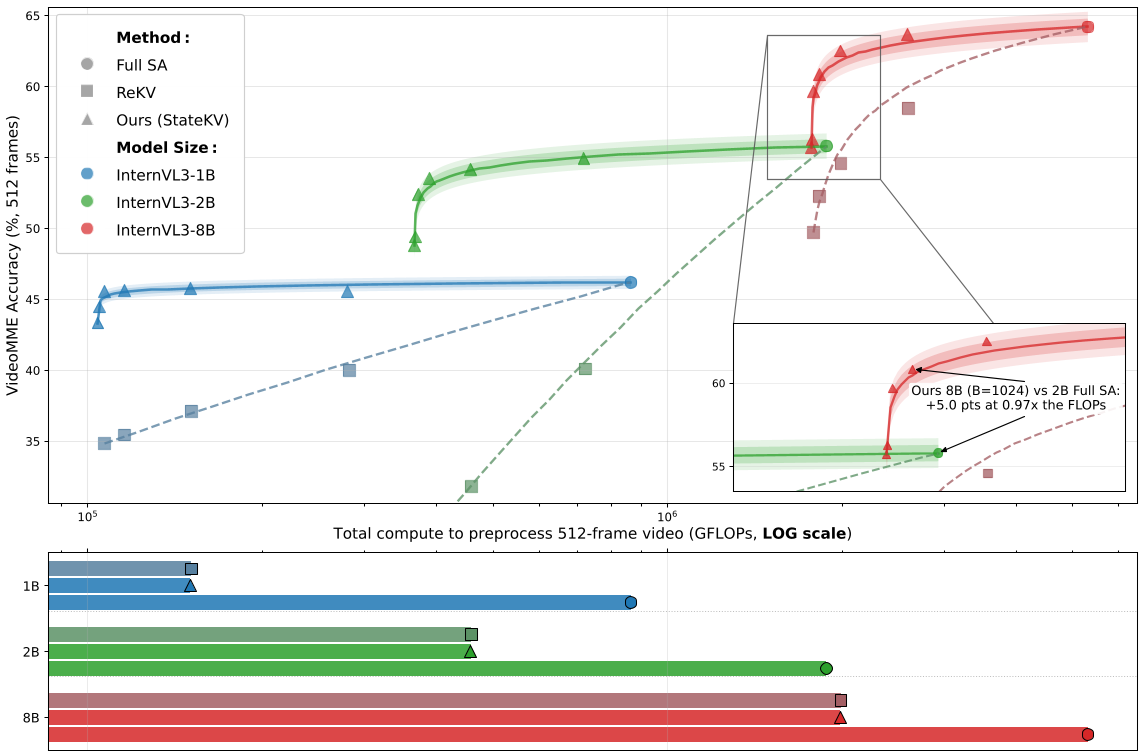 图 3:在 VideoMME 指标上,StateKV(三角形)不仅超越了滑动窗口法,且紧贴全注意力基准。
关键发现:
- 稳健性:在三类不同家族(InternVL3, Qwen3-VL, Eagle2.5)的模型上表现一致,证明其具备跨架构的普适性。
- 线性扩展:即使视频长度达到 3600 帧(一小时长度),其每帧增量开销依然保持恒定,而传统方法早已宕机。
深度洞察:未来的启示
StateKV 的成功揭示了一个重要的业界趋势:针对特定模态(如视频)的注意力结构化特性进行针对性优化,比通用的 Token 剪枝更有潜力。
局限性:目前该方法依赖于模型本身表现出的这种“重要性集中”特性。对于某些并未经过良好视频适应训练的模型,其“时间锚点”可能不够清晰,从而限制了效果。
总结 (Takeaway):StateKV 将“长视频理解”从理论可行推向了工程实用。它告诉我们,通过聪明的缓存管理,我们可以在不牺牲精度的前提下,让 8B 规模的模型跑出 1B 的速度,这正是通往实时流式 AI 理解的必经之路。