
LiveResearchBench:从“信息搬运工”走向“深度研究者”的终极测试
LiveResearchBench: A Live Benchmark for User-Centric Deep Research in the Wild
本文推出了 LiveResearchBench,一个包含 100 个由专家策展、面向真实复杂需求的“深度研究(Deep Research)”基准测试集。配套提出的 DeepEval 评审框架从六个维度(覆盖度、深入度、事实一致性、引文准确性等)对长篇研究报告进行严格评估,并揭示了当前 SOTA 模型在分析深度和引文合规性上的巨大短板。
TL;DR
在 OpenAI o3、Manus 等 Deep Research 系统层出不穷的今天,我们如何判断一份 AI 生成的 5000 字报告是真知灼见还是辞藻堆砌?来自 Salesforce、斯坦福等机构的研究者发布了 LiveResearchBench。这不仅是一个包含 100 个复杂、动态、多维度任务的基准,更是一套名为 DeepEval 的“严苛考卷”,旨在戳破 AI 在长篇报告撰写中的“引文幻觉”与“分析肤浅”的泡沫。
背景定位:基准测试的“危机”
当前的 AI Agent 评估面临一场信任危机。现有的 Benchmarks 要么是静态的(模型可能通过预训练见过答案),要么是模糊的(任务没说给谁看,也没说写多深)。这种评估环境下,模型往往通过增加报告长度来“刷分”,而忽略了真实研究中最核心的两个能力:时效性搜索与逻辑严密的证据合成。
痛点分析:为什么现有的 AI 只是“搜索增强器”?
作者指出,目前的 SOTA 模型在处理“深度研究”任务时存在三大软肋:
- 逻辑漂移:随着报告变长,前后事实冲突概率指数级上升。
- 引文崩坏:引文格式混乱、文不对题(E3 错误)、甚至伪造链接。
- 深度匮乏:模型擅长罗列搜到的事实,但极少能进行因果推断、权衡分析或给出高密度的行业洞察。
核心方法论:DeepEval 的六脉神剑
为了彻底量化这些问题,研究团队拒绝了粗暴的“单一打分制”,而是将 DeepEval 拆分为六个维度,每个维度配备最适合的评估协议(Protocol):
- Presentation (Checklist):检查 10 项格式硬指标(表格是否坏随、引文是否一一对应)。
- Factual Consistency (Pointwise):对逻辑漏洞进行累加扣分。
- Coverage (Expert Checklist):对照专家预设的 unit tests,检查关键信息点是否全部覆盖。
- Analysis Depth (Pairwise):通过两个模型报告的“肉搏”式对比,评估洞察密度。
- Citation Traceability:扫描每一处事实陈述是否都有对应出处。
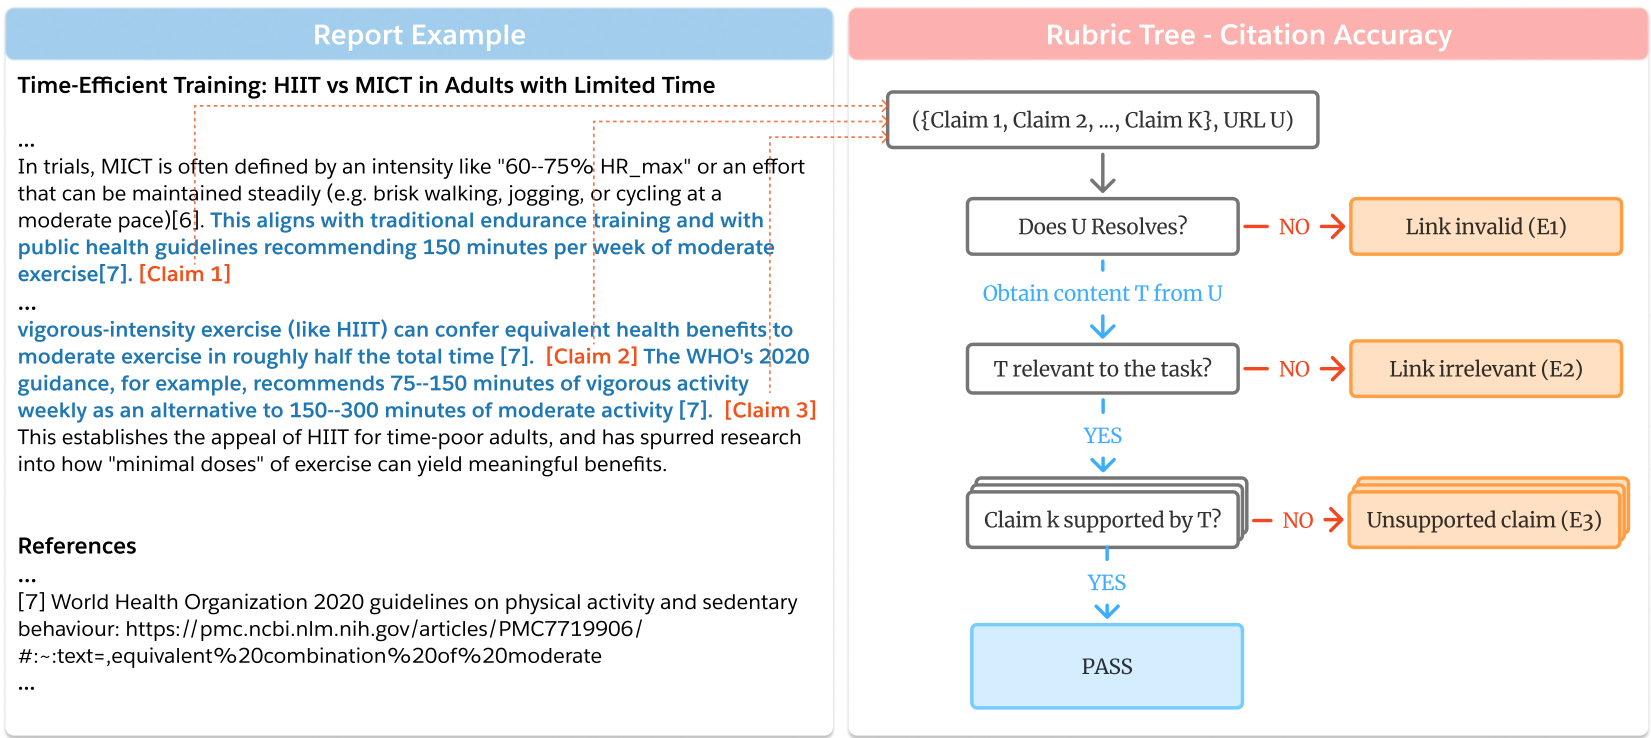
- Citation Accuracy (Rubric Tree):这是最硬核的部分,Agent 会亲自联网去点开链接,验证链接是否有效、内容是否真的支持 claims。
实验战绩:谁才是真正的 Deep Research 之王?
实验涵盖了 17 个主流系统,包括 GPT-5 (预研版本代称)、Gemini 2.5 Pro 以及 Manus 等开源/闭源智能体。
- MAS 的统治力:Multi-Agent 系统(如加强版的 Deerflow+)在引文关联度和展示质量上显著占优。这是因为它们有专门的“打字员”和“校对员”角色。
- 长不等于好:Gemini Deep Research 生成的报告最长,但长度增加并没有线性带来质量提升。
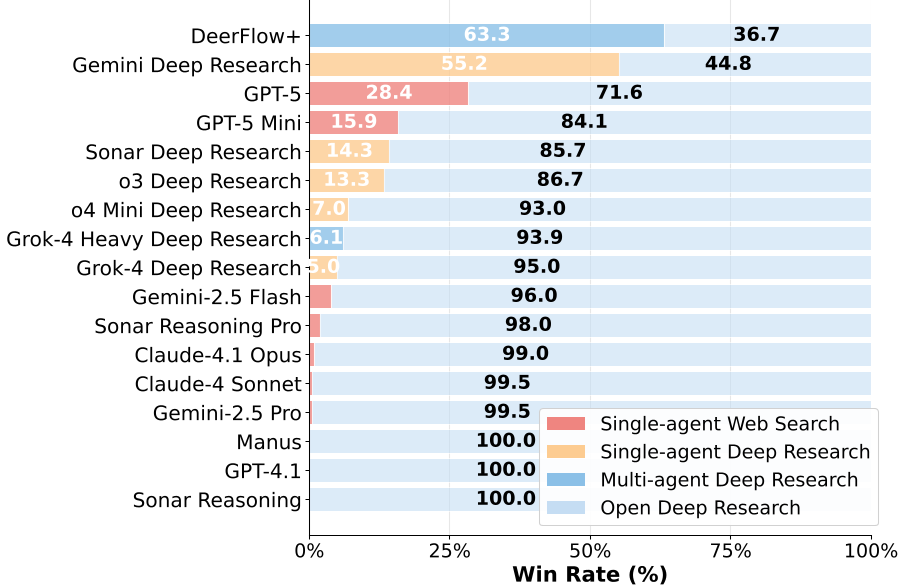
- 深度断崖:如下图所示,在 Analysis Depth 维度,绝大多数模型在与基准 Open Deep Research (ODR) 的正面对抗中都未能展现出明显的“智能优势”。
深度洞察:未来 Deep Research 的三道坎
论文在总结部分提出了一个引人深思的观点:目前的模型是 Deep Searchers 而非 Deep Researchers。要跨越这道鸿沟,未来系统必须解决以下挑战:
- 长程记忆管理(Updateable Memory):不仅是堆算力,而是要学会在几千个搜索结果中进行“动态更新”。
- 层次化信息压缩:在不丢失核心证据的前提下,将海量网页压缩成高维洞察。
- 受众感知(Audience-aware):研究报告必须知道是写给“本科生”还是“CIO”看,而不仅仅是事实的无差别堆砌。
结论
LiveResearchBench 的发布为 Agentic System 划下了一道新的及格线。它告诉我们,AI 智能的真谛不在于它能从互联网上搬运多少字节,而在于它能从纷繁复杂、甚至充满冲突的实时信息中,提炼出多少能指导决策的“真实价值”。