
LLM-as-a-Coach:突破标量奖励瓶颈,以“体验学习”重塑模型对齐
LLM-as-a-Coach: Experiential Learning for Non-Verifiable Tasks
本文提出了 Experiential Learning (EL),一种针对 LLM 后训练阶段非验证性任务的全新框架。该方法将 LLM-as-a-Judge 角色转变为 LLM-as-a-Coach,通过提取可迁移的“体验知识(Experiential Knowledge)”而非简单的标量分数来引导策略模型优化,在多项开放式任务基准测试中超越了传统的 RL 方法。
TL;DR
传统的强化学习(RL)在对齐 LLM 时面临一个“窄门”:无论评价模型(Judge)有多少独到的见解,最后都必须压缩成一个冰冷的数字分数。微软研究院提出的 Experiential Learning (EL) 框架通过将 Judge 升级为 Coach(教练),通过提取高带宽的文本化“体验知识”替代标量奖励,通过蒸馏技术让模型学习“如何做得更好”而不仅仅是“如何拿高分”。
1. 痛点:被浪费的“金玉良言”
在处理数学题等验证性任务(Verifiable Tasks)时,对错是二元的,标量奖励(0 或 1)非常高效。但在开放式写作、分析或建议任务中,回答的质量是多维度的(如:逻辑严密性、语气、组织结构)。
目前的 RL 方法(如 PPO, GRPO)使用 LLM-as-a-Judge:
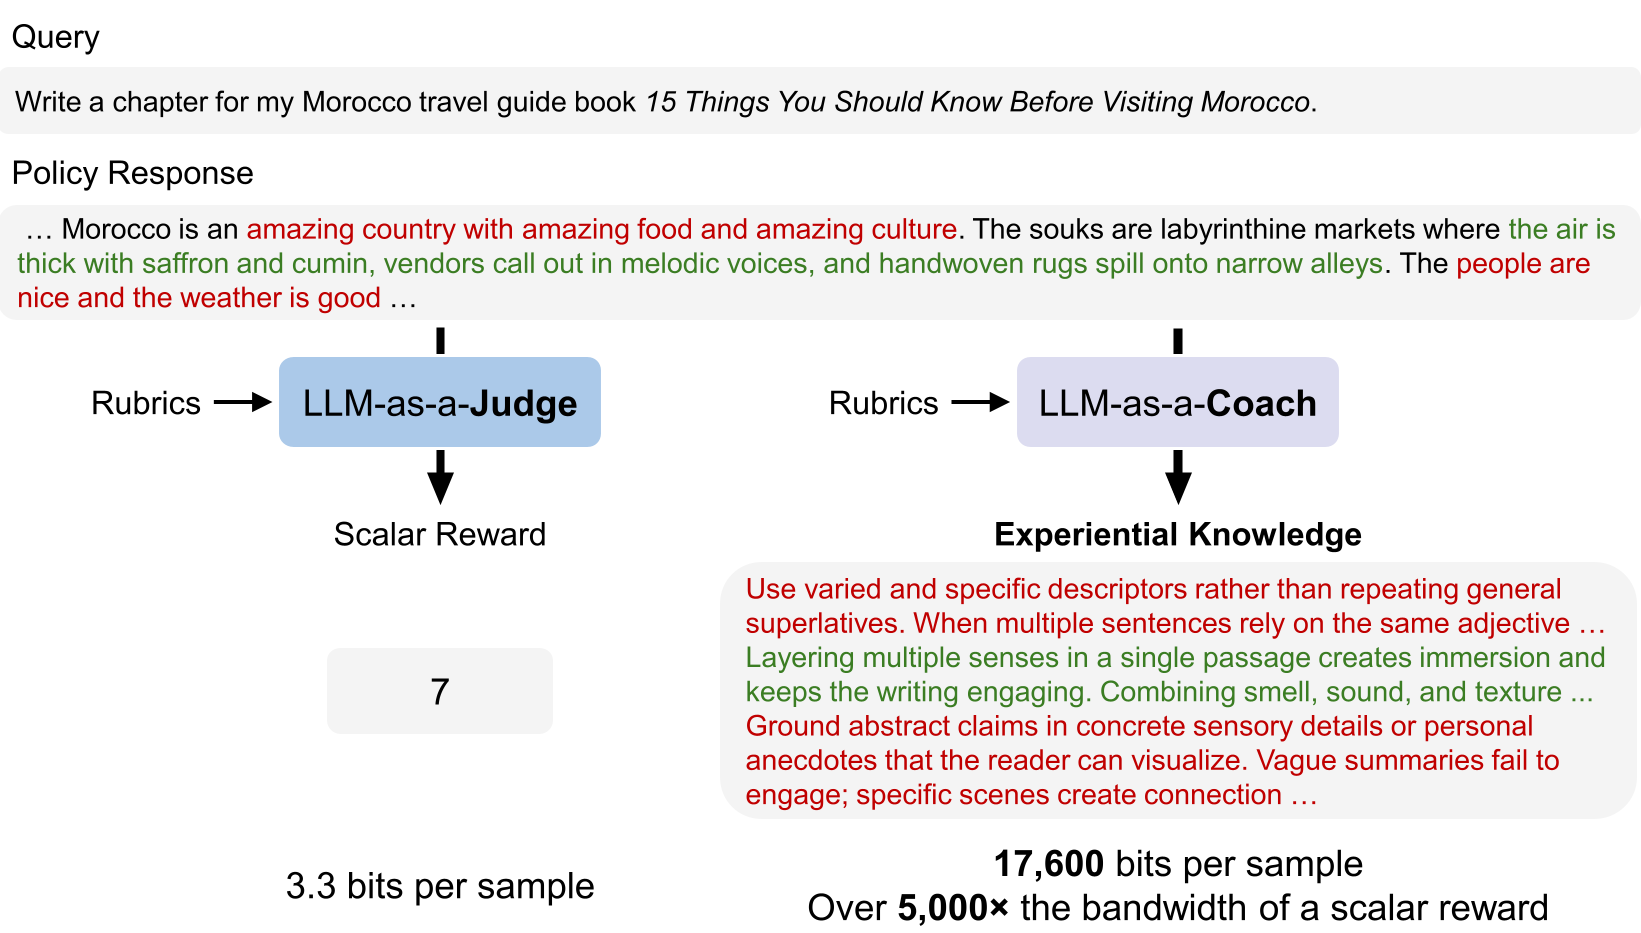
- 信息瓶颈:1-10 分的评价最多只有约 3.3 bits 的信息量,而几百字的文本反馈蕴含上万 bits 的信息。
- 高分盲区:当多个回答都达到 10 分时,RL 无法在这些“同样优秀但侧重不同”的样本间进一步优化。
- Reward Hacking:模型会发现某些特定格式或词汇能讨好评测机拿高分,导致模型行为退化。
2. 核心机制:从“评判者”到“教练员”
EL 的核心在于将反馈链路从“分数驱动”改为“知识驱动”。
2.1 体验知识(Experiential Knowledge)的提取
不同于简单的纠错,LLM-as-a-Coach 会总结出可迁移的经验。例如,如果策略模型写了一段冗长的代码,教练不会只说“代码太长”,而是提炼出:“在处理此类递归逻辑时,优先考虑使用生成器表达式以提高内存效率。”
2.2 在线上下文蒸馏 (On-policy Context Distillation)
如何让模型吸收这些文字建议?EL 并不是简单的 SFT,其流程如下:
- 采样:Policy 产生回复。
- 辅导:Coach 结合回复和准则(Rubrics)生成体验知识 。
- 引导:将 作为输入注入到一个固定或迭代的 Teacher 模型中。
- 内化:通过最小化 Policy 分布与 Teacher(在 提示下)分布之间的逆 KL 散度,将这些知识“固化”到 Policy 参数里。

3. 实验结果:全方位的跨越
实验在 Qwen3 和 OLMo 两个模型家族上展开,使用了包括 AlpacaEval 和 ArenaHard 在内的多个权威榜单。
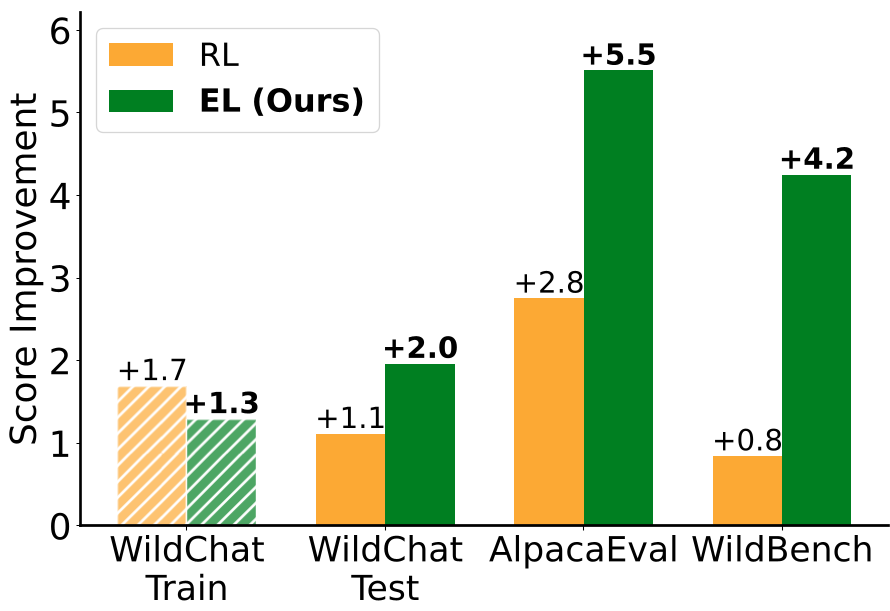
- 性能提升:EL 在几乎所有 OOD(分布外)测试集上均优于基于 Rubric 的 RL 基线。
- 泛化之王:如图 3 所示,虽然 RL 在训练集上的得分刷得很高,但其测试集得分却提升乏力;相比之下,EL 展示了极强的知识迁移能力,模型学到的是“方法论”而非“答案”。
4. 深度洞察:为什么 EL 更有效?
作者提供了一个非常直观的**反馈带宽(Feedback Bandwidth)**解释:
- RL (标量):就像是老师只在你的卷子上写个“80分”。
- EL (文本):就像是老师逐行批注,并告诉你“下篇文章应该注意排比句的使用”。
在受控的分步建模实验(Figure 4)中,研究者发现:对于非验证任务的复杂目标分布,标量奖励由于只能阶梯式地拟合(Quantization Artifacts),会导致概率分布的扭曲;而 EL 这种 Distribution-matching 的方式能完美恢复复杂的、多模态的目标分布。
5. 局限与未来
尽管 EL 表现卓越,但其依赖于 Coach 生成高质量知识的能力。如果 Coach 本身存在偏见,EL 可能会更迅速地将这些偏见内化。未来的研究方向包括如何实现 Coach 与 Policy 的双重迭代进化,以及如何进一步压缩反馈长度以降低训练成本。
总结
Experiential Learning 标志着 LLM 对齐技术从“结果导向”向“过程导向”的重大转变。通过打破标量奖励的带宽约束,我们终于可以让模型像人类一样,从每一次失败或成功的尝试中,总结出能够举一反三的真知灼见。